Tableauアナリティクスペイン完全攻略 #2.5 Beyond the Tableau Usage
エクスチュアのシガです。高校生の弟が制服のポケットからこぼした100円玉の音につい反応してしまい、大変みじめな気持ちになりました。ボスからは十二分なお給料をいただいているので、入社3か月目はたいへん申し訳ない気持ちでいっぱいです。
今回は、これまでの2本の記事からこぼれ落ちた小銭のような知識を拾い集める回です。よかったらこれまでの2本の記事を読んでからご覧ください。記述統計と箱ひげ図についてまとめた記事と、信頼区間についてまとめた記事とが、すでに公開されています。
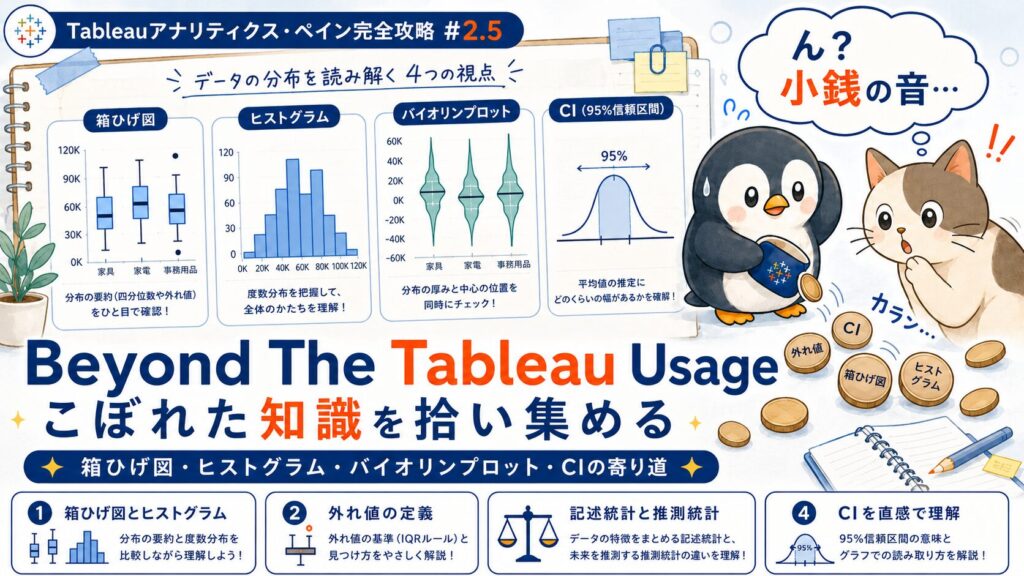
このシリーズでは、Tableauのアナリティクス・ペインにある機能について、「職人芸なしで」「しかしなるべく正確に」使うための基礎を説明してきました。それぞれどのような統計モデルを可視化しているのか、どのようにその分析を理解し言葉に直せばいいのかといった具合です。一方で、記事を書いていると、どうしても本筋から外れてしまう話がいくつも出てきます。どれも個別の記事の本筋に入れるには少し重い話です。しかし、Tableauが表示しているものを「なんとなくそれっぽい図」としてではなく、分析結果として読み、より一層深い分析を検討するために知っておいてもらってもよい話ばかりだと思います。そこで今回は、これまでの2本の記事を書くなかで考え、書き、そして削ってきたAppendix的な知識をまとめます。「Tableauでできること」そのものからは半歩それますが、関心のあるものだけでも、Tableauをもう一歩正確に読むための補助線として読んでいただければ幸いです。
目次[非表示]
LLMを使えば、RやPythonを使って、それこそTableauよりも美しく、複雑なグラフを誰もが作ることができる時代です。だからこそ、Tableauの価値は「グラフを作れること」だけではなく、「どのような集計やモデルを、どのような前提で、どこまで安全に使えるのか」という、すべての人が共通で認識できる正確さの限度を分析者が把握しながら可視化できることにあると思います。アナリティクス・ペインは便利です。しかし、便利なボタンは、ときどき儀式になります。
この折り返し回では、その儀式を少しだけ分析に戻すための知識を拾っていきます。
箱ひげ図とヒストグラム、解決策としてのバイオリンプロット
このセクションでは、四分位数を可視化するモデルである「箱ひげ図」と、箱ひげ図の拡張先のひとつである「バイオリンプロット」について解説を行います。箱ひげ図が「分布の密度」というとても重要な情報を失うという弱みを確認し、その弱みを克服した「バイオリンプロット」について解説をします。
まず、以下の箱ひげ図を見てみてください。これは、かの有名なirisデータセットから、3つの品種ごとにそれぞれの花弁の長さの分布を可視化したものです。横軸には、品種名、縦軸には、実際の観測値が入っています。
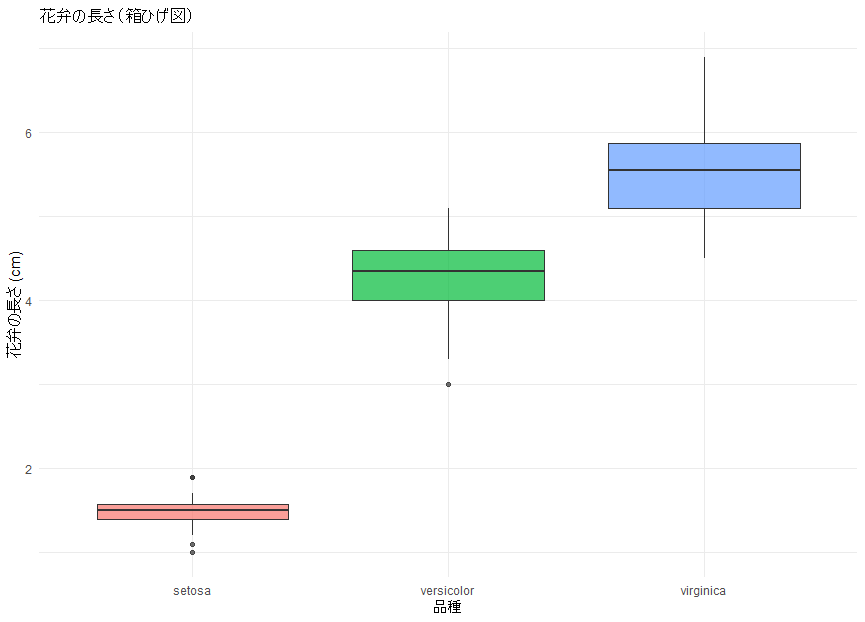
箱ひげ図の強みと弱みは、同様に変数の分布を可視化するヒストグラムと比較するととても明快になります。箱ひげ図一番の強みはカテゴリ間の比較を直感的に把握できることです。同じ2次元平面上に複数の変数の分布を同じ尺度で、重なりを作らず可視化することができます。一方で、明確な弱みとして、同じ値をとる観測がどれだけあるのか、密度情報を完全に失ってしまうことが挙げられます。先述の最頻値/中央値の使い分けが難しくなってしまうのです。

そんな箱ひげ図(あるいはヒストグラム)の弱点をどちらも克服する画期的なプロットモデルが、バイオリンプロットです。バイオリンプロットとは、ヒストグラムが示す「どこに実測値が集中しているのか」という分布の情報を箱ひげ図に付け足したもの(厳密にはデータの分布をカーネル密度推定で可視化したもの)です。ヒストグラムが持つ観測値の密度を、横幅で表現します。この中に、箱ひげ図を無理くり突っ込むようなーいわば改造バイオリンプロットーも存在します。
なお、バイオリンプロットをTableauで作ることはどうやら可能ではあるようです。今回筆者は無精をするためにRを使いました。Tableauで表現するにはこちらなどが参考になるでしょう。再現にチャレンジする価値はあるとは思いますが、今回は省きます。今回は、よく「中央値は外れ値の影響を受けない」という理解にプラスαして、最頻値という概念を引き合いに出すことでその限界を示すことを目的にバイオリンプロットをご紹介しました。


箱ひげの上端と下端、外れ値の定義
箱ひげ図のヒゲの両端の定義は一意ではありません。たとえば高校数学の定番教材であるチャート式(チャート研究所, 2015, p.254)では、ヒゲの両端は最小値・最大値として定義されています。一方で豊田(2017, p.78)は「箱ひげ図には様々な書き方のバリエーションがある」と明示しており、cの値を1.5とする流儀のほか、5%点と95%点までヒゲを引く流儀、外れ値を書かない流儀など、複数の慣習が並存しているとしています。なお、Tableauがデフォルトで作る箱ひげ図のヒゲは、この中でもc=1.5を採用しており、(Q1-1.5IQR)の値(あるいは最小値)と(Q3+1.5IQR)の値(あるいは最大値)を示します。
このIQRの1.5倍という数値が真の力を発揮するのは、手持ちのデータが正規分布に従っているときに限られます。どうして1.5IQRを基準にするのか、難しいお話は弊社のブログやこのような外部ブログなどが参考になります。長くなるので詳しくは話しませんが、直観的に話すと、この範囲の中にすべての観測値の99%が理論上分布しているはずだから、両端の極端な0.5%は無視してもいいでしょう、という考え方です。この除外ルールの根拠には、関心の変数が正規分布しているという強い仮定に支えられています。つまり、この除外ルールを採用するとき、仮定から、平均・中央値・最頻値が一致し、分布の対称性も保証されます。そのような性質の揃ったデータに対して、1.5IQRルールで両端を外れ値として切り捨てることは、せっかくの分布の情報を自ら削ることになります。正規分布の恩恵を受けられる状況で、わざわざその恩恵を損なう操作をする必要があるのか、という疑問がシガ的には残ります。
では実際その分布が正規分布に従わない場合はどのように可視化するのが示唆の多い結果を得られるかを考えてみます。ひとつ考えられるのは、Tableauの箱ひげ図を最小値・最大値表示に切り替えて5数要約(最小値・Q1・中央値・Q3・最大値)として使うことです。外れ値の判定を統計的ルールに委ねるのではなく、データの全体像を確実に把握することを優先する立場です。また、外れ値を見つけ出したいという意図ならば、ヒストグラムで分布を見るのもよいですが、もう一つ関連するだろう変数と組み合わせて散布図を作りクラスター分析を使うのもよいかもしれません。外れ値をルールベースで定義するのではなく、データの構造から帰納的に考えます。1.5IQRルールを疑うのであれば、外れ値の定義をデータに語らせる方向に切り替えるのは自然な選択肢です。
記述統計と推測統計の境界
私が今回参照のブログの執筆のために参照した教科書に以下のような記述がありました。そこでは度数分布表やヒストグラムはデータの要約に有用であるが手軽ではないということを指摘したうえで以下のように続きます。
「・・・そこでデータの特徴を要約的に記述するための数的な指標を利用する。データを独立変数と見たときの関数
統計量=f(データ)統計量=f(データ)
を一般に統計量(statistic)といい、特にデータの性質を縮約するための統計量を要約統計量(summary statistic)という。」(豊田2017, p13)
平たくかみ砕くと、標本のデータの特徴を捉えるために特定の方法論で計算された指標を「統計量」という、そのような指標の中でもデータを圧縮・集約するという目的に立ったものを「要約統計量」という、という定義です。この定義にのっとると、世の中の数多くの統計量が要約統計量としての地位を得る余地が生まれそうです。この定義の妥当性について少し考えています。結論を言うと、シガはこの定義がかなり気に入っています。なぜならば、統計を用いる目的意識は、突き詰めれば何かを何かの側面から理解したいという欲求に根差します。その目的のために実際我々が無視している情報量はたくさんありますが、これは俯瞰すれば「要約」をしていることと同義だと思えるからです。
ここで論点になるのは、豊田による定義が広いがゆえに、目的意識のない記述統計の確認が非科学的な推論の余地を残してしまうことです。例えば、標本平均を求めるという、誰もが疑わない作業にもリスクがあります。手元のデータの平均を確認する行為は、意識するかどうかにかかわらず、母集団の平均を点推定するのと同じ計算をしています。分析の目的意志によるな裏付けと明確な使い分けが必要なのです。「とりあえず平均を確認した」結果を推論の文脈に持ち込めば、さまざまな誤った解釈を統計的に補強する原因になりえます。だからこそ、何を要約しているのか・なぜこのモデルで要約するのかという目的意識が重要になります。記述統計を儀式にしてはいけない、のだと思うのです。
できることなら、英語を使いたい
「記述統計」とほぼ同義の言葉に「要約統計」(summary statistic)という言葉があります。今回、このブログを書くのに参照したテキストでは記述統計とする記述が多かったので記述統計としていますが、これは、僕の出自(主に政治学)では「記述統計」のほうがよく市民権を得ていたというだけの意味しかありません。ちなみに政治学領域でも、社会心理学によると要約という言葉が稀に出てくる印象です。大学院で死ぬほどお世話になった先生(その1)は方法論の授業で「統計用語は領域によって全く違う名前がついていたりする。これらをまとめた本があるとよい」とおっしゃっていました。また、死ぬほどお世話になった先生(その2)は統計の授業で「大学生以上は英語で統計を勉強するべきだ」といっていました。英語でも定まらない言葉ですが、それを日本語に直すと、あまり直観的でない訳語が与えられるだけではなく、もとの言葉と1:1の役にならないリスクもあります。(LLMによる翻訳のみならず、研究者による訳本でも「そもそもどんな単語を使っていたんだ」となることは多い印象です。) これは、決してアカデミアでの話に限らないと感じています。同じアナリティクス・ペインにある「95%CIの平均/中央値」という日本語はその最たる例ですが、実務領域で使うような統計にも、そのような表記の揺れ/わかりにくい日本語訳というものは横行しているようです。クライアントや同僚との兼ね合いもあるとは思うのですが、可能であればTablaeuをいじるときにも、英語のホワイトノートを確認したいところです。
CIが意味する範囲を直感的に見てみる
ここでは、CIが実際にパラメーターの真値をとらえる様子をシミュレーションすることで、CIを導出するための手続きを直感的に理解することを目指します。具体的には、規分布から作った母集団と、右に大きく歪んだ指数分布から作った母集団を用意し、それぞれから何度も標本を取り出して平均値の95%信頼区間を計算します。そして、その信頼区間が実際に母集団平均を含んでいた割合、つまりカバレッジ率を確認します。なお、シミュレーションにはRを使います。
ダミーデータを作ってみます
1 2 3 4 5 6 7 8 9 10 11 12 | library(tidyverse) #Rのデータ処理から可視化までのフローで必須級のパッケージの集合体 #ggplot2というパッケージがRの可視化特化パッケージを含むlibrary(patchwork) #複数の可視化をくっつけて一つの可視化として出力するlibrary(sjmisc) #tidyverse準拠でデータ処理を助けてくれるパッケージlibrary(psych) #心理学などで多用される高度な統計モデルを備えるパッケージ #便利な記述統計表を出力してくれるset.seed(925) #PC上のランダムな作業の開始地点を固定することで再現可能性を確保する。 |
1 2 3 4 | dummy_data_no <- rnorm(100000, 5, 2) #正規分布から10000個の平均5,標準誤差2の乱数を作成dummy_data_ex <- rexp(100000, 0.2) ##平均5の指数分布から10000個の乱数を作成 |
ダミーデータの中身を確認します
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 | df_pop<- tibble(dummy_data_no, dummy_data_ex) #10000個の乱数をひとつのデータフレームに格納distribution_no <- ggplot(df_pop, aes(x = dummy_data_no)) + geom_histogram(bins = 75) + labs(x = "生成された乱数", y = "サンプル数", title = "正規分布") + theme_minimal()distribution_ex <- ggplot(df_pop, aes(x = dummy_data_ex)) + geom_histogram(bins = 75) + labs(x = "生成された乱数", y = "サンプル数", title = "指数分布") + theme_minimal() #75個のビンに分けつつ、ヒストグラムで分布を見てみます。distribution_no + distribution_ex #describe(df_pop) #記述統計量を見てみます。今回表示を省略します |

ダミー母集団から、無作為抽出を繰り返し、それぞれの標本に対してCIを求めます
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 | simulate_ci <- function(pop, n = 8, B = 100) { #引数は pop = 母集団となるDF n = 標本サイズ B = サンプリングを繰り返す回数 true_mean <- mean(pop) #母集団平均を求めます(本来未観測なパラメーター) results <- data.frame( sim = 1:B, mean = NA_real_, lower = NA_real_, upper = NA_real_, cover = NA) #これから計算する結果を格納するデータフレームを作成。何回目のサンプリングか、標本平均とそのCI、真値がCIをかんだかを保存 for (b in 1:B) { #指定のサンプリング回数に到達するまで繰り返し以下の挙動をする samp <- sample(pop, size = n, replace = TRUE) #母集団から指定したサンプルサイズだけサンプルを無作為に抽出 xbar <- mean(samp) #標本平均を計算 s <- sd(samp) #標本の標準偏差を計算 t_crit <- qt(0.975, df = n - 1) #信頼区間を計算するための値(t値)を算出 se <- s / sqrt(n) #標準誤差を算出している lower <- xbar - t_crit * se upper <- xbar + t_crit * se #信頼区間を算出している results$mean[b] <- xbar results$lower[b] <- lower results$upper[b] <- upper results$cover[b] <- (lower <= true_mean && true_mean <= upper)} #これまでの結果を先に用意したデータフレームに格納する list(df = results, true_mean = true_mean, coverage = mean(results$cover))} |
1 2 3 4 5 6 7 | dummy_sample_no_n10 <- simulate_ci(dummy_data_no, n = 10, B = 100)dummy_sample_no_n10$coverage dummy_sample_ex_n10 <- simulate_ci(dummy_data_ex, n = 10, B = 100)dummy_sample_ex_n10$coverage |
dummy_sample_no_n10でのカバレッジ率は0.96、dummy_sample_ex_n10でのカバレッジ率は0.87と計算されています。母集団が正規分布に従っているとき、100回中96回の抽出でパラメーターの真値がCIをかんでおり、一方で指数分布に従っているとき87回の抽出しかパラメーターの真値がCIをかんでいないことがわかります。
可視化してみます
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 | plot_ci <- function(sim_res, title = "") { df <- sim_res$df df$color <- ifelse(df$cover, "cover", "miss") #標本ごとに真値がCIをかんでいるかを評価する true_mean <- sim_res$true_mean #母集団平均も取り出す ggplot(df, aes(x = sim, y = mean, ymin = lower, ymax = upper, color = color)) + #可視化領域を定義する。x軸にシミュレーション回数、y軸に標本平均、真値がCIをかんだかどうかでシミュレーションを色付けする geom_hline(yintercept = true_mean, linetype = "solid", color = "blue") + #パラメーターの真値を示す青の実線を引く geom_point() + #標本平均を打点する geom_errorbar(width = 0) + #標本平均に対してCIを与える scale_color_manual(values = c("cover" = "grey50", "miss" = "red")) + #真値がCIをかんでいた時グレーに、外れていた時赤でCIが色づけされる labs(x = "シミュレーション回数", y = "平均値とその95%信頼区間", title = title) + theme_minimal()}plot_ci(dummy_sample_no_n10, "母集団が正規分布に従う場合")plot_ci(dummy_sample_ex_n10, "母集団が指数分布に従う場合") |


この図では、100回の無作為抽出それぞれについて、標本平均とその95%信頼区間を描いています。点は標本平均、縦線はその標本から計算された95%信頼区間を表しています。また、青い横線は母集団の真の平均値です。灰色の信頼区間は、真の平均値を含んでいたものです。一方、赤色の信頼区間は、真の平均値を含んでいなかったものです。つまり、赤色の線は「この標本から計算した95%信頼区間は、実際には母平均を捉えられなかった」ケースを表しています。
ここで確認したいのは、母集団が正規分布に従う場合は、標本サイズが小さくても、真の平均値を含む信頼区間が比較的多い一方で、母集団が指数分布に従う場合は、真の平均値を含まない赤い区間がやや多く見られるという点です。これは、今回使っている平均値の信頼区間が、「標本平均が正規分布に近い形でばらつく」という考え方に支えられているためです。母集団が正規分布であれば、標本平均のばらつき方も安定しやすくなります。しかし、指数分布のように大きく歪んだ分布では、標本サイズが小さいうちは、標本平均の分布もまだ正規分布に近づききらず、信頼区間の性能が不安定になります。
ただし、ここで「指数分布では信頼区間が使えない」と結論づけるのは早計です。重要なのは、標本サイズが大きくなったときに何が起きるのかです。そこで次に、標本サイズを変えながら、信頼区間が真の平均値を含んだ割合、つまりカバレッジ率がどのように変化するのかを確認します。
中心極限定理を見てみます
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 | sample_sizes <- c(10, 20, 50, 100, 500, 1000, 2000, 3000)#標本内のサンプル数が増えるとどうなのだろうか。B <- 10000#シミュレーションの回数は大数の法則でわかりやすくなるように大きめに設定results_list <- list()#結果を格納するオブジェクトを事前に用意してみるfor (n in sample_sizes) { res_dummy_data_no <- simulate_ci(dummy_data_no, n = n, B = B) res_dummy_data_ex <- simulate_ci(dummy_data_ex, n = n, B = B) #先に定義したサンプル数の標本をとる10000回のシミュレーションを実施 results_list[[paste0("dummy_data_no", n)]] <- tibble(pop = "dummy_data_no", n = n, coverage = res_dummy_data_no$coverage) results_list[[paste0("dummy_data_ex", n)]] <- tibble(pop = "dummy_data_ex", n = n, coverage = res_dummy_data_ex$coverage) #シミュレーション結果をリスト形式で保存 }coverage_table <- bind_rows(results_list)#リスト形式をデータフレーム形式に変換ggplot(coverage_table, aes(x = n, y = coverage, color = pop)) + #横軸に標本サイズ、縦軸にカバレッジ率をとり、母集団ごとに色分けして表示する領域を定義 scale_x_log10() + #横軸は常用対数になるように変換 geom_line() + geom_point(size = 3) + #カバレッジ率を折れ線グラフにする geom_hline(yintercept = 0.95, linetype = "dashed") + #カバレッジ率95%を示すレファレンスラインを引く labs ( x = "標本サイズ(対数)", y = "カバレッジ率", color = "母集団の分布", title = "サンプルサイズ別カバレッジ率の変化", subtitle = "横の破線は95%を示す") + scale_color_manual(values = c("dummy_data_ex" = "red", "dummy_data_no" = "blue"), labels = c("指数分布", "正規分布")) + theme_minimal() |

この図は、標本サイズを変えながら、95%信頼区間が実際に母平均を含んだ割合を示したものです。横軸は標本サイズ、縦軸はカバレッジ率です。破線は、理論上期待される95%の水準を表しています。正規分布から標本を取った場合、カバレッジ率は標本サイズが小さい段階から、安定して95%付近を推移し続けます。これは、母集団が正規分布に従っているため、標本平均の分布も信頼区間の計算で想定している形に近くなりやすいからです。
一方、指数分布から標本を取った場合、標本サイズが小さいうちはカバレッジ率が95%から大きく外れています。指数分布は右に大きく歪んだ分布なので、少ない標本だけでは、標本平均のばらつき方も正規分布のような対称的な形になりにくいためです。しかし、標本サイズが大きくなるにつれて、指数分布の場合でもカバレッジ率は95%に近づいていきます。これは中心極限定理と呼ばれる定理の恩恵です。中心極限定理(英:Central Limit Theorem)とは「同一の確率分布からの互いに独立な測定値の標本平均の分布は、元の確率分布の形によらず、nの増加に伴っていくらでも正規分布に近づく」(豊田2015 p22)定理です。つまり、平均値の信頼区間を使うときに重要なのは、必ずしも「元のデータが正規分布しているか」だけではありません。むしろ重要なのは、「標本平均という推定量の分布が、正規分布に近いとみなせるか」です。
今回のシミュレーションでは、母集団が正規分布であれば小さい標本サイズでも信頼区間は安定しやすく、母集団が歪んでいる場合でも、標本サイズが大きくなるにつれて信頼区間の性能が改善することが確認できました。つまり、信頼区間は無条件に信頼できるものではありません。信頼区間は、推定量のばらつき方についての仮定や近似に支えられた手続きです。そのため、データの分布が大きく歪んでいる場合や標本サイズが小さい場合には、計算された信頼区間をそのまま信じるのではなく、その前提がどの程度成り立っているのかを考える必要があります。
引用文献