Tableauアナリティクス・ペイン完全攻略 #2 推測統計の始まりと、区間推定の第一歩 95%CIの中央値/平均値
エクスチュアのシガです。梅雨です。ちょっと前の台風で庭に植わっているあじさいが台風でぐっちゃになってから持ち直せていないのが心配です。皆さま、絶妙にブルーな季節にいかがお過ごしでしょうか。
シリーズ2本目となるこの記事では、Tableauのアナリティクス・ペインにある「95%CIの中央値/平均値」を扱います。「95%CIの中央値/平均値」はどのような目的意識の時に可視化する必要があるのか、それからどのような情報を得ることができるのかを理解することが目的となります。中央値/平均値はどちらも前回でどのような統計量なのか解説をしました。(ぜひ、1回目も読んでください)。今回は「95%CIの」とありますが、そのCIとは何かを以下の順で説明します。理論的な説明はよいので、どう扱うか、どう読むかが知りたい人は「Tableauでの信頼区間との付き合い方」まで飛んでみてください。
目次[非表示]
- 1.推測とは何か
- 2.不確実性の評価とは何か
- 2.1.点推定から区間推定へ
- 2.2.何が95%なのか
- 3.Tableauでの信頼区間との付き合い方
- 3.1.一変量の不確実性の評価
- 3.2.なんちゃって差の検定
- 3.3.ちょっとした実装のヒント
- 3.4.まとめると。。。
- 3.5.引用文献
推測とは何か
このセクションでは推測統計の基本的な哲学を概観することで、CIを求める目的意識を確認します。アナリストが実際に扱うことができるデータは、往々にして様々な制約を持ちます。様々な仮定を置いたり、数学的な特徴を駆使することでその制約を克服して、自身の関心にこたえることが「推測」統計の目的です。
我々は、なにがしか検証したいことを持ち、データに向き合います。この関心が決まると、おのずと分析するべき「対象」が決まるはずです。このように、分析者の関心から理論的に導出される分析対象の全体像を母集団(英:population)と呼びます。母集団は必ずしも観測可能であるとは限りませんが、理論上必ず一意に想定されます。
一方で、母集団を100%反映したデータをそのまま分析すること(全数調査と呼ばれます)は、現実的ではありません。あらゆるコストが一人のアナリストが処理できる域を簡単に超えてしまうからです。そこで、母集団の全容が「推測できるような」母集団の一部を一定の手続きで取り出し、そこから母集団を推測します。この抽出された一部を「標本」(英:Sample)と呼びます。ここで大切な発想は、母集団は仮説に対して一意に定まる一方で、標本は「無数に存在しうる」という点です。ひとつの母集団から標本は無数に作成することができますが、それら無数な標本は抽出の手続きが同一である限り平均的には母集団の特徴に似通ってくることが知られています。
母集団は、たいてい手の届かない大きな世界です。推測統計では、その世界からたまたま取り出された標本を手がかりに、母集団の特徴を考えます。この時、「(多くの場合母集団における)関心のある未知の数量」をパラメータ(Llaudet and Imai 2025, p216)と呼びますが、このパラメータを知るために標本特有の統計量を我々は参照します。
不確実性の評価とは何か
このセクションでは、標本から母集団を推測するときに発生する「おそらく」を可視化することができるCIについて解説を展開します。「推定に伴う不確実性を表すために利用されるのは、信頼区間(Confidence Interval:CI)」(浅野 &矢内 2018, p130)ですが、どのようなアプローチで、どのような不確実性を評価しているのか理解できるようになることが目標です。
点推定から区間推定へ
推測統計には大きく「点推定」と「区間推定」という2分類に整理されることが多いです。標本から一意に導出された統計量をそのまま母集団のパラメータの推定値として採用するのが点推定(point estimation)です。一方で、特定の標本が抽出されたことに起因する、点推定値そのものの不確実性を評価するのが「区間推定(interval estimation)」です。一意に求まっている点推定値の前後に一定のバッファを用意します。このバッファの幅を、あらかじめ定めた高い確率(例えば95%)で母集団のパラメータの真値を捉えられるように設計することで、特定標本の抽出に伴う不確実性を表現します。(片瀬・阿部・高橋 2015, p111)
何が95%なのか
【区間推定は不確実性を表現するために「バッファ」を持たせる】としましたが、このバッファの幅は、あらかじめ定めた確率(カバレッジ率、例えば95%)で母集団のパラメータを捉えられるように設計されています。このバッファこそが、これまで名前のみ登場してきた信頼区間(CI)の正体です。信頼区間(英:Confidence Interval)とは、「パラメータの真値を含む可能性の高い値の範囲」(Llaudet and Imai 2025, p240)を意味します。この時注意しなければいけないのは、%で表現されている不確実性はあくまで、母集団から特定の標本をサンプリングする過程によって生じるものです。決して「今手元にある標本によって求められた信頼区間の間に母集団のパラメータが収まる確率」ではありません。CIを求める推測統計の世界では、母集団は一意に定まるので、母集団のパラメータも一意に定まります。唯一絶対な母集団から無限に標本を抽出し、それぞれの標本ごとにCIを求めていると考えます。それらのCIのうち一定の割合(例えば95%)で、一意に定まっている未知のパラメータを捉えます。確率が宿っているのは、個々のCIではなく、この無限に標本を取り直すプロセスの方なのです。
Tableauでの信頼区間との付き合い方
このセクションでは、Tableauにおいてどのように中央値や平均値のCIが可視化されるかを確認するのと同時に、Tableauで誤って解釈してしまいそうなCIの使い方を実際の可視化とともに説明します。Tableauを使った可視化において信頼区間を表示する目的は、一変量の平均値の不確実性を示す、あるいは独立したサンプル同士で平均に差があるかどうかあたりをつける、このどちらかしか思い当たりません。その意味でTableauでCIを可視化する方法はここで理解できると思っても差し支えない気がします。
このセクションでは、かの有名なデータセットのひとつであるpenguinsをつかい、一つの変数の平均の不確実性をどのように可視化するのか、それをどう読み取るのかを解説します。ペンギンの研究者になった気分で見てみてください。データについては、こちらのKaggleから参照してみてください。
一変量の不確実性の評価
まず、データにあるサンプルペンギンすべてを対象に羽の長さの平均をCIリボンをつけてみてみます。
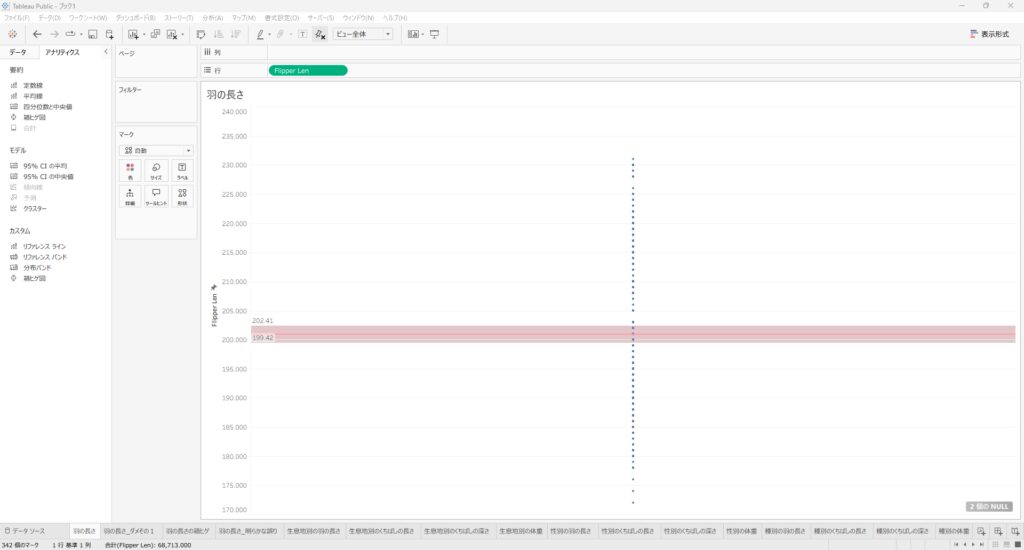
CIの下限が199.42、上限が202.41となっています。見にくいので消していますが、この標本から計算された標本平均は200.91mmです。ただし、標本は母集団からたまたま取り出された一部なので、標本平均だけをそのまま母平均とみなすには不確実性があります。Tableauが表示している95%CIは、同じ手続きで標本抽出と区間推定を繰り返したとき、約95%の区間が母平均を含むように設計された幅です。したがって、この図では「母平均の推定値は200.91mmであり、その推定には199.42mm〜202.41mm程度の不確実性がある」と読むのがよいでしょう。
なんちゃって差の検定
CIの誤った使い方として代表的なのが、複数のCIの重なり具合だけを見て「母集団のパラメータ同士に差があるかどうか」を判断してしまうというものです。これは”Inference by Eye: Confidence Intervals and How to Read Pictures of Data”(American Psychologist, 2005)というペーパーでも指摘されている、CIグラフを読む際の典型的な誤りの一つです。原則として、異なる標本から計算されるCI間を比較することはできません。原理的には全く異なる母集団を推定しているからです。
ただし例外が一つあります。対応のない(独立した)2つの変数に限っては、CIが重ならないということをもって、「パラメータに差がある」という結論を暫定的に下してもよい、とされているそうです。目安として、95%CIが完全に重ならない場合は、通常の有意水準(0.05)よりもかなり厳しい基準(おおよそ0.01相当)を満たしていると考えられるためです。 注意したいのは、その逆は成り立たないという点です。帰無仮説有意性検定の枠組みに基づく考え方なので、CIが重なっている場合に言えることは「差があるかどうかわからない」だけです。「差がない」と結論づけることはできません。仮説検定はそもそも「差がないこと」を証明する仕組みではないので、原理的な限界です。
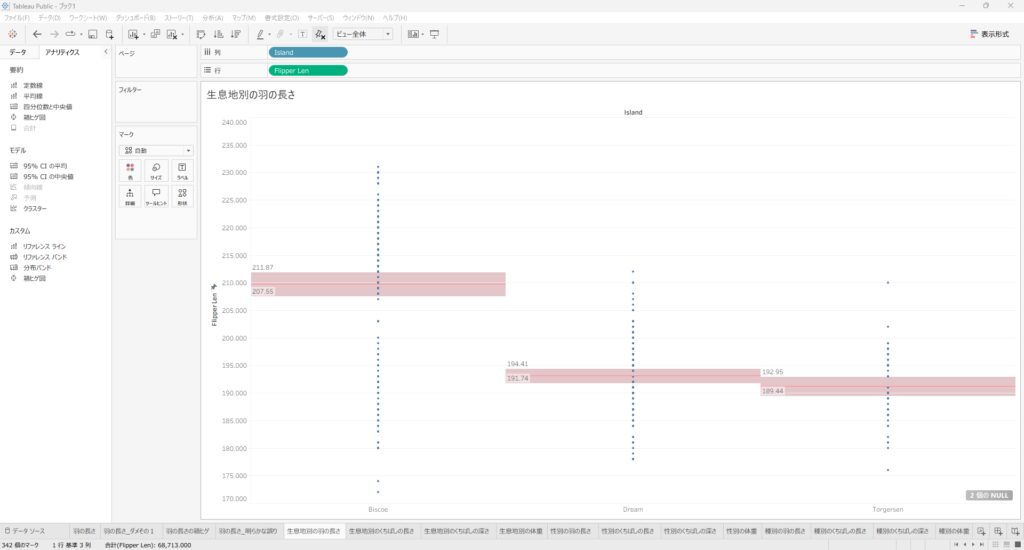
先ほどまで見ていた羽の長さについて、生息している島ごとに違いがあるかどうかを見てみるとします。Dream島とTorgersen島のCIが重なっているが、それぞれBiscoe島のCIと重なっていないことがわかります。Biscoe島のみ、平均的に大きそうだという推測が成り立ちます。
では、Rという統計ソフトで差があるかどうかを見てみます。厳密には、群間の比較には群間の平均値の差に対してCIを推測し、不確実性を評価します。左から diff= 「推測される平均の差」、lwr = 「平均の差のCIの下限」、upr = 「平均の差のCIの上限、p adj = 「この差が生まれたのが偶然なのかを評価する特別な指標」の順で表示されています。a adjが0.05を下回ったとき、95%信頼区間で評価されたパラメータが0をまたがず、差があるだろうという推論をしたことを意味します。Torgersen島とDream島の間の差のみが偶然かわからないが、それ以外は差があるだろうと言っています。
Fit: aov(formula = flipper_len ~ as.factor(island), data = penguins)

$`as.factor(island)`
                       diff        lwr        upr     p adj
Dream-Biscoe     -16.634006 -19.742902 -13.525110 0.0000000
Torgersen-Biscoe -18.510508 -22.706298 -14.314719 0.0000000
Torgersen-Dream   -1.876502  -6.239167   2.486163 0.5694419
もうひとつ、別の例を見てみましょう。種別のくちばしの長さの平均をCIリボンとともに報告してみます。
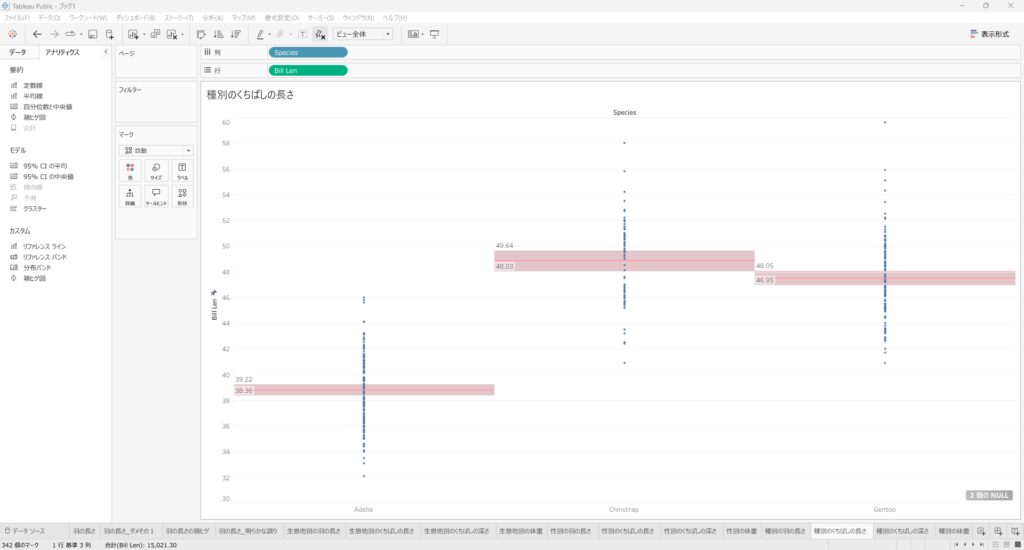
Chinstrap種とGentoo種がほんの少しだけCIが重なっていて差があるかどうかわからないが、これくらいなら差がありそうだと直感します。Adelie種とほかの種は明確に差がありそうです。
先ほどと同様に、Rでの検定結果を見てみましょう。
Fit: aov(formula = bill_len ~ as.factor(species), data = penguins)

$`as.factor(species)`
                      diff       lwr        upr     p adj
Chinstrap-Adelie 10.042433  9.024859 11.0600064 0.0000000
Gentoo-Adelie     8.713487  7.867194  9.5597807 0.0000000
Gentoo-Chinstrap -1.328945 -2.381868 -0.2760231 0.0088993
すべての比較において差があるという検定結果があります。ペーパーでの言及の通りかすかに重なる程度ならば、はるかに厳しい有意水準で差が偶然でないことを体験することができました。CIの重なりを目で確認するのは、当たりをつけるための第一歩に過ぎず、最終的な判断はきちんと検定に委ねるべきといえるでしょう。
ちょっとした実装のヒント
ちょっとした可視化の方法論をふたつ共有しておきます。95%CIを作るときは1)必ず「メジャーの集計」をオフにすること、 そして2)リボンの色をデフォルトから変えることです。
まず、この可視化を見てください。
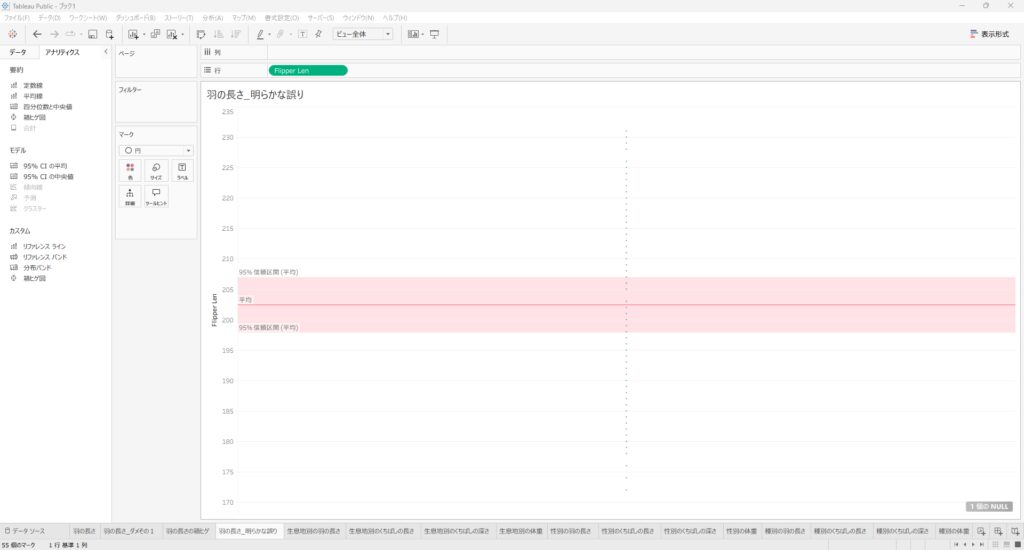
この表は羽の長さの平均をCIのリボンをつけて表示しているのですが、ひとつまえの可視化と明らかに計算結果が違うことがわかります。この可視化は、「分析」のツールバーにある「メジャーの集計」をオフにせずメジャーをディメンジョン化することで作成したものです。左下のマーク数が55と著しく減っていることがわかります。全く同じ観測値であるサンプルが集計されている状態になっているためです。この状態では本来見たいサンプルとはまた違った標本を作り出している状態なので、誤った計算がなされてしまいます。
シガは初めて作ったとき、メジャーのディメンジョン化という概念が理解できておらず、ディメンジョン化→集計をやめるという意味であると勘違いしていました。実際、集計したら作成することができない箱ひげ図が作成できてしてしまうので、非常に危険です。お気を付けください。
次に、このダメな可視化を見てください。羽の長さの中央値にCIリボンをつけています
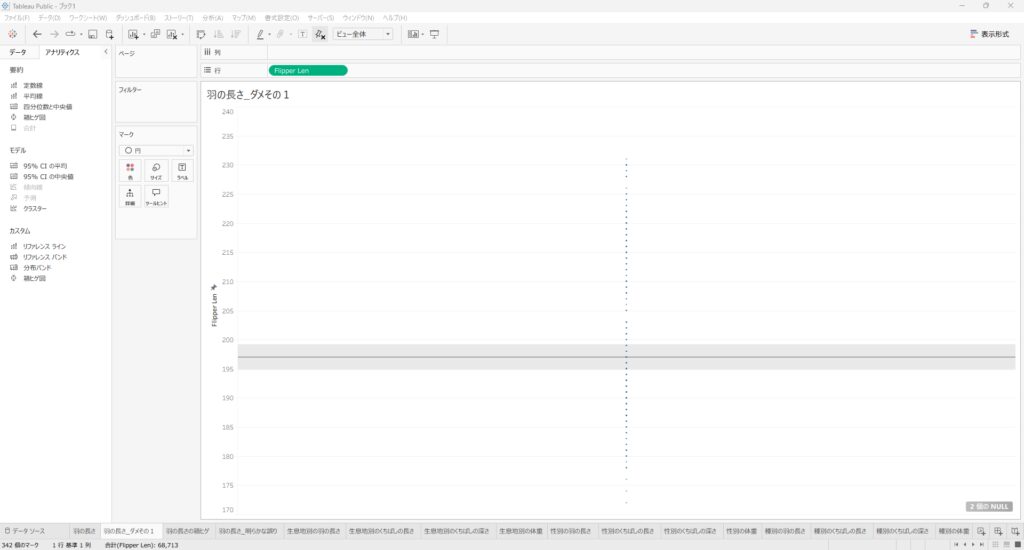
見覚えのある人が多いと思います。そう、箱ひげ図みたいなのです。
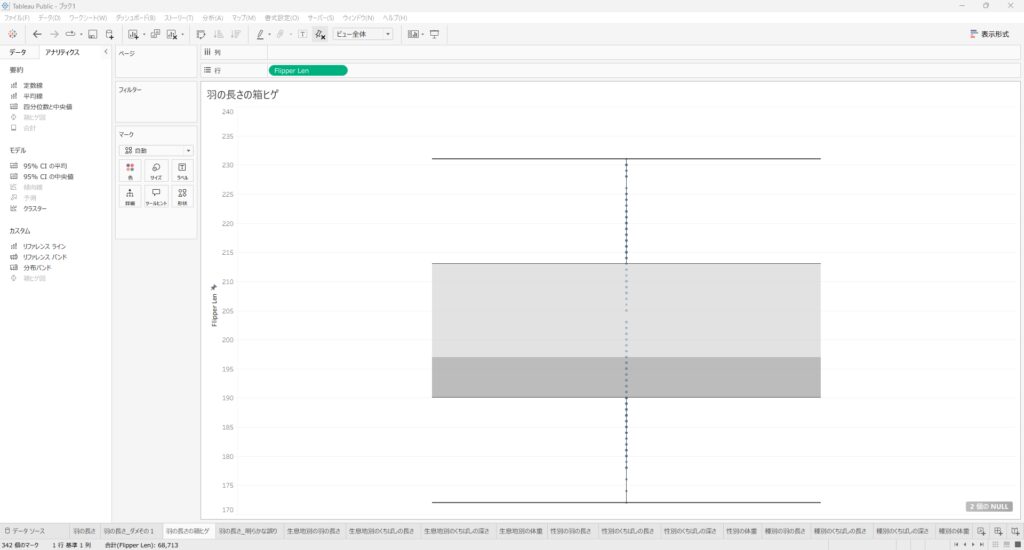
CIのリボンが示しているのは不確実性であって、分布ではありません。あまりシガ的には直観しにくいのですが、CIはばらつきを示すと勘違いしてしまう人がいるそうです。いずれにせよ、一目でその可視化がどのようなモデルにデータを当てはめたものなのか理解できないのは問題があるので、せめての工夫として色を付けることをお勧めします。
まとめると。。。
「95%CIの中央値/平均値」は、平均値や中央値の推定に伴う不確実性を可視化する機能
CIは推定値の不確実性を示す95%CIは「この区間に真の値が95%の確率で入る」という意味ではなく、同じ手続きで標本抽出と区間推定を繰り返したとき、約95%の区間が母集団の真の値を含む、という意味
CIの重なりだけで差の有無のあたりがつくことはあるが、断定することはできない
See You Soon!
シガ
引用文献
CummingGeoff, FinchSue. (2005). Inference by eye: confidence intervals and how to read pictures of data. Am Psychol, 60(2), 170-80. doi:10.1037/0003-066X.60.2.170.
LlaudetElena, ImaiKosuke. (2025). 新 社会科学のためのデータ分析入門 導入編. (原田勝孝, 訳) 岩波書店.
浅野正彦, 矢内勇生. (2018). Rによる計量政治学 (第 初版 版). オーム社.
片瀬一男, 阿部晃士, 高橋征仁. (2015). 社会統計学米シック (第 初版 版). ミネルヴァ書房.