Tableauアナリティクス・ペイン完全攻略 #1 四分位数と中央値、箱ひげ図
初めまして。シガと申します。今年4月からエクスチュアに新卒入社したフレッシャーズです。駆け出しで至らない点多いと思いますが、少しでも読者の皆さまのお役に立てるように頑張っていく所存です。今後まれにこのブログに浮上することになると思います。末永くよろしくお願いします。
記念すべきシガ1本目のブログの目的は、TableauのVizを強化する「アナリティクス・ペイン」にある分析のうち「四分位と中央値」とその可視化方法である「箱ひげ図」(英:box-whisker plot)について解説することです。四分位数(英:quantiles)とは値の大小関係を基軸に手持ちの変数の分布をとらえる記述統計量のひとつです。ここでは四分位数とは何なのかについて
記述統計とは何なのか
四分位数とは何なのか
頻出する類似概念にはどのようなものがあるのか
箱ひげ図をどのように理解するのか
以上4つの質問に答えられるように説明を展開します。Tableauの強みは、手軽にVizを作り出せることです。ただ、その手軽さゆえに、データの実態を確認しないまま可視化や分析に進んでしまいがちでもあります。この記事ではその点を意識しながら読み進めてもらえると嬉しいです。
目次[非表示]
Why checking 記述統計(量)
このセクションでは、データを定量的に扱うときに一番最初に確認をするべき「記述統計(量)」(英:descriptive Statistics)について、その目的意識の解説を行います。記述統計冒頭では、「四分位数は・・・記述統計量のひとつ」という紹介をしました。この記述統計とは、「ある変数の分布の主な特徴を数値的にまとめたもの」(Llaudet and Imai. 2025 )を指します。データを可視化し理解する方法はたくさんありますが、記述統計がどうして他のあらゆる分析や可視化と違うレイヤーで重要視されるかを理解します。
分析者は必ず、データを見る前から仮説を持っていなければなりません。しかしながらその仮説は、往々にして複数の仮定の上に成り立っているものです。「このサンプルは分析に十分な数があるはずだ」「この変数には極端な外れ値は混入していないはずだ」——こうした仮定がひとつ、ふたつと崩れれば崩れるほど、そのあとにどれほど精緻な分析を行っても、その結論は砂の上に建った城にしかなりません。だからこそ、本分析に入る前に、分布の形・中心傾向・ゆがみ・外れ値の有無・欠損値やサンプルサイズの過不足といった変数の実態を一通り確認し、自分の仮説を支える仮定をひとつひとつ点検する記述統計の確認が必要となります。
重要な視点は、このふたつの目的を持つ我々の究極的な目的は「その先の推論や分析を誤らないこと」であることです。記述統計の確認は、データ理解と分析の妥当性を証明するという二つの大きな役割を果たす重要なステップです。だからこそ、分析者は必ず、仮説を立てる → データを入手する → 記述統計を確認する → データ・ハンドリングをする → 再度記述統計を確認する → 本分析の開始 という鉄のフローを必ず回す必要があります。
四分位数とは
このセクションでは、統計量のひとつである「四分位数」について、その算出方法と解釈の仕方について解説をします。前セクションでは、記述統計をどうして確認する必要があるのかを示しました。このセクションでは、四分位数を記述統計量としてどのように理解することができるのかまとめます。四分位数とは、データを昇順に並べたときに全観測値を4等分する3つの境界線の総称です。観測値の分布が持つ「ゆがみ」「中心傾向」「散らばり」を範囲でとらえる統計値です。また、これらの数値は観測値の外れ値を定義する(あるいは候補にする)ために参照されることもあります。
四分位数と同時に知っておきたい統計量
四分位数とは、「第一四分位数」「中央値」「第三四分位数」の3つの記述統計の総称とお話ししましたが、合わせて理解しておきたい統計量がいくらか存在します。どれも1変数の分布を要約するために存在する統計量です。
第一四分位数(英:first quantile; Q1 )
変数を昇順に並べたとき、下位25%と上位75%の境界となる値第二四分位数(中央値)(英:median)
変数を昇順に並べたとき、下位50%と上位50%の境界となる値第三四分位数(英:third quantile; Q3)
変数を昇順に並べたとき、下位75%と上位25%の境界となる値四分位範囲(英:interquartile range)
第三四分位数から第一四分位数を引いた値、データの中心半分がどの程度密集しているかを示す外れ値(英:outlier)
Tableauのデフォルトの定義では第一四分位数から1.5*IQRを引いた値より小さい観測値、あるいは第三四分位数に1.5*IQRを足した値より大きい観測値平均(英:mean; average)
すべての観測値の合計を、観測数で割った値最頻値(英:mode)
すべての観測値の中で、最も観測された回数の多い値
四分位数と箱ひげ図、ゆがみの読み取り
四分位数はデータの理解、特に分布のゆがみを理解することに強みを持ちます。この強みは、四分位数を可視化した箱ひげ図を通じて直感的に確認できます。ここからは箱ひげ図の読み方を簡単に整理したうえで、実際にかの有名なtitanicデータセットのAge(年齢)とFare(運賃)を例に、歪みの読み取り方を見ていきます。
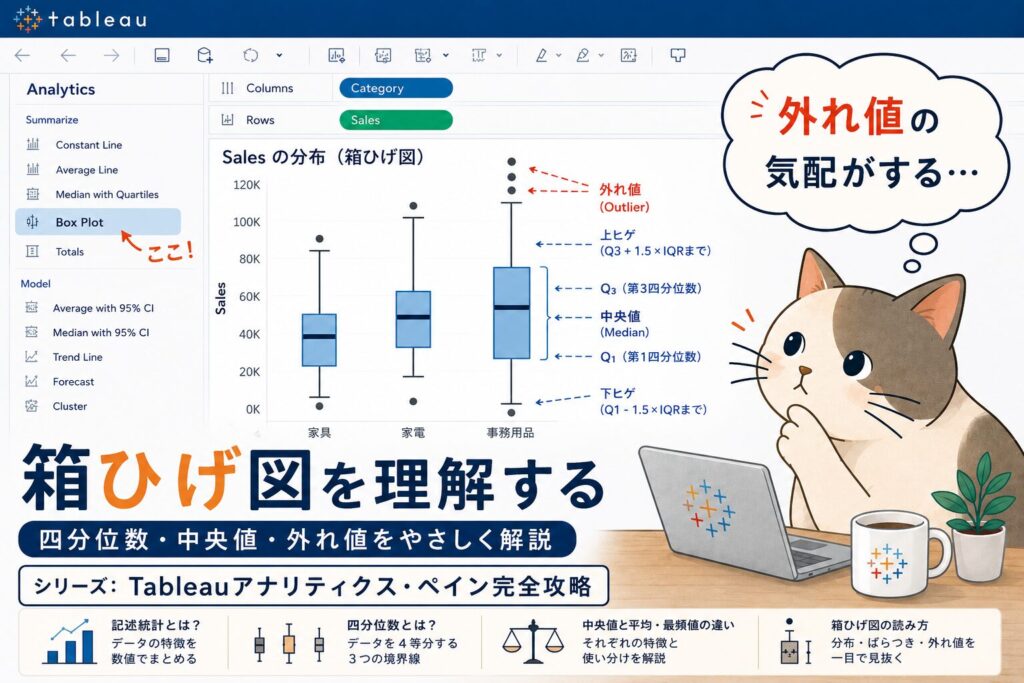
箱ひげ図は大きく四分位数と四分位範囲を示すハコの部分と、外れ値以外の変数の分布する範囲(あるいは、純粋に変数の範囲)を示すヒゲの部分で構成されます。箱の部分は見ての通り、各グラフの四角形部分であり、ヒゲの部分は箱の上下から出ている棒の部分を指します。箱の下端が第一四分位数、箱の上端が第三四分位数、箱内部の線が中央値を示します。一方で、ひげは(Q1-1.5IQR)の値(あるいは最小値)と(Q3+1.5IQR)の値(あるいは最大値)とを示します。つまり、このひげの外部にある値が一般的には外れ値として扱われます。
まず、タイタニック号乗船者の年齢の分布を箱ひげ図で可視化してみます。
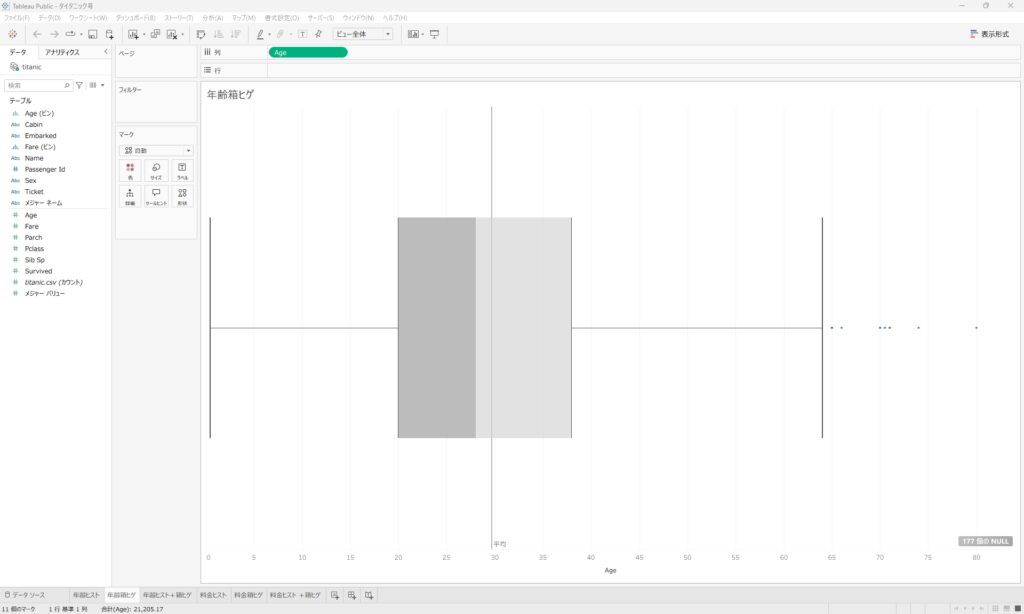
Q1からQ2、Q2からQ3の間隔はほぼ1:1であり、分布はおおむね対称に近いと読み取れます。ただし、Q2からQ3がわずかに広く、中央値より上側の観測値の方がやや散らばりが大きいことを示唆しています。また、ひげの外部に外れ値がいくつか確認でき、平均は中央値よりもわずかに大きくなっていると予想できます。
実際にヒストグラムと平均値を合わせて確認してみましょう。
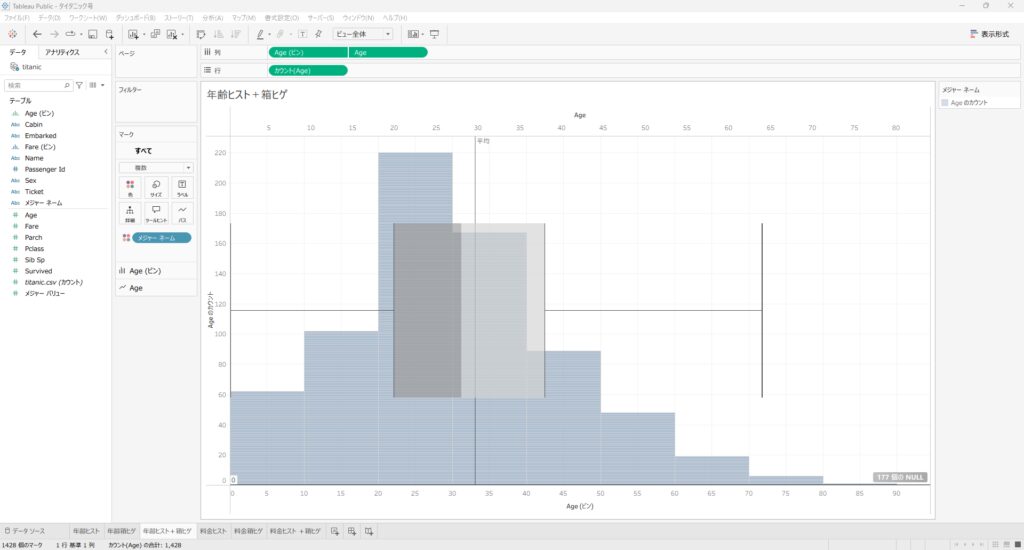
続いて、タイタニック号乗船者のFare(料金)も分布を見てみましょう。
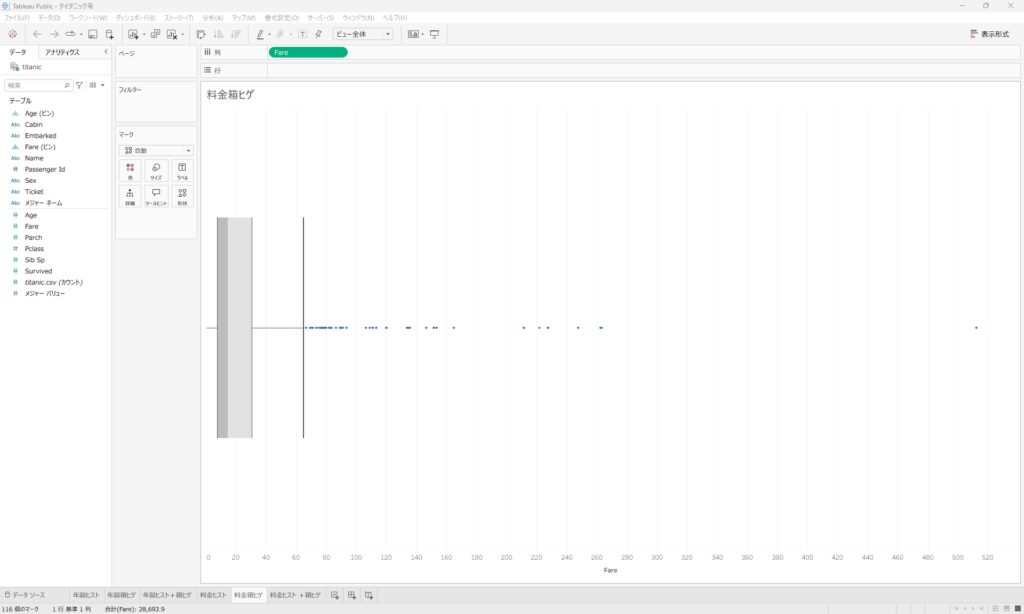
Ageの箱ひげ図と比較して、極端な形をしているのがわかります。Q1からQ2の間隔がQ2からQ3に比べて著しく狭く、中央値より下側の観測値が密集していることを示しています。逆にQ2からQ3にかけての箱、さらにそこから伸びるひげは非常に長く、右裾に向かって大きく広がる分布であることがわかります。加えて、ひげの外側に多数の外れ値が確認でき、これらの極端に高い運賃が平均を大きく引き上げていると考えられます。
実際にヒストグラムと平均値を合わせて確認してみましょう。
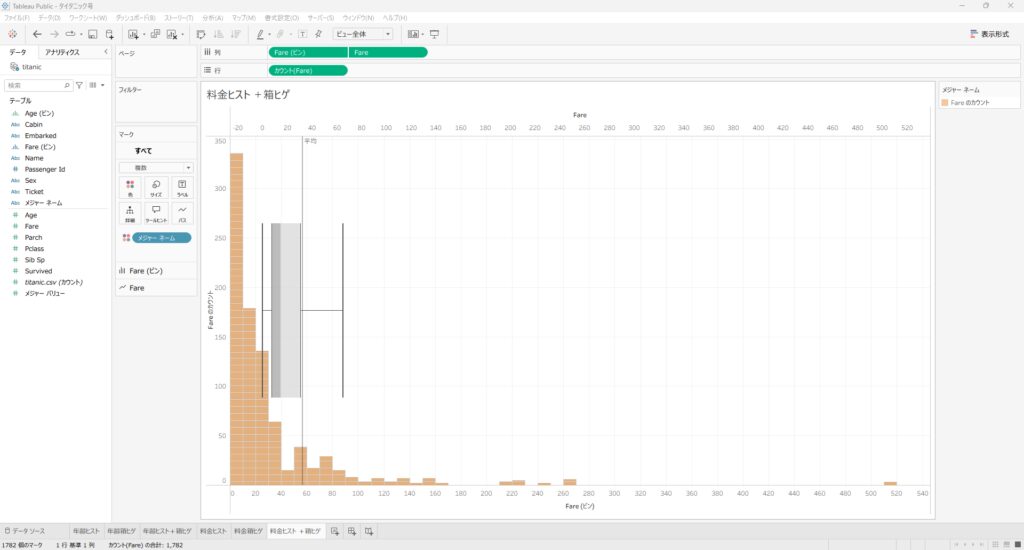
この二つの変数の分布を見ればわかる通り、どれか代表値をひとつだけ見ても、その値が実態を正しく反映しているかどうかは判断できません。四分位数を並べることで分布の歪みの方向と大きさを把握し、各代表値を歪みの分だけ解釈を改める必要があります。四分位数はそのための相対化の道具です。また四分位数は、IQRを基準にした外れ値の候補の特定にも使われます。極端に大きい・小さい値がデータに混入していないかを確認するための手がかりとして参照されます。
中央値と平均・最頻値のせめぎあい
このセクションでは、四分位数の中でも特に参照されることの多い中央値について、類似する概念である平均と最頻値との違いに注目しながら解説を行います。前のセクションでは、実際に四分位数を箱ひげ図で可視化したときの読み方について考えました。このセクションでは、ではなぜそのようなずれが生まれるのか、手持ちのデータが示す分布のゆがみをもたらす「現象」をどのように解釈するのかについて考えます。中央値/平均値/最頻値はどれも手持ちのデータの中心的傾向を知るための統計値ですが、それぞれ明確に違う意味を持つ値であり、その使い分けには注意が必要です。
中央値/平均/最頻値の3つの違いは、どのように「だいたいみんながそうだ」をとらえるかの違いであると考えるとわかりやすいです。もちろん一致することもありますし、ずれることもあります。大切なのは、これら3つの数値が一致するのか/しないのか、変数の分布をなんとなく分析前に想定しておくことです。それが自分の想定通りであればそのまま分析に進めばよく、想定から外れたならば、どうして想定が外れたのか、3つの統計量から特定することです。これら3つにはそれぞれ特徴があります。平均値は外れ値に強く影響されます。中央値/最頻値は外れ値の影響を受けにくいですが、それぞれ強みが違います。中央値は順序情報に強いですが密度に鈍感です。いっぽうで、最頻値は密度には強いですが、それゆえにクラスターの存在に弱いです。空想の企業E社の昇給審査を例に考えてみましょう。なお、E社の社員は50人程度とまだまだ一人の外れ値が大きな影響力を持ちうる規模であるとします。
「全社員の昇給額を社員数で割るとX万円だった」(平均)
「社員を評価が良い順に並べたとき、真ん中の人の昇給額はY万円だった」(中央値)
「3段階で最もありがちな評価の人に与えられる昇給額はZ万円だった」(最頻値)X=Y=Zの場合全社員給料据え置きかもしれません。
X≠Y、Y=Zの場合
一人だけ100万アップ、他社員は給料据え置きかもしれません。X<Y=Zの場合
社長は報酬据え置き、一人だけ100万アップ、他社員はベア12万円のみかもしれません。
これら3つの要約統計量を見るだけでも、自分の手持ちのデータに対して様々な解釈の余地が生まれてしまいます。ただ自分が持っているデータがどのパターンに当てはまるかは、実際にデータを見るまでわかりません。だからこそ、分析を始める前に「この3つは一致しそうか、ずれそうか」を仮説として持っておくことが重要です。一致していれば素直に進めばよく、ずれていれば「なぜずれているのか」仮説を理論的に見直したり、データの生成過程を再確認し自分のデータが仮説に対して妥当な生成過程を経ているかを見直したりするきっかけにします。
まとめると・・・
・データ分析をするときは記述統計値を複数確認して、自分の分析の妥当性を確認する。
・四分位数とは複数の記述統計値をセットにしたものの一つ。複数の記述統計値を比較してデータ分布のゆがみを理解する。
・箱ひげ図とは四分位数の可視化方法のひとつ
・中央値と平均値・最頻値はそれぞれデータの中心傾向を示すが、データ分布のゆがみに応じて適切な使い分けをする必要がある。
See You Soon!
シガ
引用文献
ローデエレーナ, & 今井耕介. (2025). 新 社会科学のためのデータ分析入門 導入編 (原田勝孝, Trans.). 岩波書店.
===追記 2026年6月18日===
タイタニック号乗船者の年齢/乗車料金の箱ひげ図とヒストグラムを組み合わせたVizについて誤りがあったため、画像を入れ替えました。なお、本文内容に変更はありません。
原因はTableauにメジャーの集計をしないように指示することを忘れていたからになります。メジャーの集計を外すのが正しい可視化となります。
この度は、不正確なVizを示してしまったこと、心からお詫び申し上げます。データを扱うものとして、数字の細かな設定確認を怠ってしまったこと、恥じ入るばかりです。より徹底した確認を心掛けるようにいたしますので、引き続きよろしくお願いいたします。
志賀
=== ===