SnowflakeSummit26 keynote Day2 要約
こんにちは中村です。
Snowflakeの2日目のキーノートでは、Snowflakeを単なるDWHや分析基盤ではなく、AIエージェントが業務を実行するためのプラットフォームへ進化させる方向性が強く打ち出されました。
1日目が「Agentic Enterprise」という大きなビジョンを示す内容だったとすると、2日目はそのビジョンを実現するための具体的な新機能・機能追加が中心でした。
1日目の内容はこちらからどうぞ
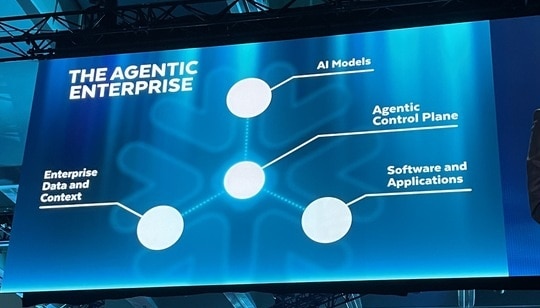
1日目のAgentic Enterprise
発表はかなり広範囲にわたりますが、この記事では特に「何が新しくできるようになったのか」「既存機能がどう強化されたのか」に絞って整理します。
この記事でわかること
- Snowflake CoWork / Coco関連の新機能
- Snowflake DataStreamを中心としたデータ連携の強化
- Cortex、AI、ML関連の機能追加
- アプリ開発・パイプライン開発体験の改善
- AIエージェント時代のガバナンスとセキュリティ
- Icebergやデータ共有など、オープン性に関する拡張
Snowflake CoWork:Cocoから全社向けAIワークスペースへ
今回の大きな発表のひとつが、Cortex Code、通称Cocoの位置づけ変更です。
従来のCocoは、開発者、データエンジニア、アナリスト向けのAI作業支援エージェントという色合いが強いものでした。今回の発表では、そのスコープをさらに広げ、Snowflake CoWorkとして全社員向けのAIワークスペース/パーソナルエージェントへ進化させる方向性が示されました。
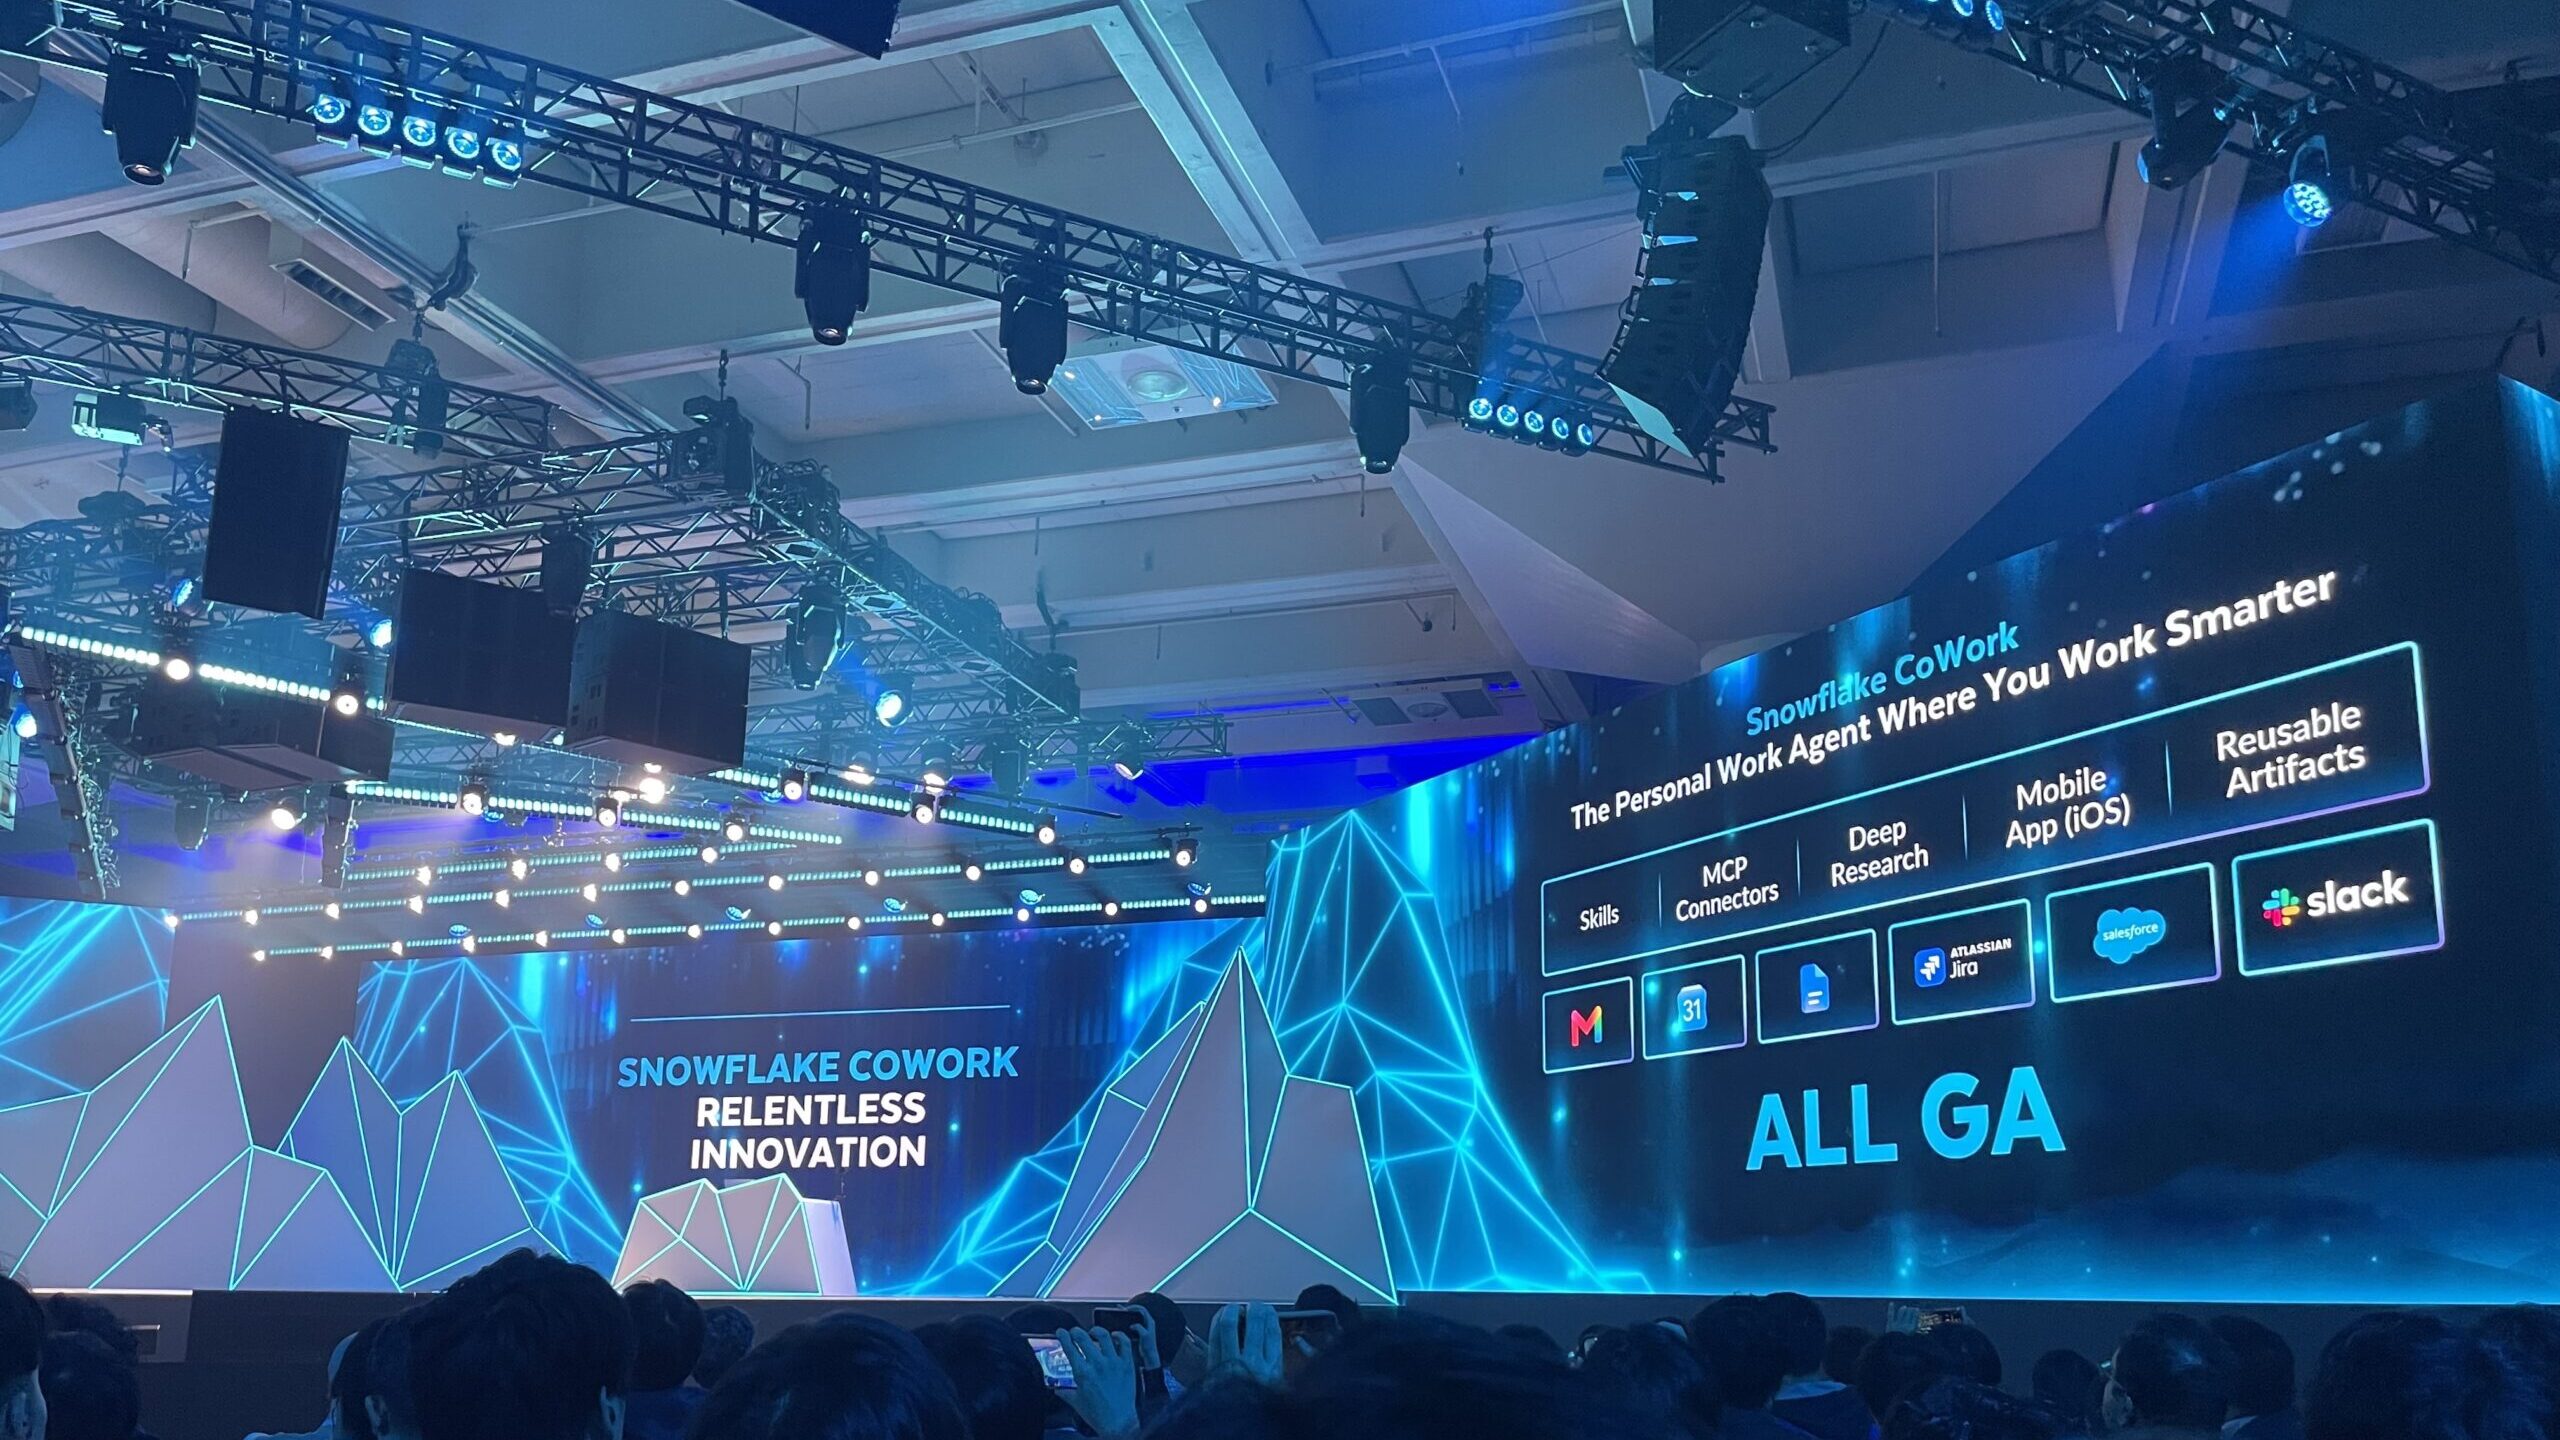
つまり、SnowflakeはAIを「開発者向けの補助ツール」に閉じるのではなく、ビジネスユーザーも含めた全社的な業務AI基盤として展開しようとしています。
CoWork / Coco関連の主な機能追加
Cloud Agentsは、Snowsight上でサンドボックス環境を使いながら、AIに作業を実行させるための機能です。従来CLIで行っていたような操作を、Snowsight上でより安全に試せるようになります。
Automations / Autonomous Agentsは、スケジュール実行や非同期APIによって、AIエージェントが定期的・自律的に作業できるようにする機能です。毎朝のレポート作成、週次の異常検知、パイプラインの定期チェックなど、繰り返し発生する分析・運用業務をAIに任せる使い方が想定されます。
Skill Catalogも重要な追加機能です。社内で作成したスキルやプラグインを共有・発見・再利用できるようにするもので、部門ごとのAI活用を横展開しやすくします。
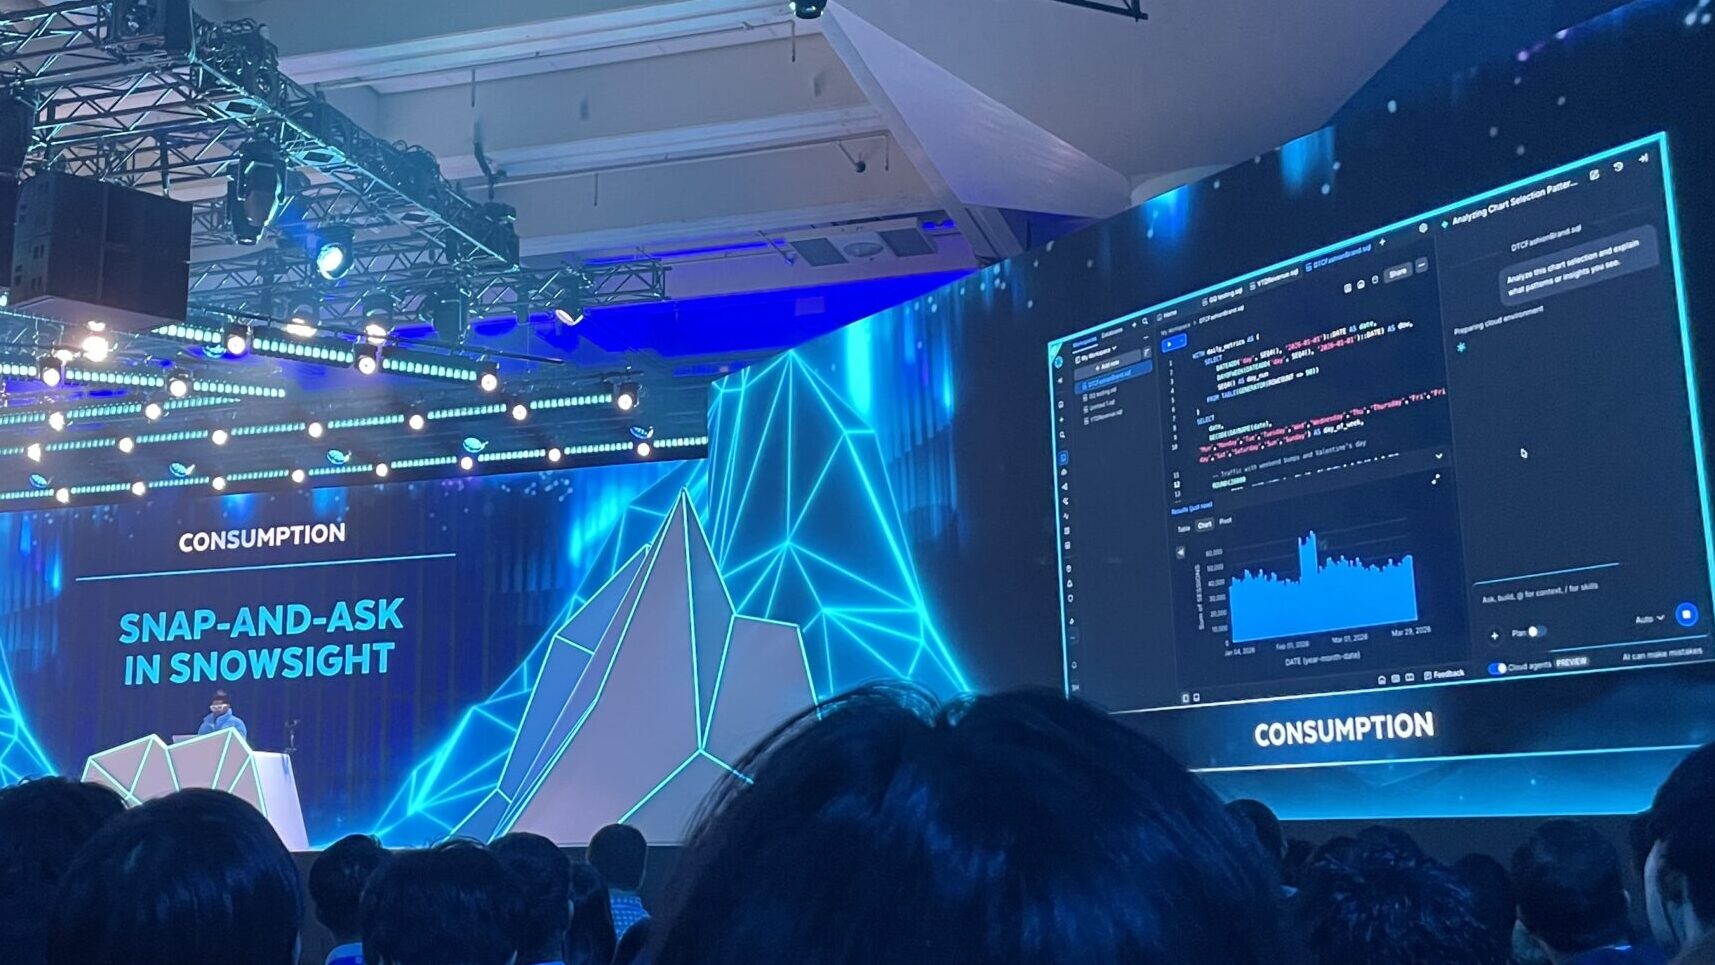
さらに、Snap and Askという機能も紹介されました。これは、画面上のグラフや表を選択し、その視覚的な文脈をCocoに渡して質問できる機能です。SQLやテーブル名を知らなくても、見えているダッシュボードを起点にAIへ質問できる点が実務的です。
後半では、Personal Work Engineも発表されました。ユーザーごとのAIアシスタントが、複数エージェント、ユーザー記憶、個人スキル、MCPコネクタ、定期タスクなどを統合して動く仕組みです。
今後のCoWorkは、単一のチャットボットではなく、個人の業務を継続的に支える作業エンジンに近づいていくと考えられます。
データ取り込みとストリーミングの強化
データ連携まわりでは、DataStreamの発表が目立ちました。
Snowflake DataStreamのインパクト
今回かなり重要な新機能がSnowflake DataStreamです。
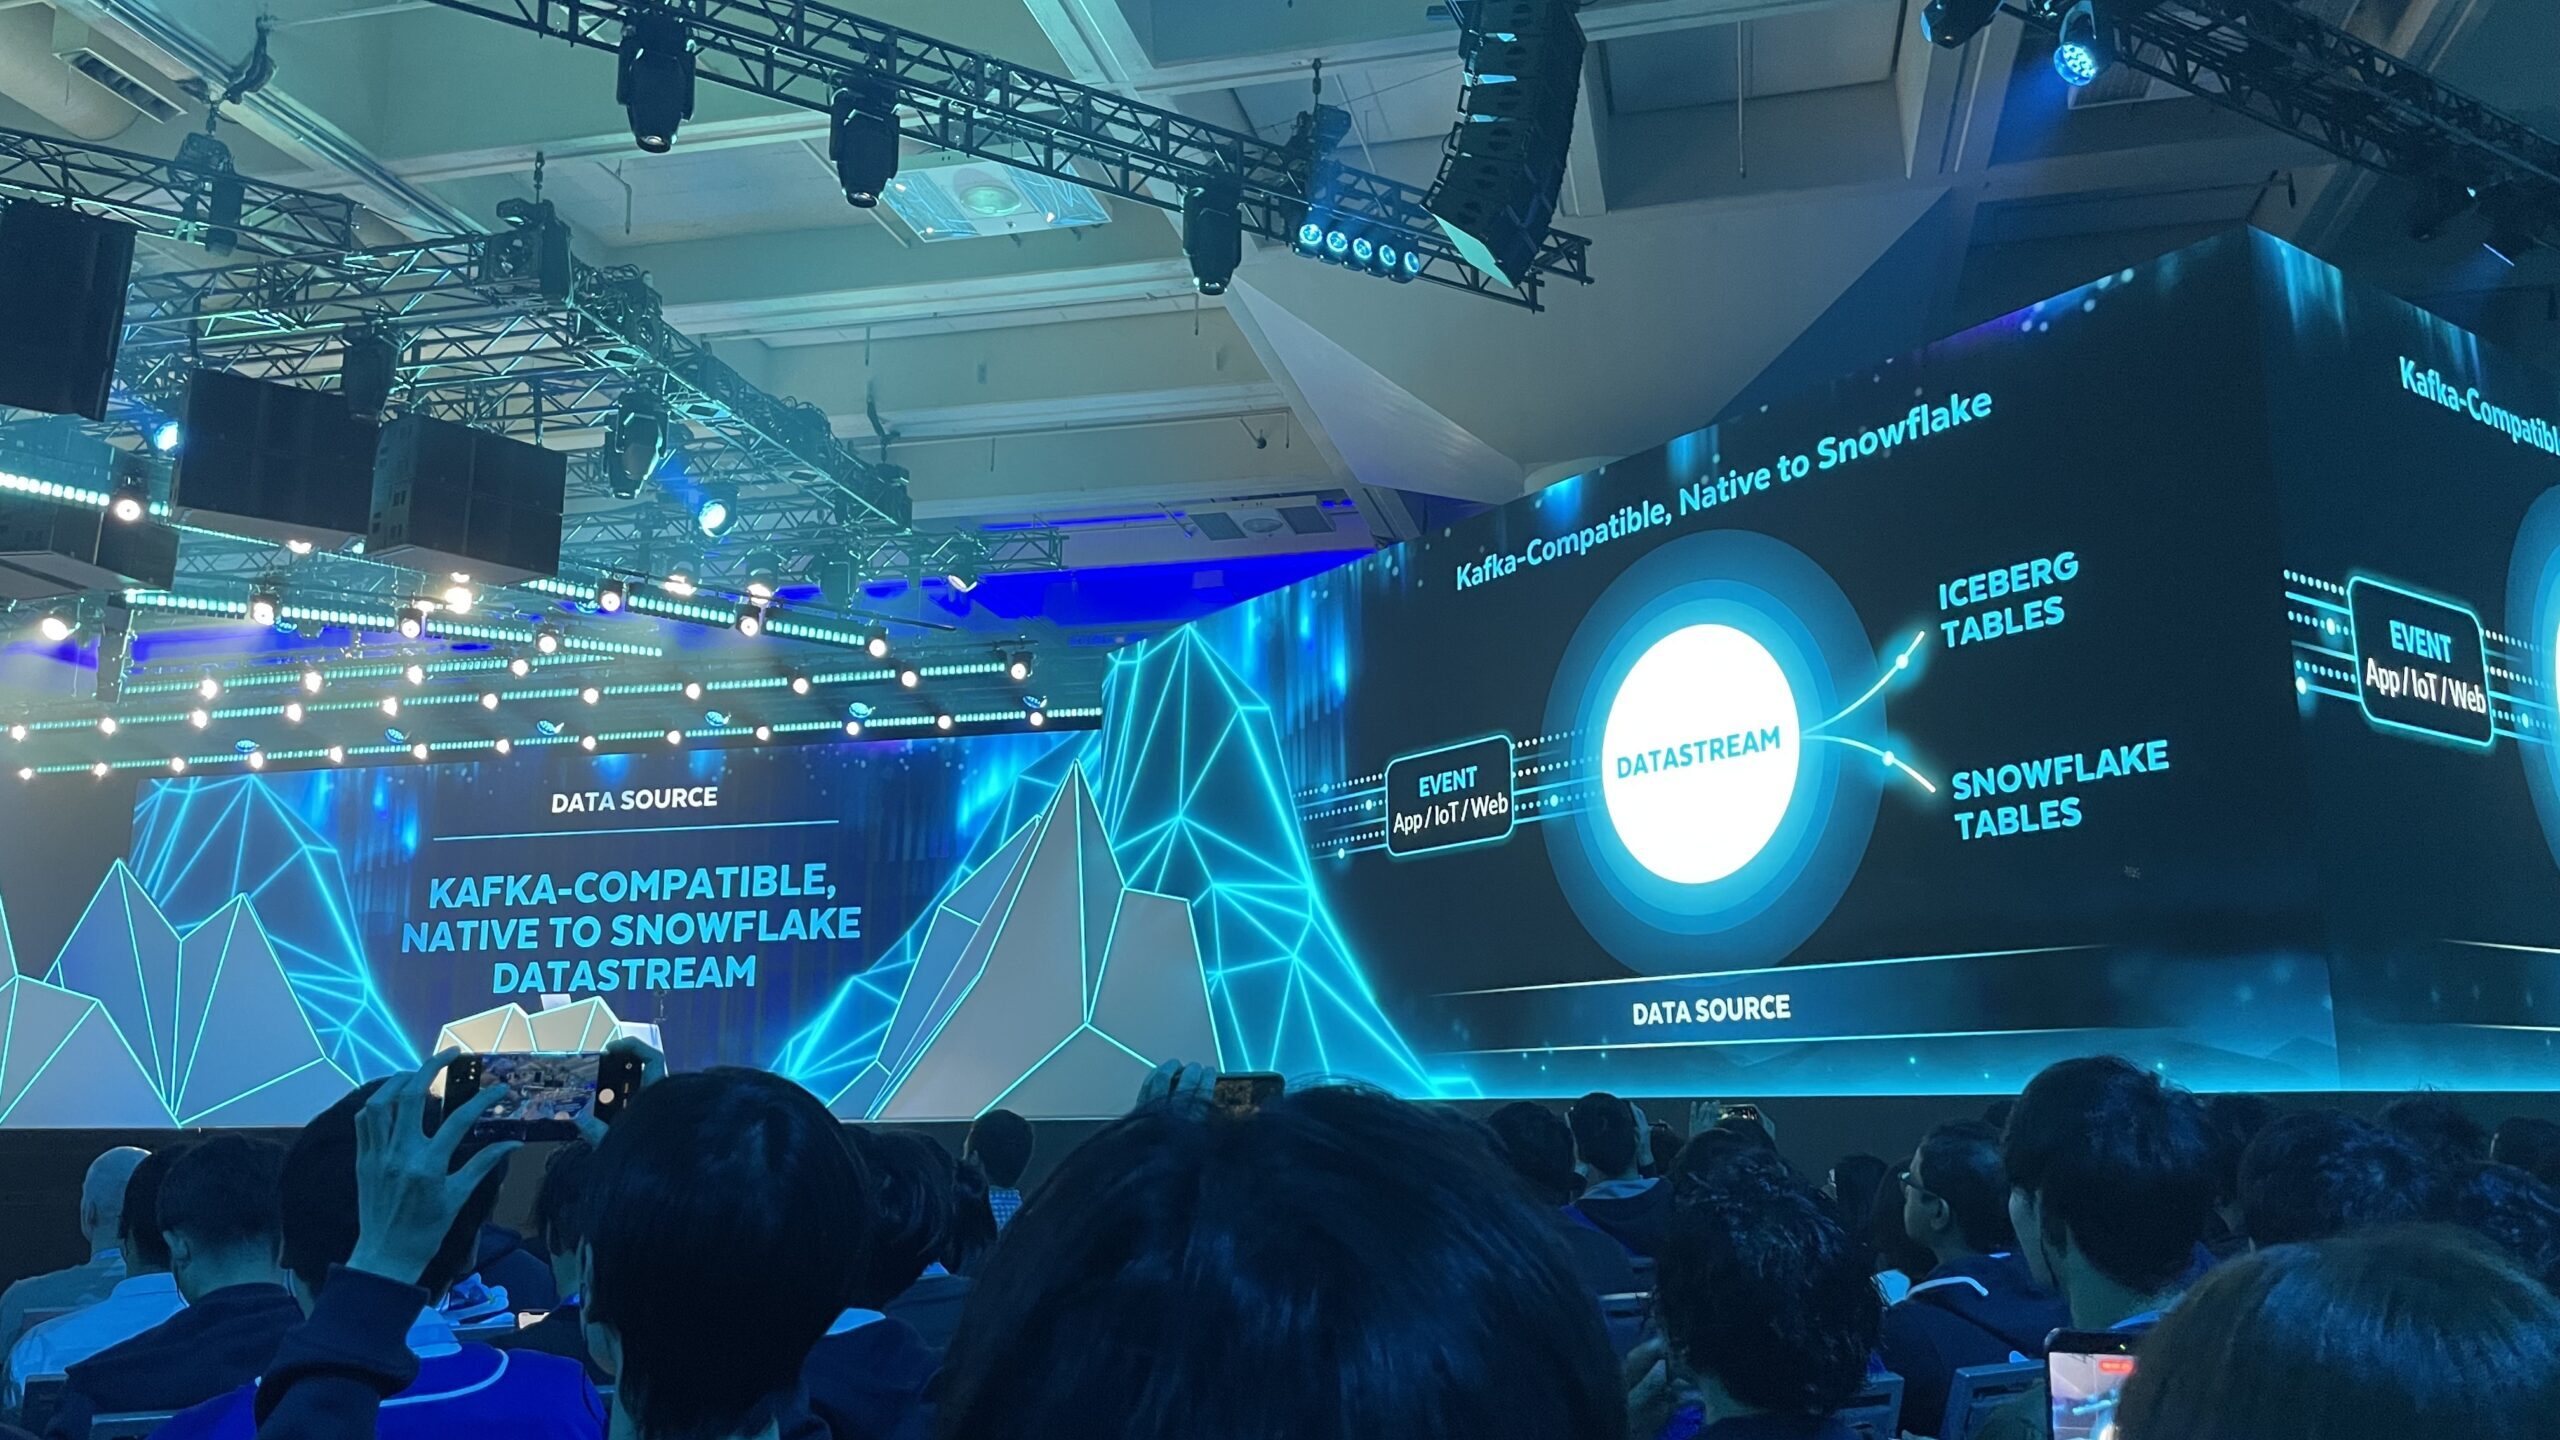
DataStreamは、Snowflakeに直接組み込まれたフルマネージドのストリーミングサービスとして紹介されました。Kafka wire compatible、Zero-copy streaming、サブ秒レイテンシ、トピックをSnowflakeテーブルとして扱えることなどが特徴です。
これまでKafkaなどの外部ストリーミング基盤を組み合わせていた領域に、Snowflakeがより深く踏み込む発表だと言えます。
Snowflakeはバッチ分析だけでなく、リアルタイム/イベント駆動のデータ基盤としての役割も強めようとしています。
Openflowのアップデートについて
OpenFlowについては、APIやプログラムから操作できるようにする発表がありました。これにより、データ連携の構成や運用をより自動化しやすくなります。
あわせて、Data Connectivity Proxyも紹介されました。これは、企業が外部データソースとSnowflakeをつなぐ際に、プライベート接続を使ってより安全に連携するための仕組みです。
OpenFlowのコネクタも拡張されています。Oracle、Veeva、MongoDB、Shopifyなどが紹介され、特にOracleコネクタはGAとして発表されていました。既存の業務システムにあるデータをSnowflakeへ取り込みやすくする狙いが見えます。
Postgres関連のデータ連携について
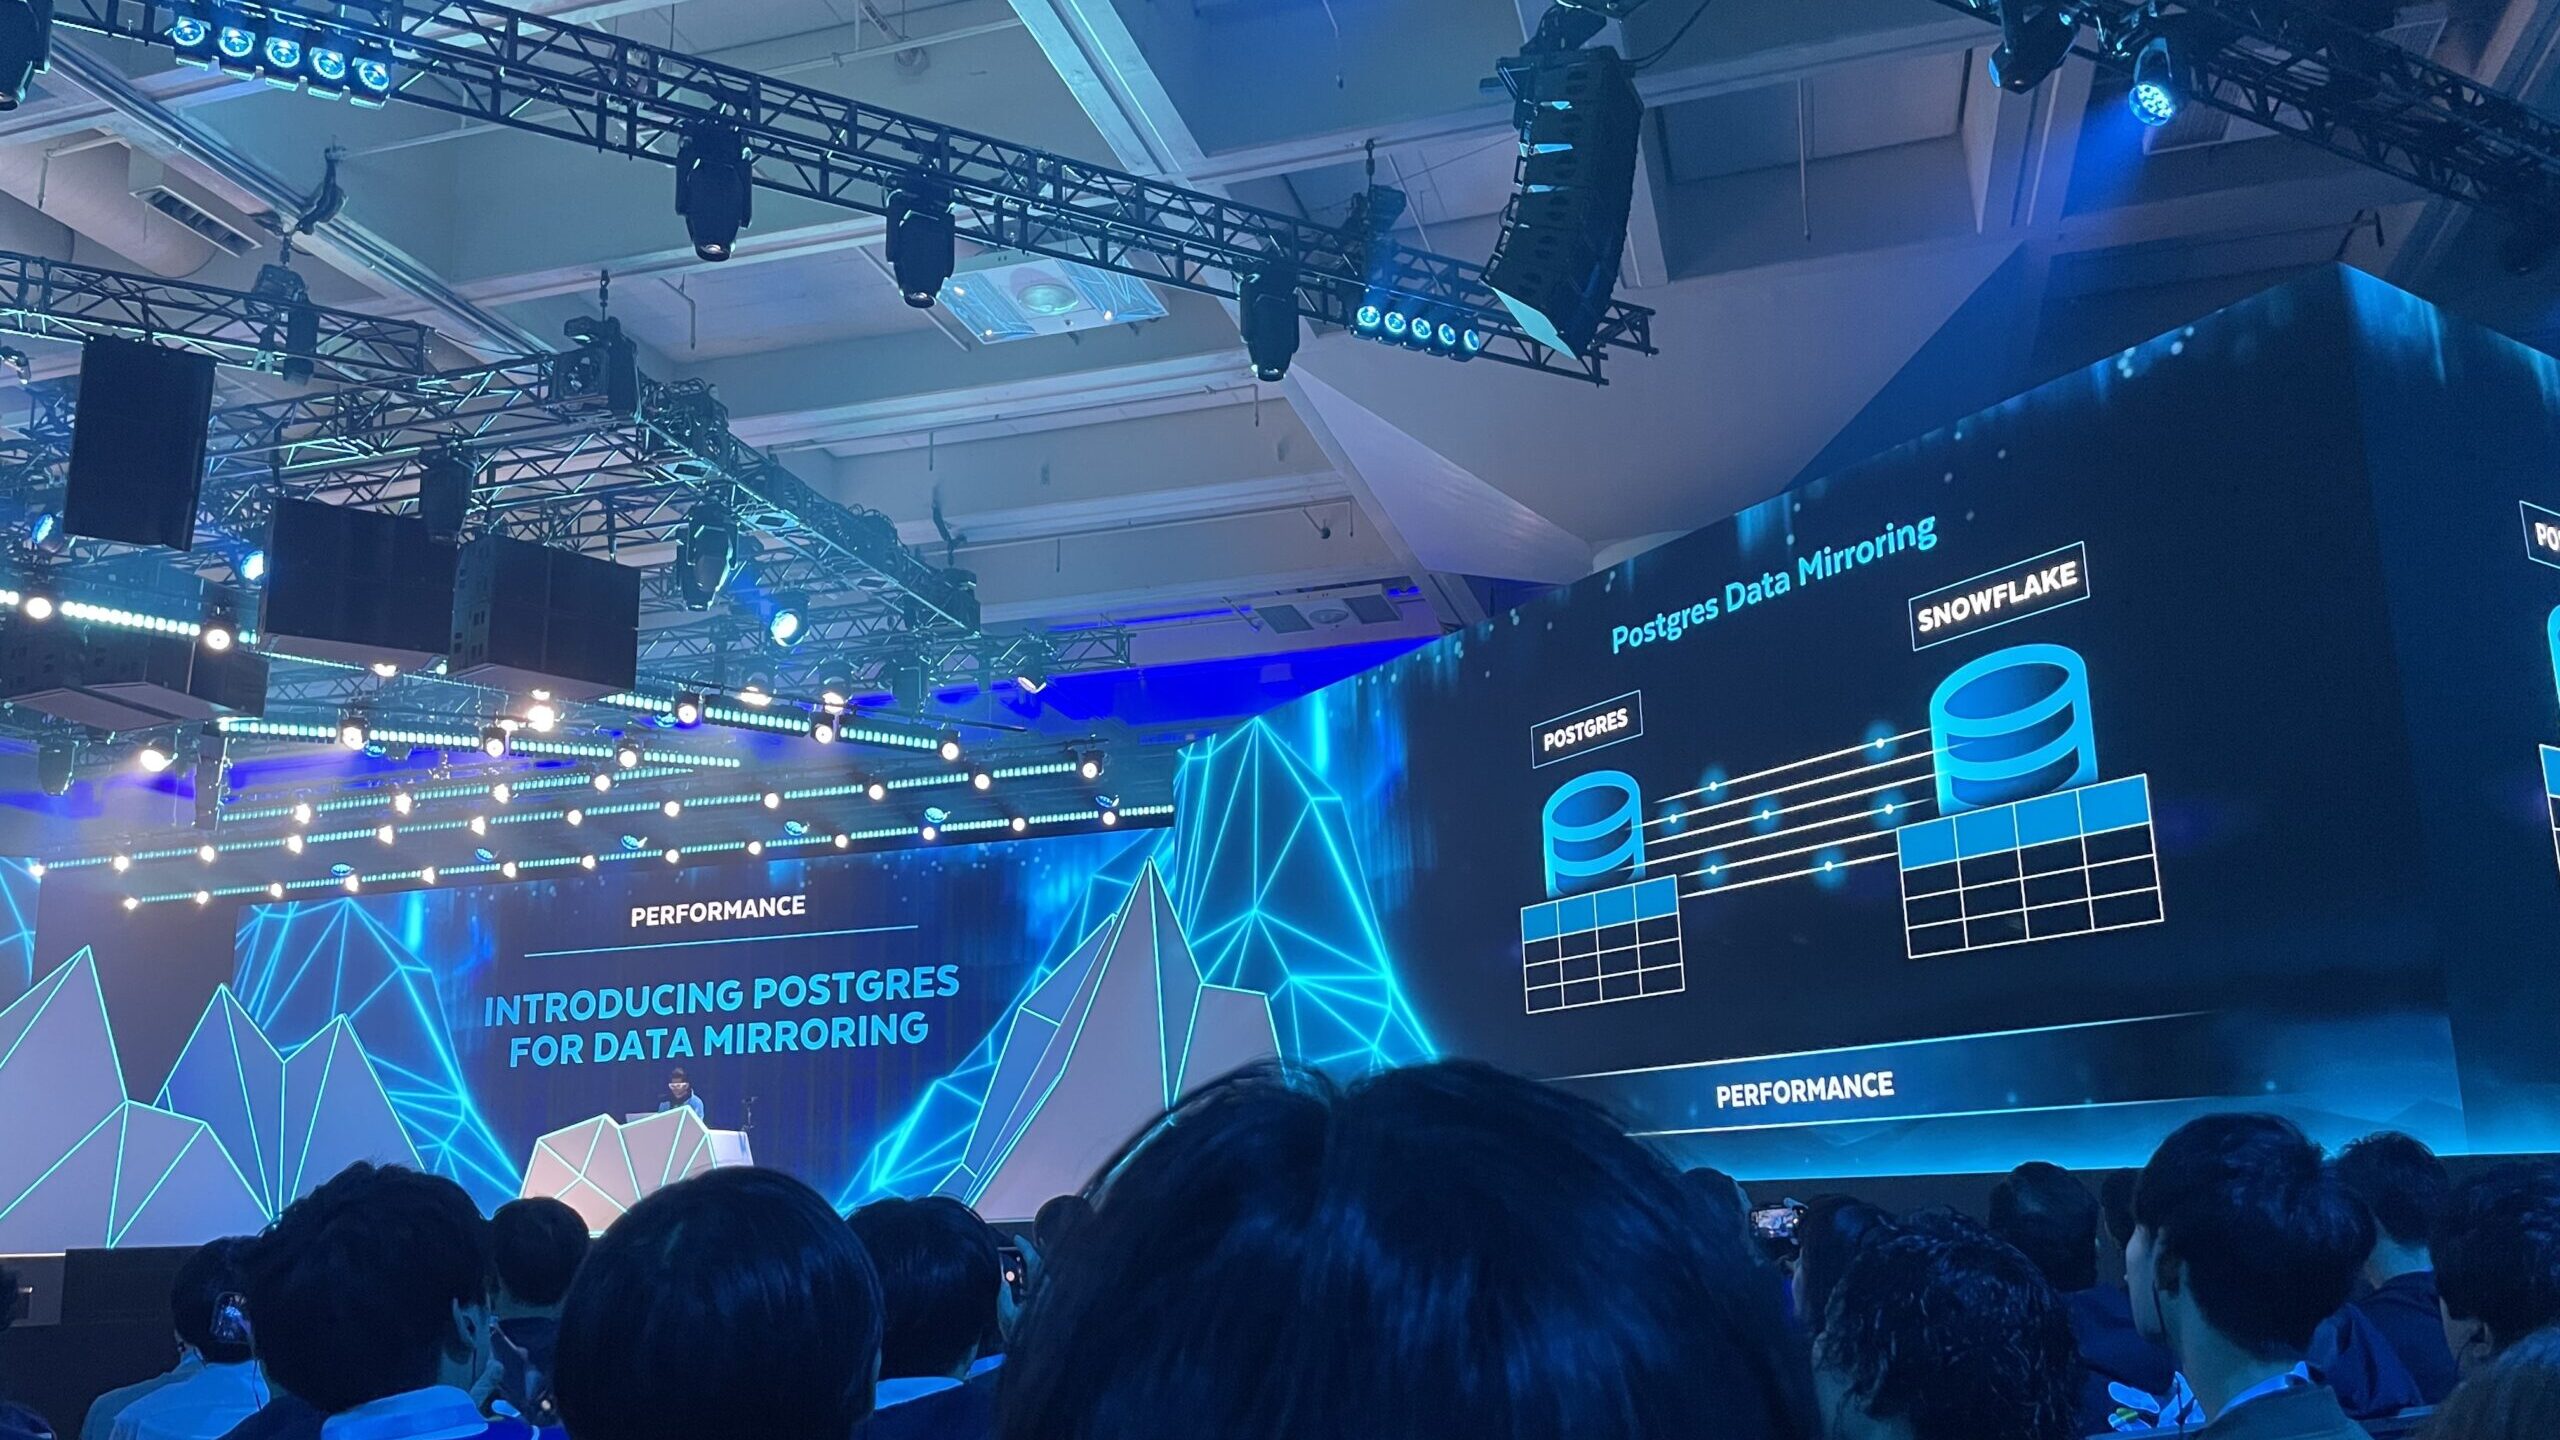
Postgres関連の機能追加もありました。Postgres Data Mirrorは、PostgresのテーブルをSnowflakeへ低レイテンシでミラーリングする機能です。業務DBとしてPostgresを使い続けながら、分析やAI活用はSnowflakeで行う構成が取りやすくなります。
CortexとAI / ML機能の拡張
AI関連では、Cortexの対応範囲が大きく広がっています。
AI Completeは、従来のテキスト中心の利用から、音声・動画も入力として扱える方向へ拡張されます。これにより、コールセンター録音の分析、会議動画の要約、顧客インタビューの分類、動画レビューの分析など、非構造データ活用の幅が広がります。
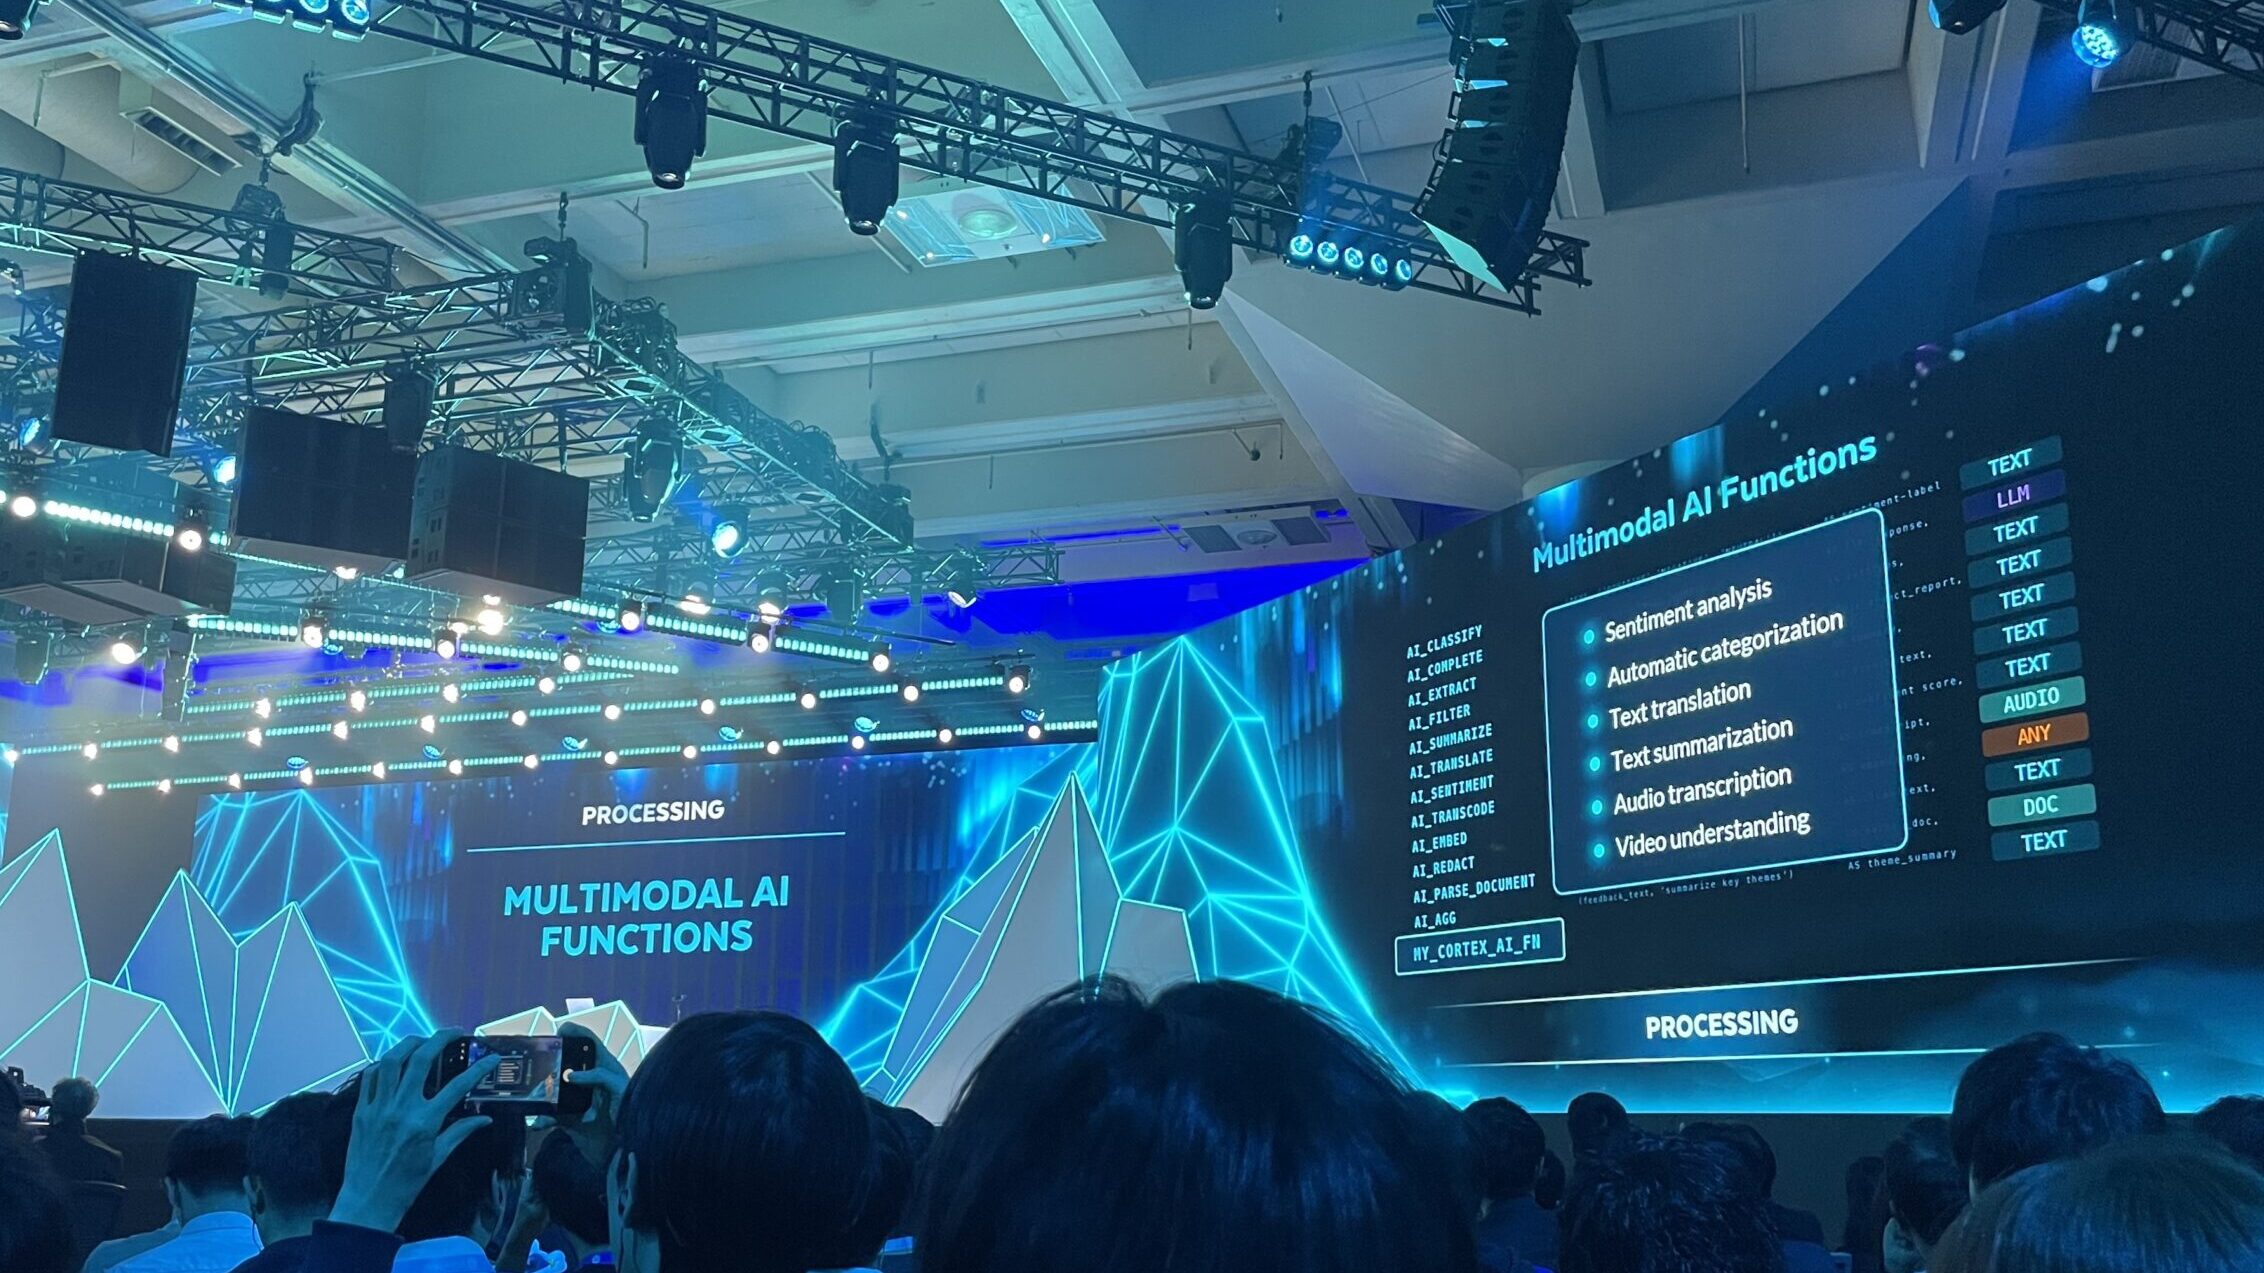
Cortex Functions Studioは、独自のAI関数を作成・評価・展開するための機能です。Snowflakeが用意したAI機能を使うだけでなく、企業ごとの業務要件に合わせてAI関数を作れるようになります。評価や品質確認の流れも含まれている点がポイントです。
モデル選択の面では、xAI/Grok系モデルのCortex対応も紹介されました。Snowflakeとしては、Claude、OpenAI、Gemini、xAI系、オープンソースモデルなどを、用途・コスト・性能に応じて選べる方向を強めています。
Agentic SearchとCode Bundles
Agentic Searchも注目度の高い機能です。
従来のRAGのように、関連文書を探して要約するだけではなく、非構造データから必要な情報を抽出し、構造化し、分析クエリのように正確な回答を返すことを目指しています。
たとえば契約書、請求書、メール、議事録、規制文書などに対して、「2025年に締結された契約はいくつあるか」といった質問に、より精密に答える用途が想定されます。
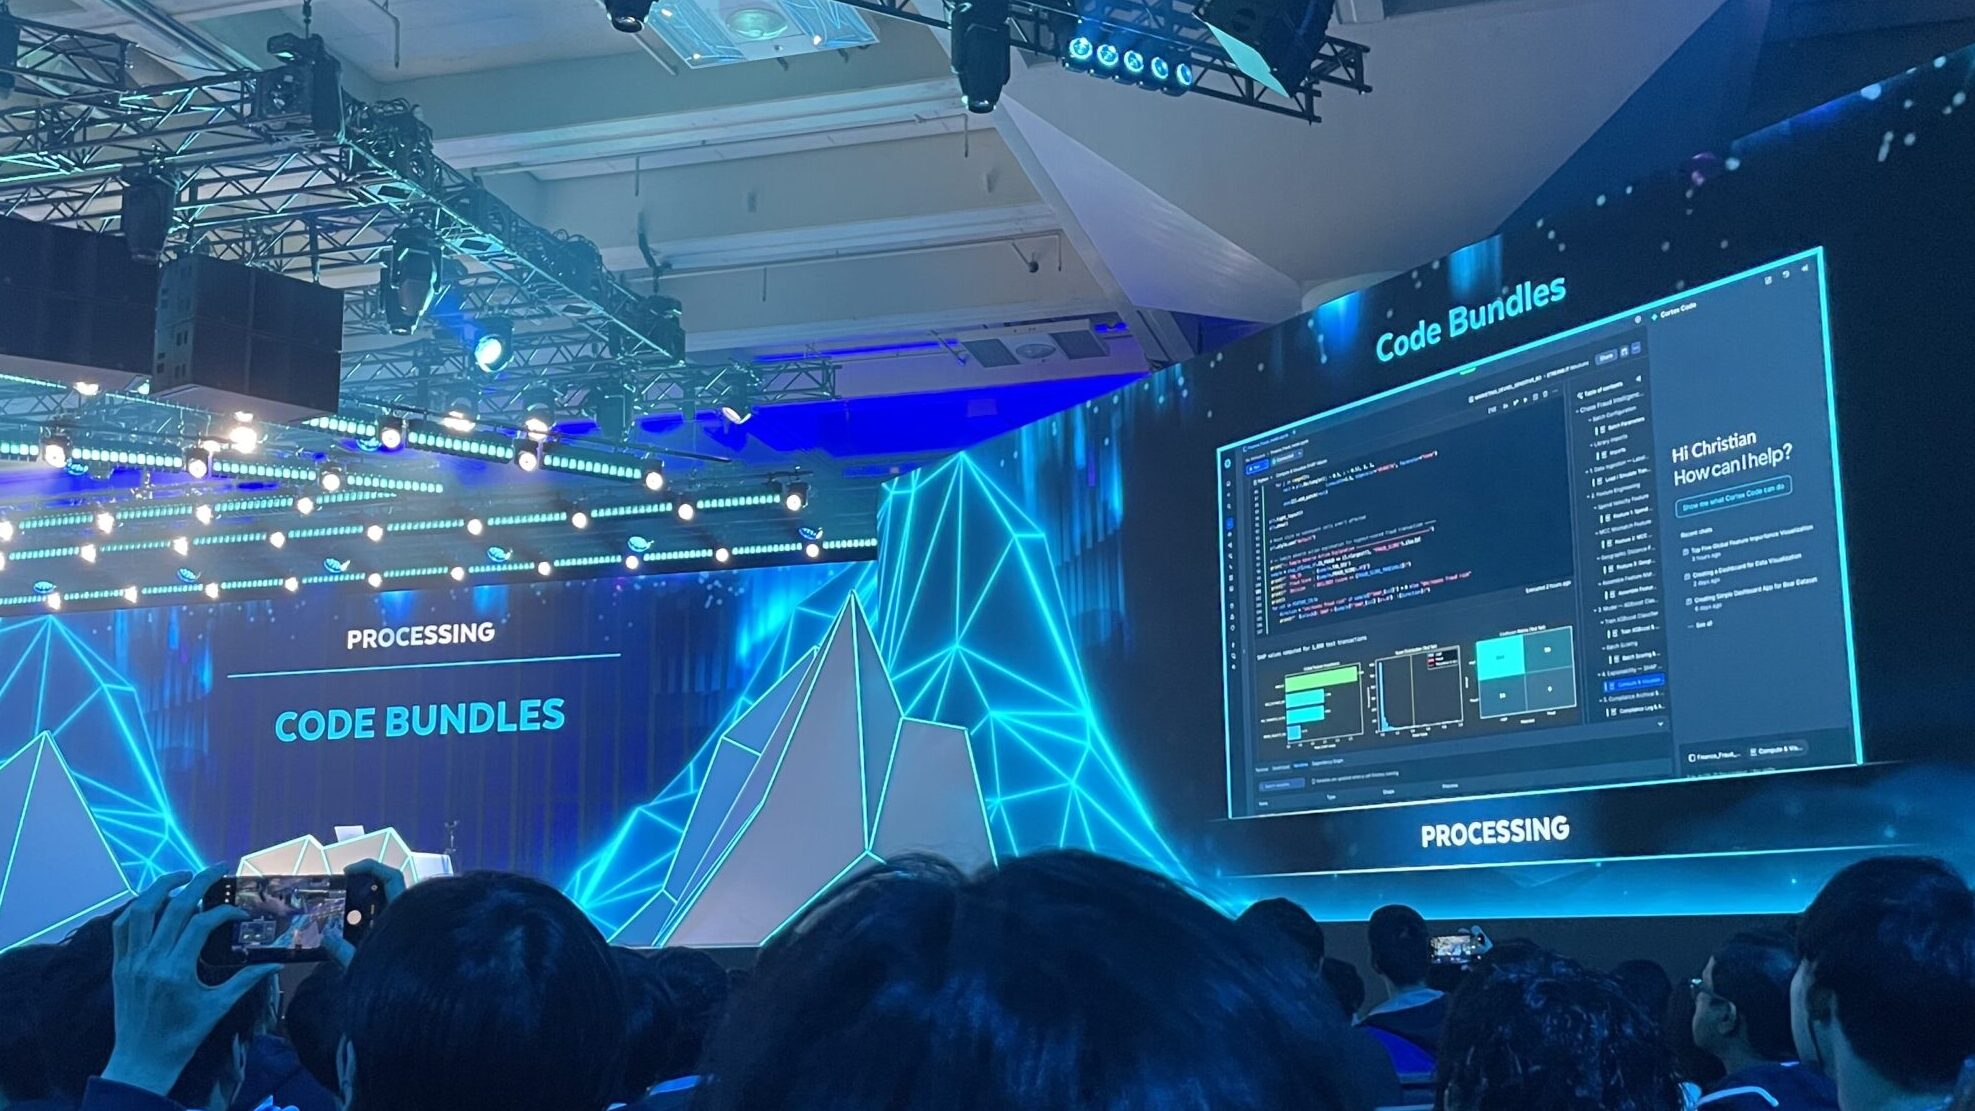
開発者向けには、Code Bundlesも大きな追加機能です。PythonやJavaのコードを、余計なラッピングなしでSnowflake上にデプロイ・実行できるようになります。既存コードをSnowflakeへ持ち込み、SQLから実行したり、スケジュール実行したりする流れが簡単になります。
機械学習領域では、Cortex Trainも発表されました。Snowflake上で基盤モデルのカスタマイズ、教師ありファインチューニング、強化学習を行うためのフルマネージド機能です。Snowflakeは推論だけでなく、モデルの調整や学習の領域までカバーしようとしています。
そのほか、Streaming FeaturesのGA、数十ミリ秒レイテンシでの特徴量提供、オンラインA/Bテスト、VS Code拡張やCursor対応と思われる開発環境連携も紹介されました。リアルタイムMLや本番環境でのモデル検証を進めるための機能追加です。
パイプライン開発とアプリ開発の体験改善
データパイプラインとアプリ開発の領域でも、Snowflake上で完結できる範囲が広がっています。
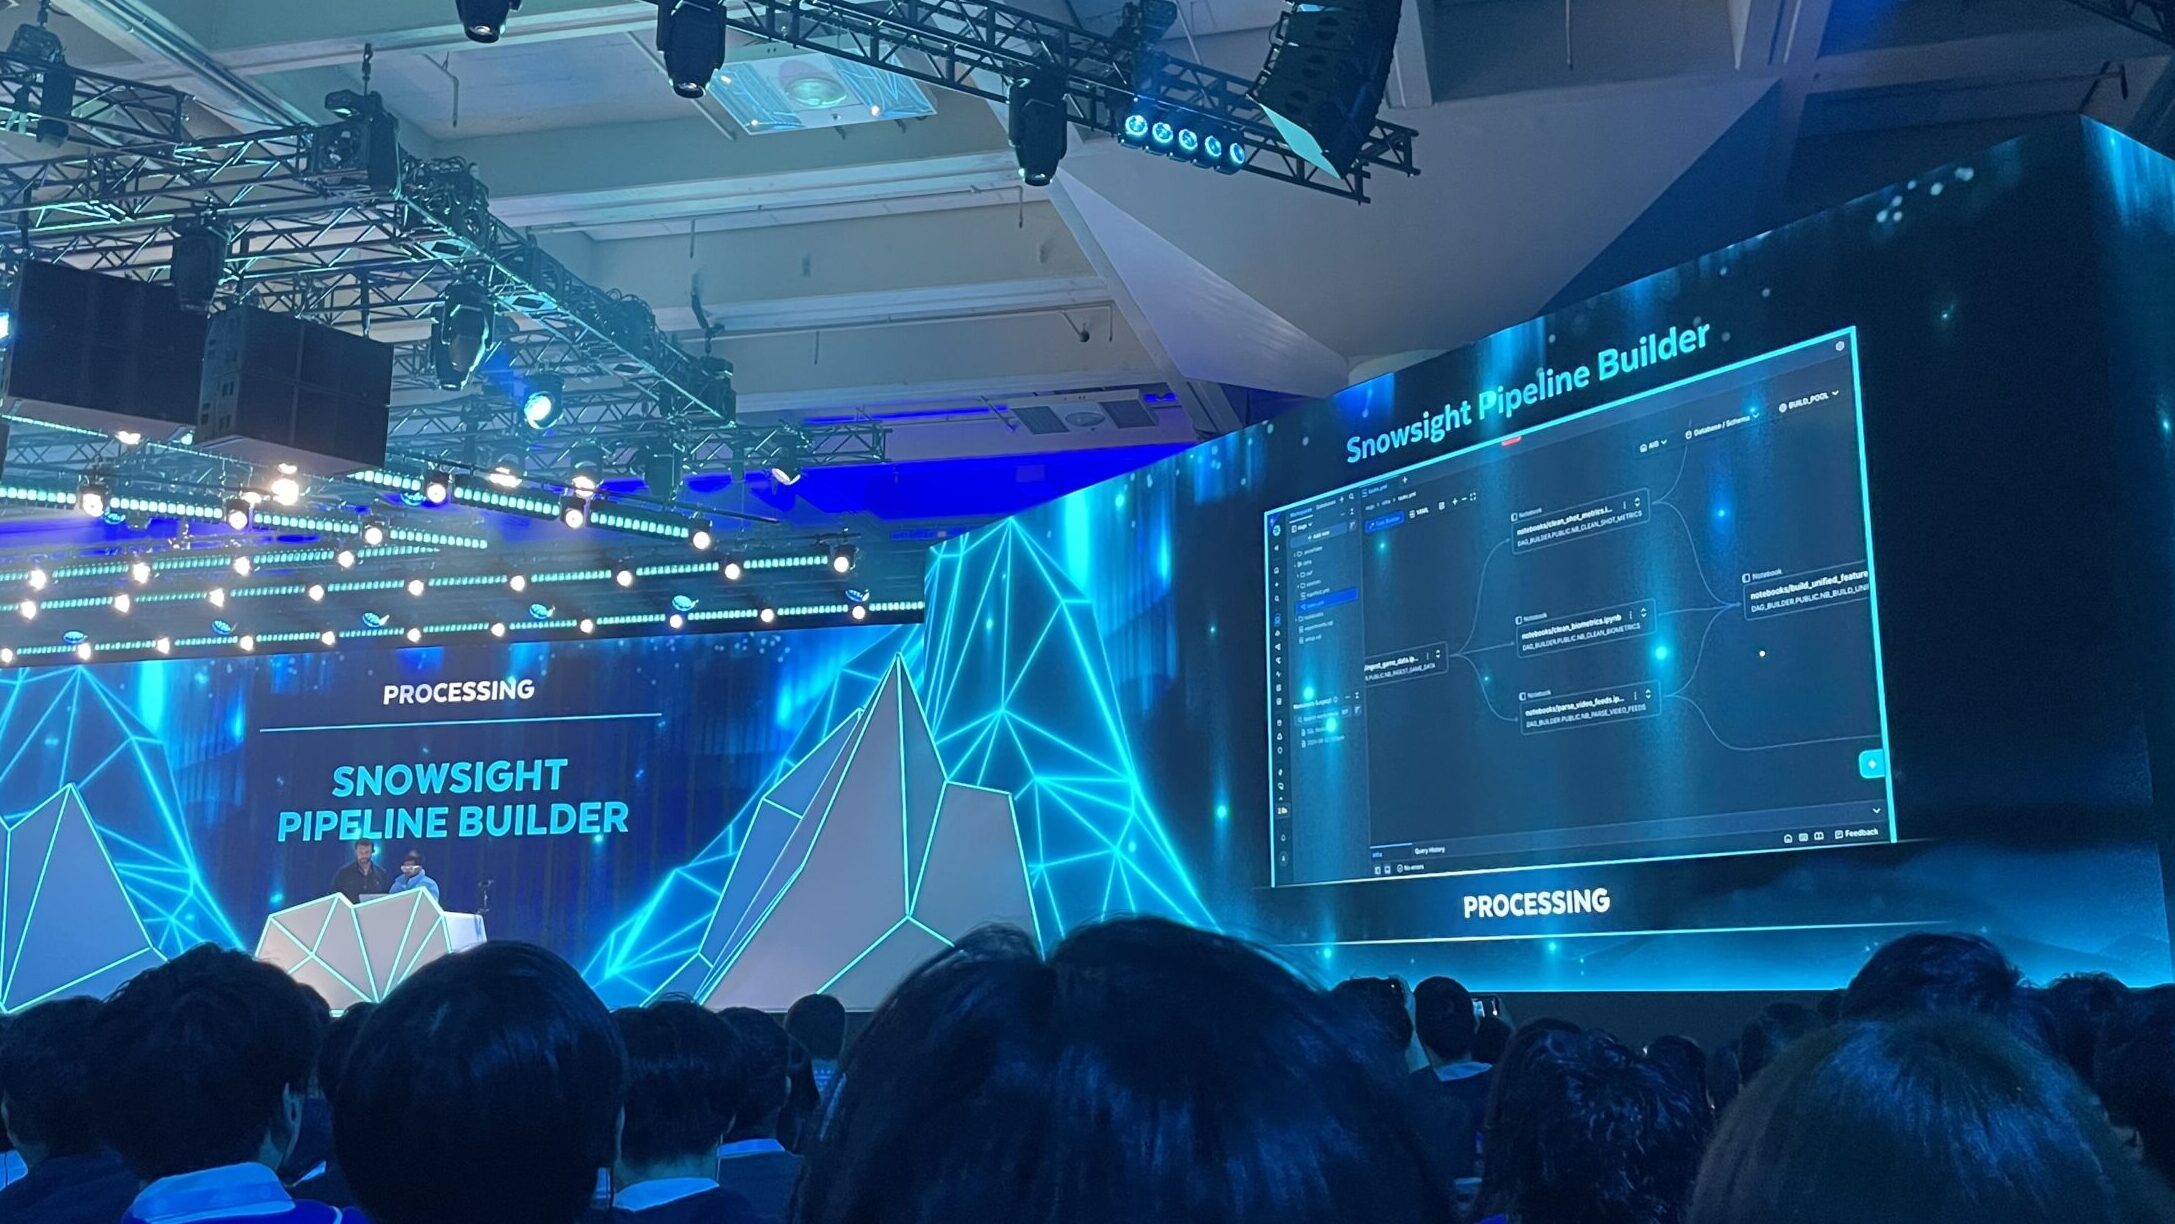
Snowsight Pipeline Builderは、Snowsight上でデータパイプラインを視覚的に作成・編集・修正・デプロイできる機能です。SQLやコード中心だったパイプライン開発に、ビジュアルな開発体験が加わります。
Streamlit hosted in SnowflakeはGAとして紹介されました。Snowflake内でStreamlitアプリをホストでき、ワークスペース統合、Git連携、コンテナ実行の高速化・低コスト化なども強化されています。Snowflake上のデータを使った業務アプリを作りやすくする発表です。
Snowflake App Runtimeも重要です。Node.jsに対応し、今後Pythonも含めて、より自由度の高いアプリケーションをSnowflake上で動かせるようになります。Streamlitよりも自由にUIやアプリケーション構成を作りたい場合に使う選択肢になりそうです。
Coco DesktopのGAも紹介されました。SnowsightやCLIだけでなく、デスクトップアプリとしてCocoを利用できるようになります。デモでは、Coco Desktopからアプリ構築の計画を作り、実装まで進める流れが示されていました。
AIエージェント時代のガバナンスとセキュリティ
AIエージェントがデータや業務アプリにアクセスするようになると、ガバナンスとセキュリティの重要性はさらに高まります。2日目のキーノートでは、この領域にも多くの発表がありました。
Intent-driven Governanceは、今回の中でも特に重要な機能です。管理者が細かなポリシーをひとつずつ書くのではなく、「このデータベース内のPIIをすべて保護して」のように意図を伝えると、データ分類、PII検出、ポリシー作成、継続的な適用を自動化する考え方です。
Horizon AI Guardrailsは、AIやエージェントに対する安全対策です。Jailbreak、Prompt injection、高リスクな操作、不適切なエージェント挙動などを防ぐための機能として紹介されました。
Agent Identityは、ある操作が人間によるものなのか、AIエージェントによるものなのかを識別できる機能です。これにより、エージェントの場合は見せる情報を制限する、追加承認を求める、特定データにはアクセスさせないといった制御が可能になります。
Data Movement Policiesも実務上かなり重要です。機密データを外部ステージへ出せないようにする、ダウンロードを禁止する、内部ステージへの移動を制限するなど、データの持ち出しをポリシーで制御できます。
AIエージェントがファイルを生成・エクスポートする時代には、こうした制御が欠かせません。
Trust Centerも強化されます。異常なデータ転送、AIセキュリティ、Guardrails設定、エージェント構成のベストプラクティスなどを一元的に確認できる方向です。
Multi-party Approvalsは、高リスク操作に対して複数人承認を必須にする機能です。MFAの無効化、保持設定の変更、機密ポリシーの変更、管理者権限に関わる操作などを、1人だけでは実行できないようにできます。
Horizon Contextも重要な追加機能です。データの信頼度、利用状況、指標定義、BIツール上での文脈などを、Coco、CoWork、Cortex Agentsへ渡す基盤です。
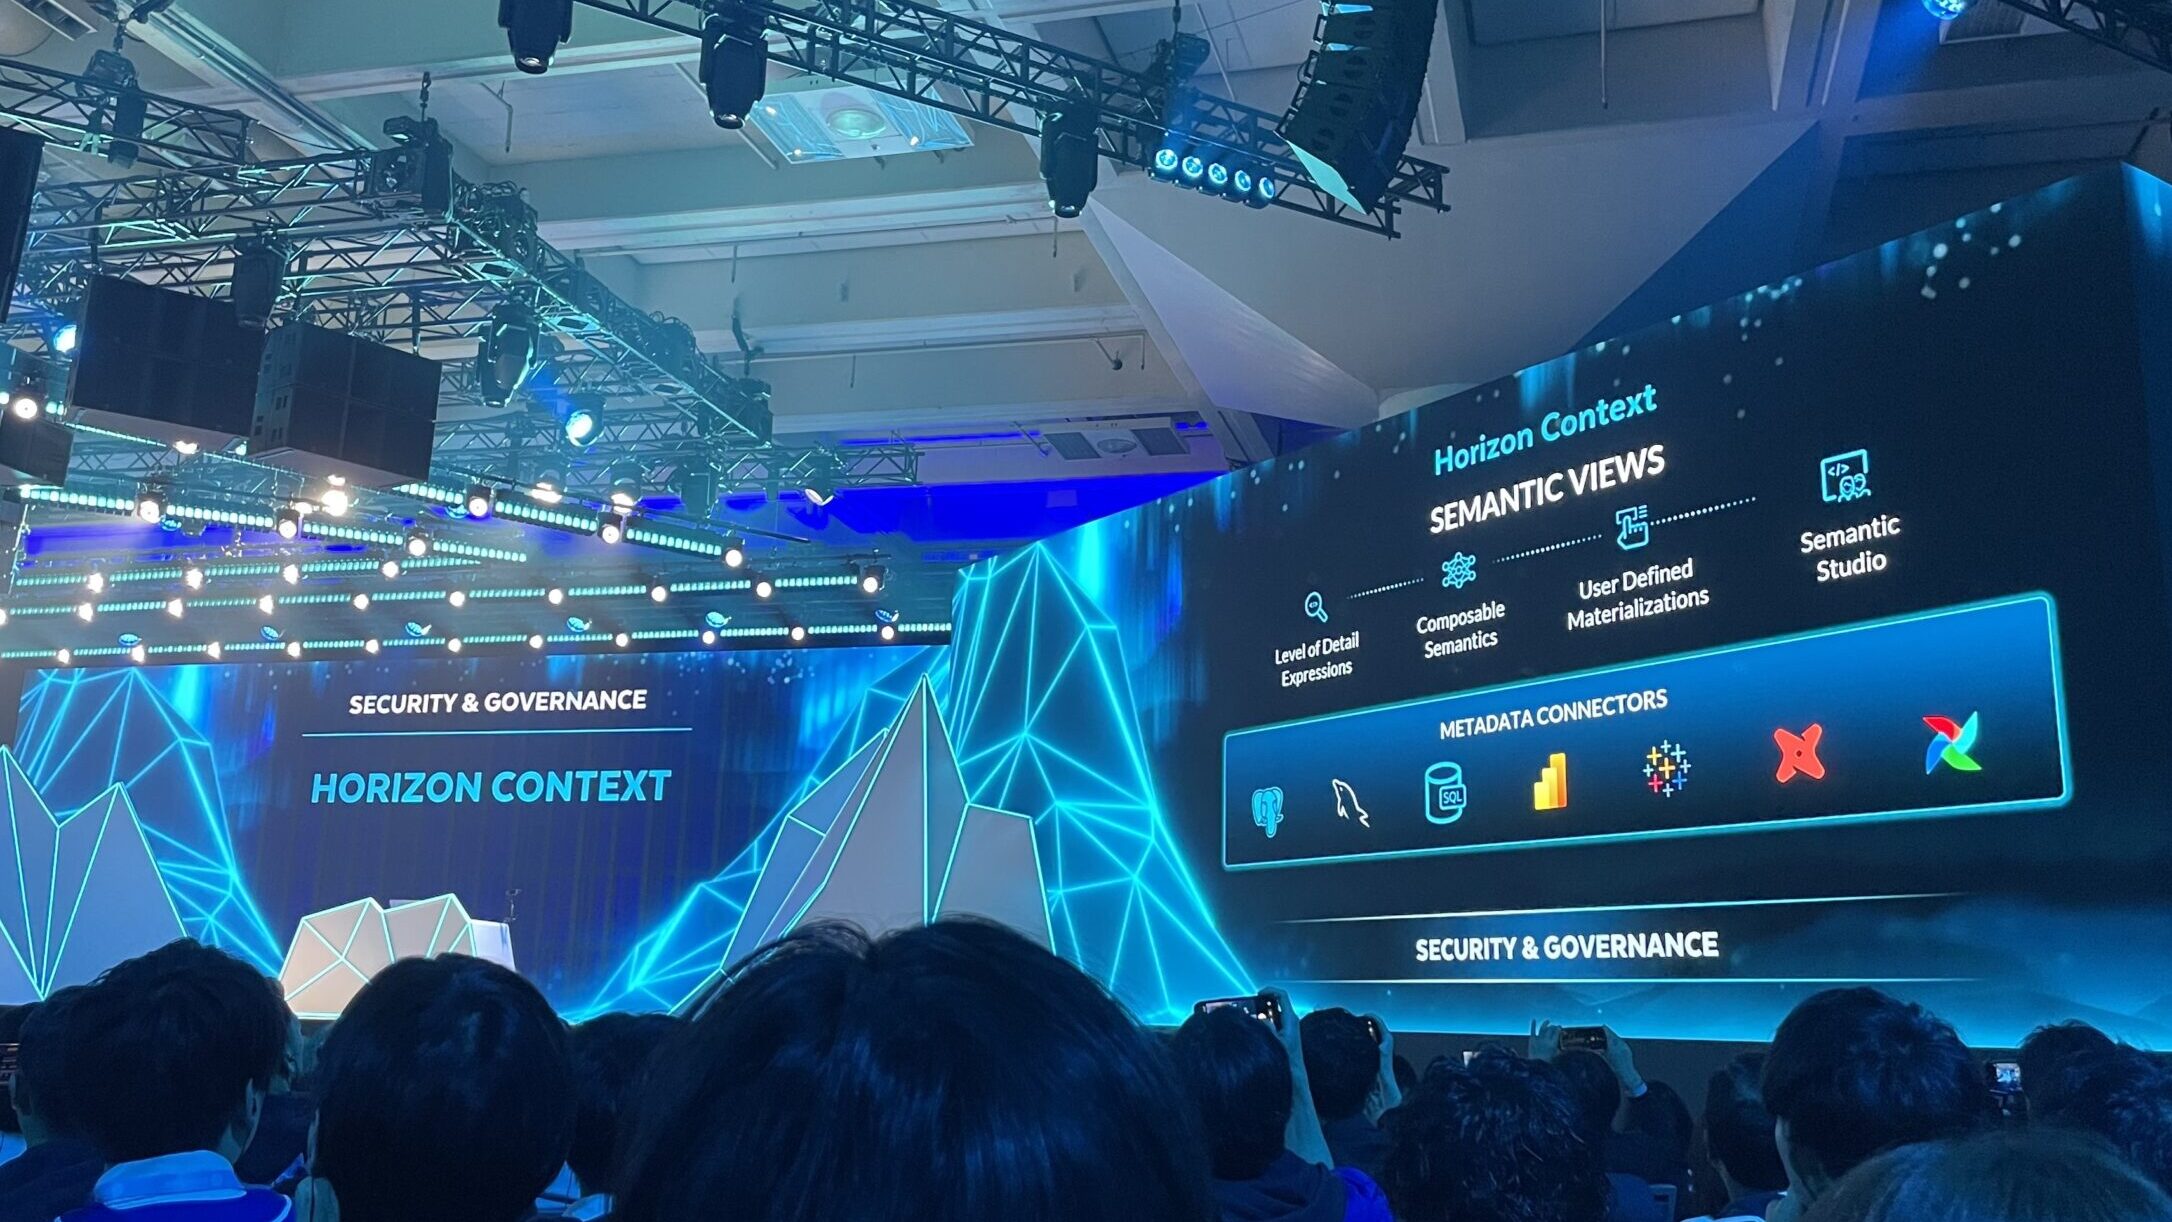
AIの回答精度を高めるには、単にデータがあるだけでなく、そのデータがどう使われ、どのような意味を持つかという文脈が必要になります。
パフォーマンス・運用基盤の強化
運用基盤やパフォーマンス面でも、複数の機能追加がありました。
Adaptive Computeは、ワークロードに応じてコンピュートリソースを自動調整する次世代コンピュートとして紹介されました。パフォーマンス向上、コスト効率改善、運用負荷の削減が狙いです。
Interactive Compilerは、新しいクエリコンパイラです。クエリ実行そのものだけでなく、コンパイル時間を短縮することで、ダッシュボードや対話的分析の体感速度を改善します。
UniStore / Hybrid Tablesについては、エンジン最適化による性能強化が紹介されました。レイテンシとスループットの改善により、過去に性能面で見送ったケースでも再評価する価値がありそうです。
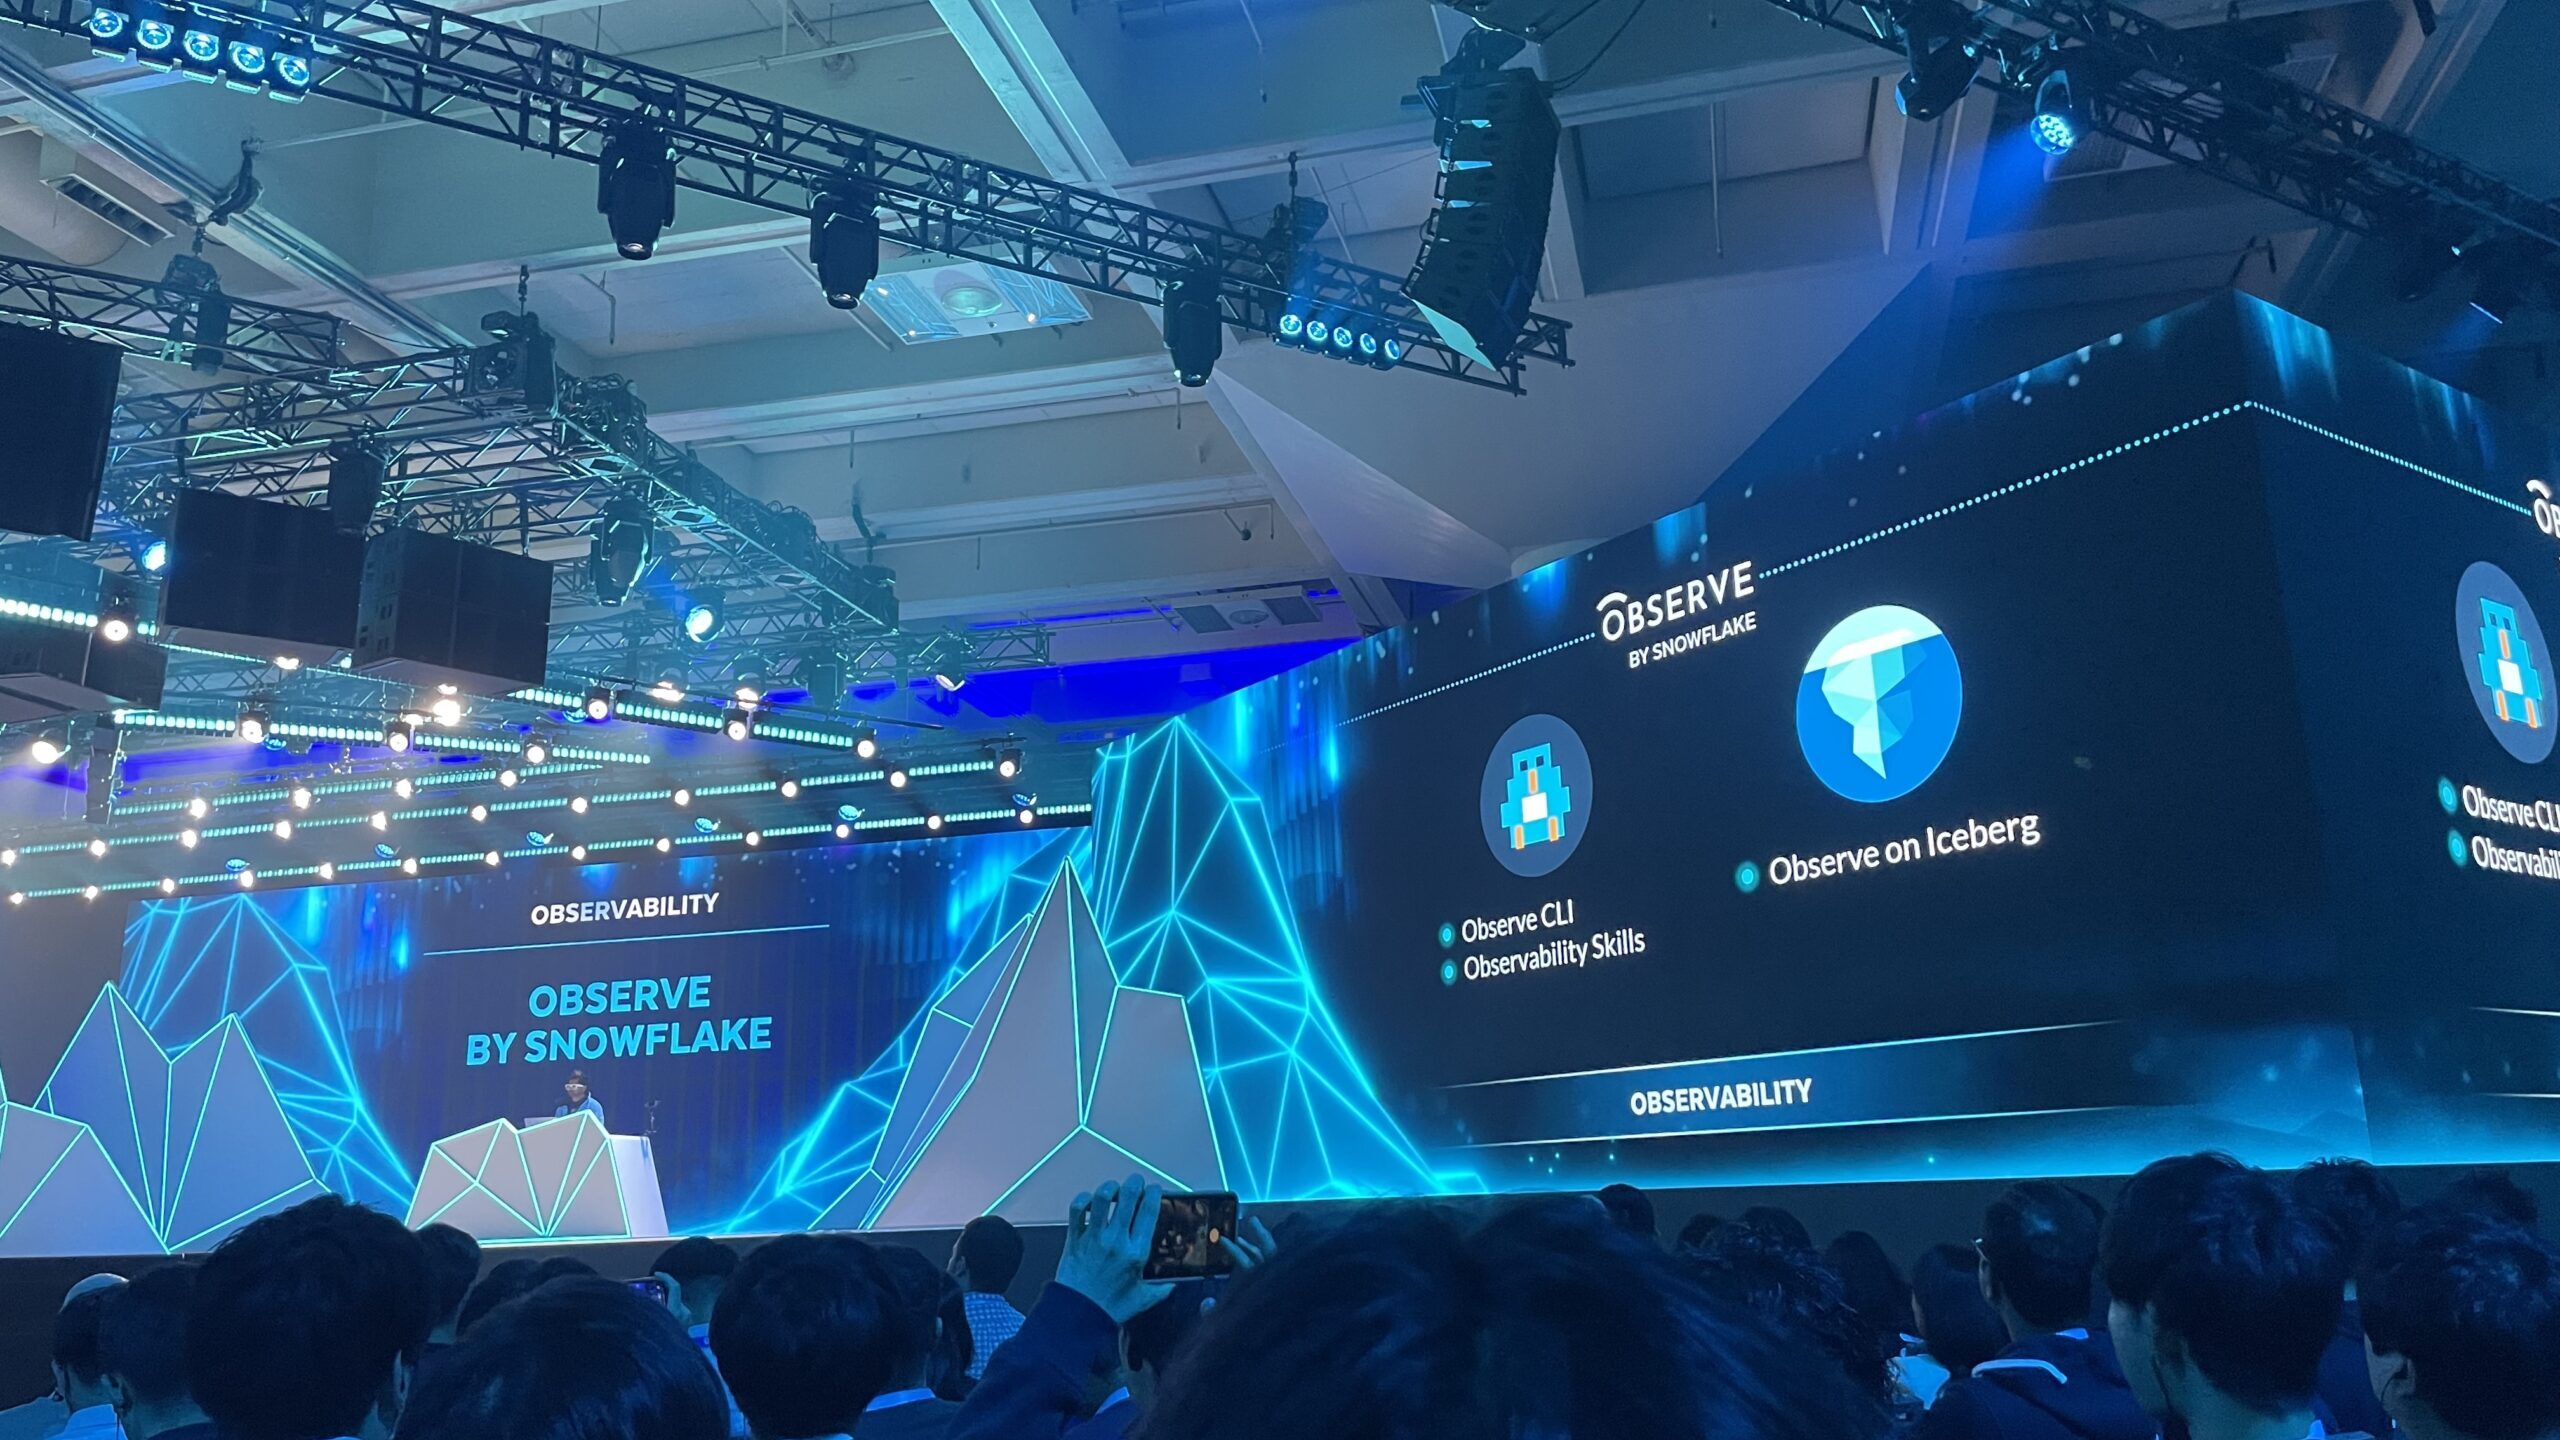
Snowflakeが買収したObserveの統合も発表されました。ログ、APM、インフラ監視をSnowflakeネイティブに統合し、CLIやCoco連携によってアラート調査やトリアージを支援します。
AI利用が広がる中で、コストガバナンスも強化されています。AIコストをBudgetで管理する機能、ユーザー別クォータ、共有Warehouseでのコスト配賦、予算閾値到達時のカスタムアクションなどが紹介されました。
Business Continuityの強化もありました。ログベースの高速レプリケーション、SLA-backed RPO assurance、フェイルオーバー時のデータギャップ保証などが追加され、ミッションクリティカルな基盤としての信頼性を高めています。
オープン性とデータ共有の拡張
Snowflakeは、オープン性や外部ツールとの相互運用性も強く打ち出しています。
Apache Icebergへの対応は、今回も大きく扱われました。Iceberg仕様への対応、REST Catalogインターフェース、Snowflake管理のIceberg Tables、外部カタログとの双方向読み書きなどが紹介されています。
Snowflakeに閉じ込めるのではなく、オープンテーブル形式との相互運用を強化する方向です。
Open Semantic Interchangeは、BIツールやAIエージェントが同じ意味定義を共有できるようにする取り組みです。売上、粗利、アクティブユーザー、解約率、LTVなどの指標定義がツールごとにズレる問題を防ぐ狙いがあります。
Data Sharingも拡張されています。AI-ready listingsでは、データリスティングにセマンティックビューやエージェントを紐づけ、Cortex Agentsで使いやすくします。
ResharingはGAとして紹介され、受け取ったデータを条件付きで他者へ再共有できるようになります。Open Sharingでは、Snowflakeを使っていない相手にも、IcebergやREST Catalog経由でデータ共有できるようにする方向が示されました。
Multi-party Collaborationは、複数企業・複数チームが1つのセキュアな環境で共同作業できる仕組みです。パートナー企業との共同分析や、データ共有を前提にした業務コラボレーションで使われる機能になりそうです。
Zero-copy Partnershipsも拡張されています。Salesforce、Workday、IBM watsonx.data、Aviva Connect、SAPなどとの連携が紹介され、特にSAP連携はGAとして扱われていました。業務アプリのデータをコピーせずにSnowflakeから活用し、AIや分析につなげる方向です。
まとめ
2日目のキーノートは、Snowflakeを「データを保管・分析する場所」から、「AIエージェント、アプリ、リアルタイムデータ、ガバナンスをまとめて動かす業務実行基盤」へ進化させるための新機能・機能追加が中心でした。
特に注目したいのは、以下のポイントです。
- CoWorkとPersonal Work Engineにより、AIエージェント活用が個人・チームの業務に近づく
- DataStreamにより、Snowflakeがリアルタイム/イベント駆動のデータ基盤へ広がる
- Agentic SearchとAI Completeの拡張により、契約書、音声、動画などの非構造データ活用が進む
- Code BundlesとApp Runtimeにより、既存コードや独自アプリをSnowflake上で動かしやすくなる
- Intent-driven Governance、Agent Identity、Data Movement Policiesにより、AIエージェント時代の統制が強化される
- Iceberg、Open Sharing、Zero-copy連携により、Snowflake外のデータや外部ツールとの相互運用性が広がる
全体として、SnowflakeはAI時代のデータ基盤から一歩進み、業務アプリ、AIエージェント、リアルタイムデータ、ガバナンスを統合するプラットフォームへ進化しようとしていることがよく分かる発表でした。
公式の公開動画はこちらからどうぞ