Session report: Power Analytics and Al Wherever You Data Lives
こんにちは中村です。
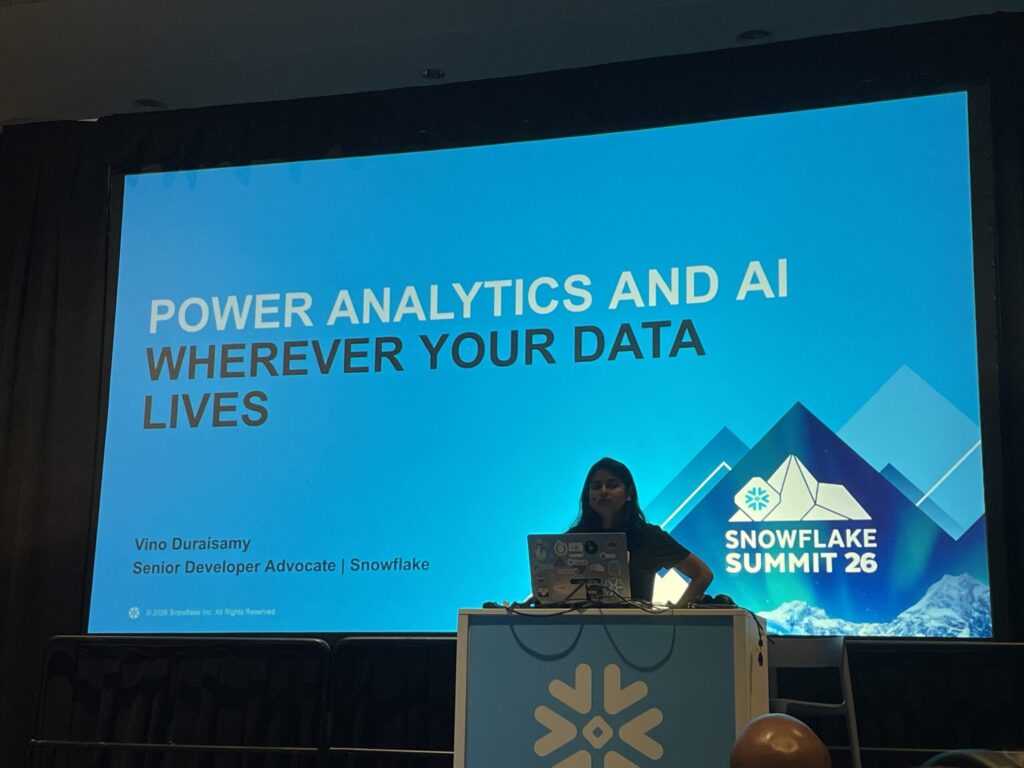
Snowflake Summit 26 で参加したハンズオンセッション「Power Analytics and AI Wherever Your Data Lives」をレポートします。登壇者は Snowflake の Senior Developer Advocate である Vino Duraisamy 氏。セッションは Overview → Hands-on Lab → Q&A という構成で進みました。
目次[非表示]
なぜ今 Iceberg なのか
スケールの要求がアーキテクチャを圧迫している
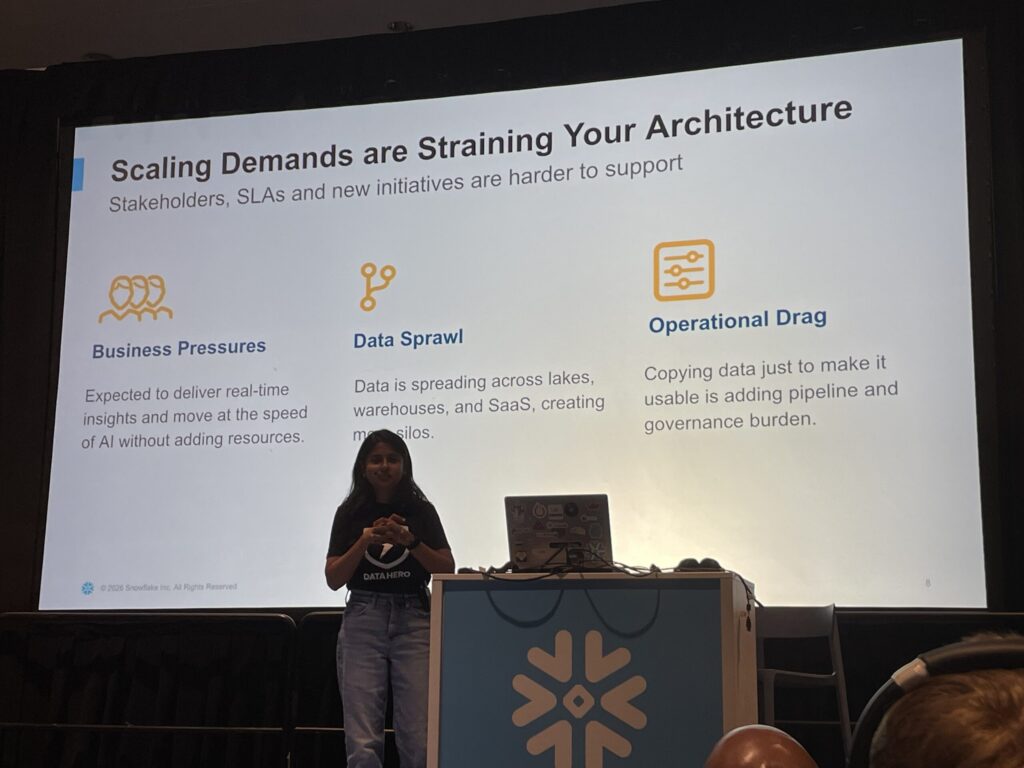
まず示されたのは、現代のデータチームが直面している三つの課題です。
Business Pressures
リソースを増やさずにリアルタイムインサイトを届け、AI のスピードに追いつくことが求められている
Data Sprawl
リソースを増やさずにリアルタイムインサイトを届け、AI のスピードに追いつくことが求められている
Operational Drag
データがデータレイク・ウェアハウス・SaaS に分散し、無数のサイロが生まれている
期待と現実:データチームの今
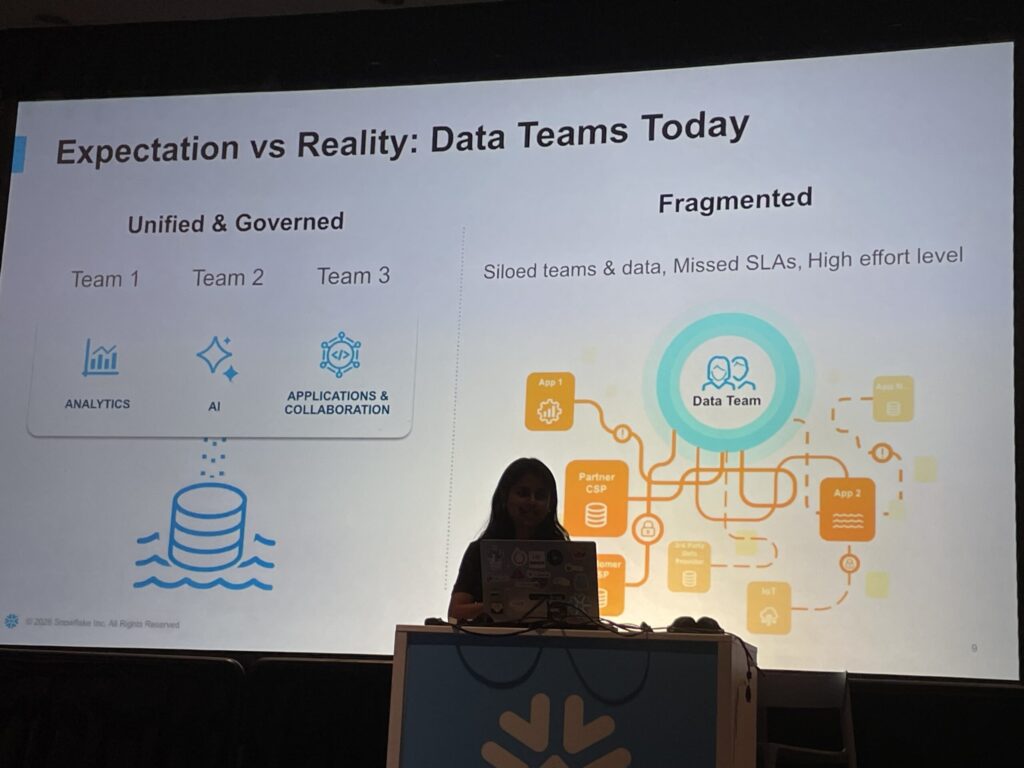
理想は、複数のチームが Analytics・AI・Applications & Collaboration を 統一されガバナンスされた 単一のデータ基盤の上で動かすことです。しかし現実は、チームとデータはサイロ化し、SLA 違反や高い工数が常態化しています。
Snowflake が目指す「シンプルな相互運用性」
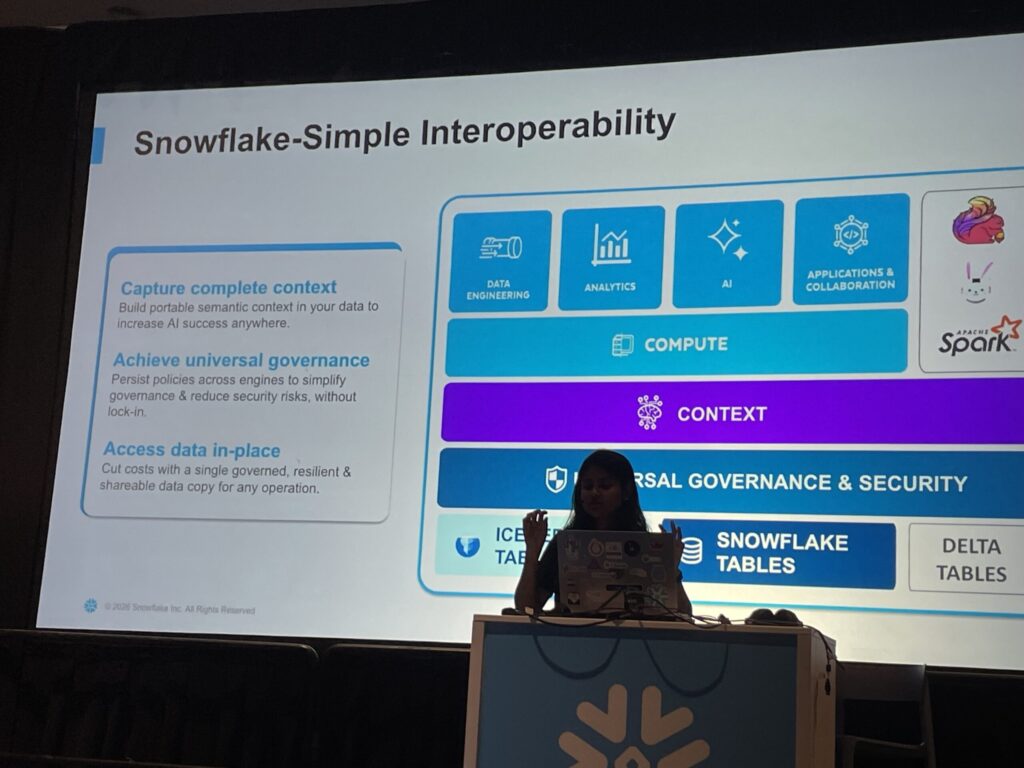
この課題に対する Snowflake の答えが Simple Interoperability です。アーキテクチャは 4 層で構成されています。
また、三つの設計原則が強調されました。
Capture complete context
データにポータブルなセマンティックコンテキストを持たせ、どこでも AI を成功させる
Achieve universal governance
エンジンをまたいでポリシーを永続させ、ロックインなしにガバナンスを簡素化する
Access data in-place
データをコピーせず、単一の管理されたデータコピーでコストを削減する
ハンズオン体験レポート
ここからは実際に手を動かして試した内容です。今回のラボは 「AWS Glue 上の Apache Iceberg データを Snowflake からデータ移動なしで分析する」 というシナリオです。データは保険見積もりレコード(40 カラム、Iceberg V2 形式)で、S3 バケット・Glue データベース・IAM ロールはあらかじめ用意されていました。
Step 1:External Volume の作成
まず Snowflake から S3 へアクセスするための認証情報を定義します。
CREATE OR REPLACE EXTERNAL VOLUME iceberg_lab_vol

  STORAGE_LOCATIONS = (

    (

      NAME = 'my-s3-us-west-2'

      STORAGE_PROVIDER = 'S3'

      STORAGE_BASE_URL = 's3://<バケット名>/'

      STORAGE_AWS_ROLE_ARN = '<IAM ロール ARN>'

    )

  );
Step 2:Catalog Integration の作成
AWS Glue の REST API に接続するカタログ統合を作成します。これにより Glue のメタデータが Snowflake から参照可能になります。
CREATE OR REPLACE CATALOG INTEGRATION glue_catalog_int
  CATALOG_SOURCE = GLUE
  CATALOG_NAMESPACE = '<Glue データベース名>'
  TABLE_FORMAT = ICEBERG
  GLUE_AWS_ROLE_ARN = '<IAM ロール ARN>'
  GLUE_CATALOG_ID = '<AWS アカウント ID>'
  GLUE_REGION = 'us-west-2'
  ENABLED = TRUE;
Step 3:Catalog-Linked Database の作成
カタログ統合からデータベースを作成すると、Glue に登録されている Iceberg テーブルが自動検出されます。
CREATE DATABASE iceberg_lab

  FROM CATALOG INTEGRATION glue_catalog_int;
SHOW TABLES IN DATABASE iceberg_lab; を実行するとquotes テーブルが表示されます。ここがポイントで、S3 上のデータは一切 Snowflake にコピーされていません。
Step 4:データ探索
通常の SQL でそのまま分析できます。
-- 商品タイプ別の件数を確認
SELECT product_type, COUNT(*) AS cnt
FROM iceberg_lab.public.quotes
GROUP BY 1
ORDER BY cnt DESC;

-- クレジットスコア帯別の平均保険料
SELECT
  FLOOR(credit_score / 100) * 100 AS score_band,
  ROUND(AVG(premium_amount), 2)   AS avg_premium
FROM iceberg_lab.public.quotes
GROUP BY 1
ORDER BY 1;
Snowflake の通常テーブルと同じ操作感で Iceberg データを扱えることを確認できました。
Step 5:ガバナンスの実装
次にロールベースのアクセス制御と動的データマスキングを設定します。
-- ロールの作成
CREATE ROLE lab_analyst;
CREATE ROLE lab_data_engineer;

-- PII カラム(メール・電話・氏名・生年月日)にマスキングポリシーを適用
CREATE OR REPLACE MASKING POLICY email_mask AS (val STRING)
RETURNS STRING ->
  CASE
    WHEN CURRENT_ROLE() IN ('LAB_DATA_ENGINEER') THEN val
    ELSE '****@****.***'
  END;

ALTER TABLE iceberg_lab.public.quotes
  MODIFY COLUMN email
  SET MASKING POLICY email_mask;
lab_analyst ロールで SELECT email FROM quotes を実行すると ****@****.*** と表示されlab_data_engineer では実際のメールアドレスが見えることを確認しました。データをコピーしなくてもガバナンスが一元管理できるのは大きなメリットです。
Step 6:セマンティックビューと Cortex Agent
最後に、ビジネスメトリクスや次元を定義したセマンティックビューを作成し、それを Cortex Agent に接続します。
CREATE OR REPLACE SEMANTIC VIEW quotes_semantic
  ON iceberg_lab.public.quotes (
    -- ディメンション定義
    DIMENSION product_type   COMMENT '保険商品タイプ',
    DIMENSION customer_id    COMMENT '顧客 ID',
    -- メトリクス定義
    METRIC total_premium = SUM(premium_amount)
      COMMENT '保険料合計'
  );
Cortex Agent を通じて自然言語でクエリできるようになり、「商品タイプ別の保険料合計を教えて」と入力するだけで適切な SQL が生成・実行されました。マスキングポリシーはこのレイヤーでも自動的に適用されます。
まとめ
今回のセッションを通じて体験できたポイントを整理します。
データ移動ゼロ
S3 の Iceberg データを Snowflake にコピーせずそのまま分析
自動テーブル検出
Catalog-Linked Database により Glue のメタデータを自動同期
統一ガバナンス
動的データマスキングがコピー先でなく元データに適用
AI との接続
セマンティックビュー + Cortex Agent で自然言語クエリを実現
Apache Iceberg を採用したマルチクラウド・マルチエンジン環境でも、Snowflake のガバナンスと AI 機能をフルに活用できることが確認できました。データをどこに置いていても「分析・AI の力」を届けるという Snowflake のビジョンが、実際のハンズオンで体感できたセッションでした。
ハンズオンの詳細は公式ガイドも参照してください。