Tableauの正体見たり、ビュー駆動型クエリエンジンなり
エクスチュアのシガです。
今回のブログでは、シガがTableauをいじり始めてから数か月の間に盛大につまずいてきたTableauの癖を、「どうしてそれが躓きになったのか」と併せてまとめていきます。
シガの躓きを大きく捉えると、
「分析内容を先に定義し、その結果を可視化する」という一方向の順序では、Tableauの挙動を理解できないこと
に根差していたと思われます。もう少し具体的に躓きをまとめると、以下3つのポイントがあるように思えます。そして、それらすべてに共通していたのが、視覚属性へのマッピングが、見た目だけでなく分析単位まで変えるというTableauの性質です。この記事では当時の戸惑いのまま、躓いていった順番に、当時の理解とともに振り返っていきます。
計算フィールドが、書いた時点では粒度を持たない
表計算が、データではなく描画後のマークに対して計算される
LODが、粒度を明示してもなおビューに依存する
なお、今回取り上げる問題の多くは、技法としてはTableauのデータパイプラインやLODの概念を理解することで解決します。
データパイプラインについては、個人的にはこの記事だけでもかなり理解が進むと思います。LODは、自分の直感に合う説明に出会うまでの旅です。是非、弊社の過去ブログやこのVizをご覧いただきたいです。弊社の過去ブログでは、二人の社員からそれぞれの言葉で解説しています。なおそのうちの片方の筆者である大吉は我々のお師様ですね。また、VizはDATA SaberのHPにあるApprenticeの進捗Vizを作っている方のものです。この方は、弊社インターンの卒業生だそうです。(シガは面識ありませんが……)
今回、一連のTableauに関するブログを書こうと思った直接的なきっかけは、DATA Saberなる認定プログラムに取り組んでいることにあります。
DATA Saberには、すべての人が、その役割に応じてデータの恩恵を得ることができるようなデータ利活用を推進するという大きな哲学があると考えています。
その哲学に応えるならば、すでにTableauを好きな人だけではなく、最初の違和感でTableauを投げ出しかけた人の言葉も残しておく必要があるでしょう。Tableauが数ある選択肢の一つにすぎない潜在的ユーザーが、それでもTableauを使ってみようと思えるように、まだ初学者であるうちに、最初につまずいた場所を記録しておこうという次第です。
なお、シガの躓きに関心がない人はこちらのリンクから、結論部分のみ読んでいただいても面白いかと思います。
目次[非表示]
やけに属人的なトピックですね、シガさん
ここでは、Tableauを始めた時点で、シガがどのような分析経験を持っていたのかを共有しておきます。
Tableau初学者とはいえ、シガはデータ分析そのものの初学者だったわけではありません。むしろ就職活動では、データ分析の経験を強みにできる会社を探していました。ところが、ことTableauを習得するという観点では、その経験の多くがミスリードを生んだように思います。
シガはエクスチュアに入社するまで、某大学院で計量政治学なる領域を専門としていました。大まかな研究の流れとしては、まず自分の関心や仮説を確定させ、それに従って世論調査を設計・実施し、得られたデータを分析するというものです。この環境で当たり前だった次の三つの前提を、博士課程へ進まなかったことへの少しばかりのおセンチな気持ちとともに、シガはいまだに引きずっているようです。
個票はすべての起源にして命! 生態学的誤謬に気を付けろ!
Rを使うのは「分析過程を明示するため」!
仮説 → データ生成 → 分析 → 可視化という、各工程を厳密に分けた鉄のフローを遵守せよ
もちろん、これらが間違っているわけではありません。ただし、これらを唯一の分析の作法だと思ったままTableauに触ると、かなりの確率で混乱します。
シガにとって、可視化は分析のあとに、すべての最後に置かれる工程でした。ところがTableauでは、グラフを作る操作そのものが、集計単位や計算内容を決めていきます。可視化は分析の出口ではありません。可視化を作成する画面そのものが、分析を組み立てる場所になっています。この違いに気が付くまで、Tableauの挙動の一つ一つが、どうにも落ち着かないものに見えていました。
計算フィールドが、書いた時点では粒度を持たない
最初に違和感の正体が見えたのは、計算フィールドでした。
1 | SUM([売上]) |
この式を見て、シガは思いました。
「これは、何についての合計なんですか? 都道府県ごと?顧客ごとなのか?はたまた年ごと?」
その答えは、計算フィールドの中には書かれていません。実際のVizにどのディメンションが置かれているかによって決まります。
1 | MIN(YEAR([オーダー日])) |
この式も同様で、顧客がビューに置かれていれば顧客ごとの最小年になり、製品が置かれていれば製品ごとの最小年になります。計算式は同じでも、Vizによって答えが変わります。
当時の疑問への答えは「計算フィールドは、書かれた時点では、まだ特定の粒度にはひも付いていない」ということになります。あえて特定の粒度へ固定しないのは、同じ式を、顧客単位のビューにも都道府県単位のビューにも、書き換えずに使い回すためです。計算フィールドを作ったはずなのに、変数を作った気がしない。最初の違和感は、ここにありました。
表計算が、データではなく描画後のマークに対して計算される
続いて異質に感じたのが、表計算です。Tableauの表計算は、元データの行に直接計算を加えるものではありません。一度集計され、ビュー上に描画されたマークに対して計算されます。
したがって、計算結果は、マークがビュー上でどのように配置されているかに依存します。横方向へ計算するのか、縦方向へ計算するのか。カテゴリごとに区切るのか、表全体にわたって計算するのか。列の順番や配置を変えれば、参照されるマークも変わります。
グラフや表のレイアウトが、そのまま計算ロジックの一部になる。シガにとってグラフは計算結果を受け取る側でしたが、表計算では、描画されたグラフや表そのものが新たな計算の入力になります。
可視化と分析の境界は、ここでかなり怪しくなります。
LODが、粒度を明示してもなおビューに依存する
ここまで粒度に苦しんできたシガの前に、救世主のように現れたのがLOD表現でした。
1 | { FIXED [顧客ID] : SUM([売上]) } |
顧客単位で売上を集計する。式の中に粒度を事前に指定することができる。ようやく話が通じる人が現れた! そう思いました。しかし、LODを覚えればすべてが自分の思い通りの世界へ戻ることはありませんでした。INCLUDE、EXCLUDEが現れたのです。
FIXED、INCLUDE、EXCLUDEでは、現在のビューとの関係が異なります。INCLUDEとEXCLUDEは、式だけで絶対的な粒度を定義するものではありません。ビューの粒度を基準として、そこに足したり引いたりしているだけです。FIXEDは、指定したディメンション単位で集計粒度を定めます。ただし、その計算結果が最終的にどのように表示・再集計されるかは、Vizの粒度にも左右されます。
INCLUDEとEXCLUDEはビューの粒度を基準にディメンションを追加・除外し、FIXEDはビューとは独立した粒度を指定します。LOD表現によって計算粒度を明示できても、最終的なビューの粒度から完全に自由になるわけではありません。
LODは、粒度を決める仕組みではなく、ビューの粒度に対して調整を加える仕組みです。結局のところ、決定権は、最後までビュー側に残っています。LODは粒度を明示する仕組みなのに、ビューから完全には独立していない。ここで、再度躓きました。
どのフィルターの影響を受けるかも、データパイプライン上の位置によって異なります。粒度を式の中に書けるようになったからといって、ビューの存在を忘れてよいわけではありません。Tableauには、一つの概念を理解したと思わせてから、その概念が別の概念に依存していることを明かす癖があります。学習者を飽きさせない工夫でしょうか。
その結果中間データを確認できず、デバッグが逆算になる
Rであれば、処理の途中にあるデータフレームをいつでも覗けます。どの段階で行数が減ったのか、どの変数に欠損値が入ったのか、どのグループで集計されたのか。中間生成物を見ながら、原因を切り分けられます。
一方、Tableauでは、最終的に表示されたマークを見ながら、内部で何が起きたのかを推測することになります。現在表示されているひとつのマークには何行のレコードが含まれているのか。どのディメンションによって分割されているのか。LODの結果が、さらにどの集計を受けたのか。表計算は、どのマークをどの順番で参照しているのか。
中間データを確認できず、デバッグが逆算になります。完成したビューから、暗黙的に生成されたクエリや処理を復元しなければなりません。特にLOD表現はTableau内部で指定した集計粒度で仮想的に中間テーブルを作り出すものですが、計算フィールドに紐づいているため、テーブルそのものを直接確認できません。そのため、意図した粒度で計算されているかを確認するにも、別の検証用ビューを作る必要があります。
復元するくらいなら、いっそクエリそのものを見てしまいたい。TableauからBigQueryへどのようなSQLが発行されているのか調べたこともありました。決して単なる好奇心ではありません。自分がデータへ何をしたのかを理解するために、一度SQLという慣れた表現へ置き換えようかと考えたのです。
この問題は、デバッグだけではありません。他の人へ分析内容を説明するときにも現れます。Tableauでは、分析のロジックがGUIの状態として保存されます。どのシェルフに何を置いたか。色や詳細にどのフィールドを置いたか。表計算をどの方向に設定したか。完成したワークブックには、それらの操作の結果が残っています。しかし、そこへ至った順序は残りません。
中間状態は見えにくく、完成後には操作の順序が消えている。そのため、作っている最中も、他人のVizを読むときも、現在のビューから分析ロジックを逆算することになります。
Tableauは「可視化ツール」というより「ビュー駆動型クエリエンジン」だった
これらの躓きを重ねるうちに、シガは一度、Tableauの操作体系をGrammar of Graphics(以下、GoG)と呼ばれる、可視化を作るためのよく知られた枠組みに当てはめて理解し直そうとしました。x軸とy軸で座標平面をまず定義し、その上に点や線、面といったパーツをレイヤーとして重ねていく。ggplot2などが採るこの作図の文法に沿って考えれば、Tableauの行・列・色・詳細の使い方も同じように理解できるはずでした。
しかし、Tableauでは、その座標平面を定義する操作そのものが、まだ確定していない集計単位を決めていきます。シガが例えばRでggplot2を使うときは、あらかじめ分析単位を決め、必要な集計を済ませたデータフレームを用意してから、座標や色、形へ変数を割り当てていました。もちろんGoGにも統計変換はありますが、少なくともシガの使い方では、データの粒度を決める工程と描画する工程を分けていました。Tableauでは、平面を作る操作と、データを集計する操作が同じ場所で起きています。ここでも、可視化を組み立てる行為が、そのまま分析を組み立てる行為になっていました。Tableauを「分析結果を可視化するツール」と考えていたシガはどうにも理解に苦しみました。データを整える。集計内容を決める。分析を終える。その結果をグラフにする。Tableauは、その最後の工程を担当するものだと思っていました。
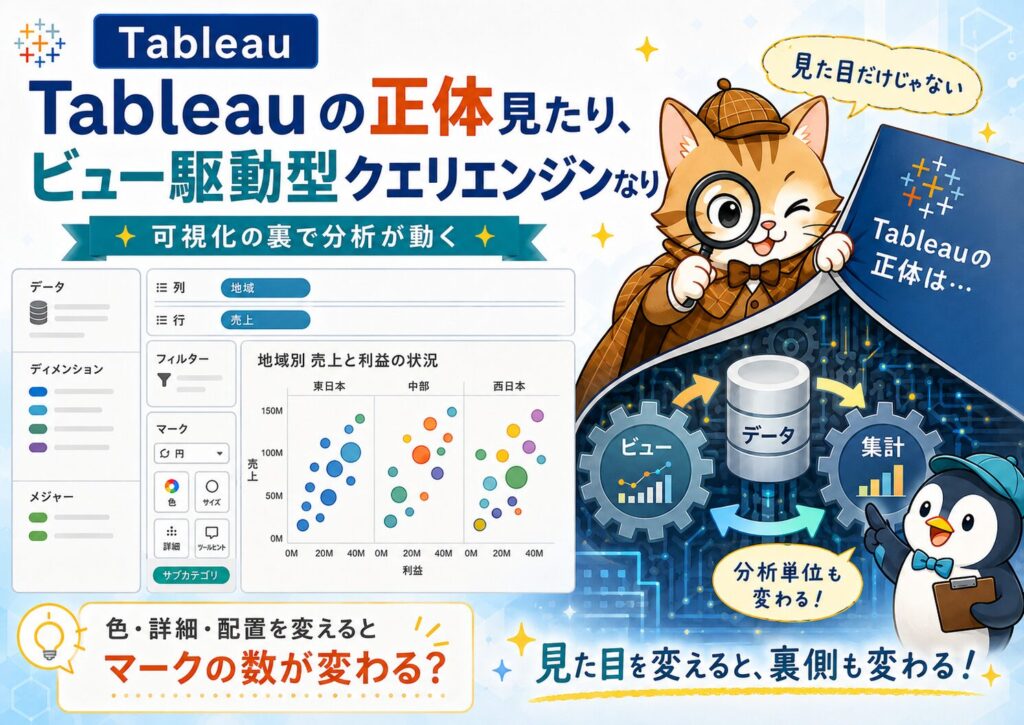
しかし、実際のTableauでは、ビューを作る操作そのものがクエリを作ります。どのディメンションでデータを分けるのか。どのメジャーを、どの集計方法で計算するのか。集計後のマークに、どのような追加計算を行うのか。これらが、ビューを組み立てる過程で決まっていきます。つまり、Tableauは「可視化ツール」というより「ビュー駆動型クエリエンジン」だった。
そう考えると、これまで不可解だった挙動がつながります。計算フィールドの意味が計算式だけでは決まらないのも。表計算が描画後のマークを対象とするのも。LODがビューから完全には独立していないのも。見た目を変える操作が分析単位まで変えるのも。
Tableauでは、ビューは分析結果を表示するだけの場所ではありません。ビューは、データへ問い合わせるためのインターフェースです。シガが当然だと思っていた、
分析内容を決める → データを処理する → 結果を可視化する
という順序は、Tableauでは、
ビューを作る → ビューに応じてクエリと集計単位が決まる → 結果を見ながらビューと分析内容を作り直す
という循環になります。この循環そのものは、別に間違った設計ではありません。むしろ、まだ問いが固まっていない段階では強力に働きます。
シガが苦しんだのは、循環そのものではなく、循環に入る前の構えでした。それは、個票データやTidy Data形式にこだわりすぎていたからだけではありません。より大きかったのは、分析単位や計算内容は、可視化を始める前に定義されているべきである、という前提でした。
シガは、コンクリートに固めた分析結果を可視化しようとしていました。Tableauは、可視化を組み立てながら、分析内容を決めていきます。この態度の違いが、最も大きな躓きだったのだと思います。
可視化と分析は、別々の工程ではありません。ビューを組み立てる行為そのものが、分析を組み立てる行為でした。
おわりに
ここまで、Tableauとこれまでの自分との間にあった断絶を書いてきました。場合によってはネガティブに見えるようなことも書いてみました。
しかし、今回挙げた特徴は、必ずしもTableauの欠点ではありません。ビューを変えれば、すぐに別の粒度でデータを見られる。色や詳細へフィールドを置けば、新しい切り口を試せる。集計結果を見ながら、問いそのものを変えていける。コードを書き直し、データを再生成し、グラフを描き直すという工程を挟まず、分析と可視化を往復できます。
これは、Tableauの非常に大きな強みです。特に、まだ問いが固まりきっていない段階でデータを探索する場合、ビュー駆動型であることは強力です。
シガがTableauにつまずいたのは、データ分析を知らなかったからではありません。むしろ、別の分析環境で身につけた前提を、Tableauにもそのまま持ち込んだからでした。
どちらが正しいという話ではありません。ただし、同じデータを扱っていても、分析をどこに記述するかが大きく異なります。
Tableauを始めて、計算フィールドも、LODも、表計算も、なぜか一つ一つが気持ち悪く感じられる方がいれば、まずはこう考えてみてください。特に大学院にいたころのシガのように、個票データを使ってきた人、RやPythonで分析をしてきた人、可視化とは、分析結果を伝えるためのものだと考えてきた人が当てはまると思います。
自分はTableauを、分析結果を表示するだけの可視化ツールだと思っていないか。Tableauは、ビューを通じてデータへ問い合わせるツールです。可視化を作ることによって、分析の単位と内容を定義していきます。
そう考えたとき、Tableauの癖は、少なくとも単なる意地悪には見えなくなりました。
たぶん。
See you Soon!
シガ