SnowflakeにPostgresのデータが届く!Native Mirroringを解説(Iceberg Meetup #7登壇) - MarTech・データ基盤・AI活用の技術ブログ Exture Data & MarTech Lab
AIのためのデータ基盤として、クラウドDWH(分析用データベース)から出発し進化を続けてきたSnowflakeは、2026年になりOSSのOLTPデータベース(業務システム用データベース)PostgreSQLを独自のフルマネージドデータベースSnowflake Postgresとしてサービス提供を開始しています。
そのSnowflake Postgresから、分析用データベースとしての元来のSnowflake側にOLTPのデータが自動で届く「Data Mirroring」機能が2026年7月にPublic Previewになりました。
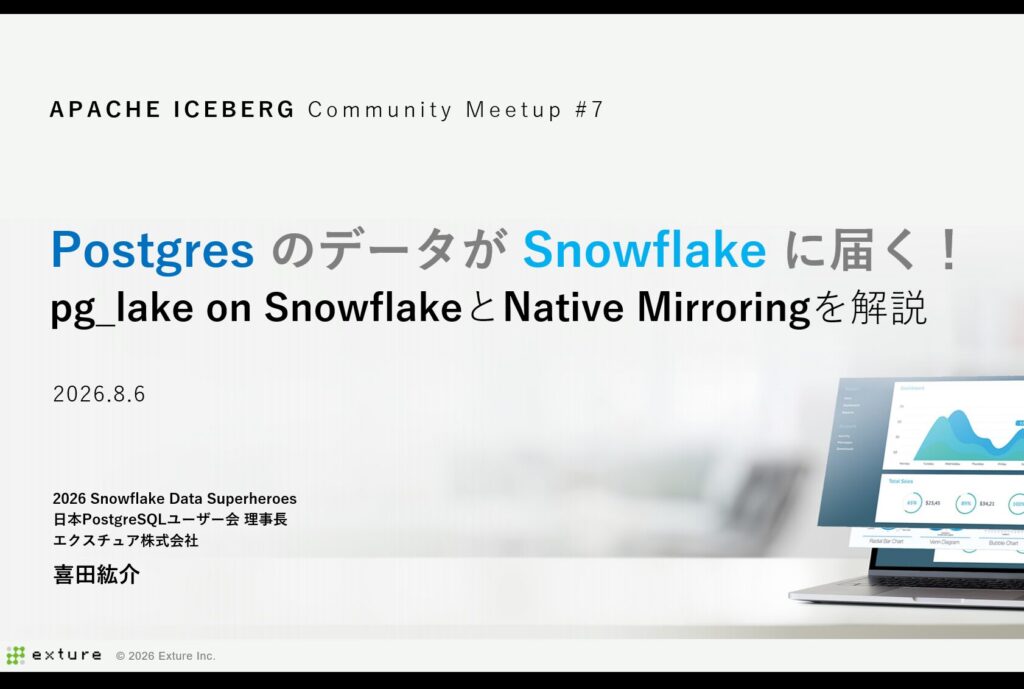
2026.8.6(木)Iceberg Meetup#7での登壇機会をいただき、このMirroring機能の実装報告をしてきました。
※イベント運営側での録画もあるようなので公開されたら本記事を更新します。
PostgresのデータがSnowflakeに届く!pg_lake on SnowflakeとNative Mirroringを解説
Snowflakeが「いまさら」Postgresサービスをカバーする必要性の話
Mirroringを実現する仕組みの話(Icebergとpg_lake、Postgres標準のレプリケーション、Mirroringとしてのラッピング)
Mirroringを行うためのコストや制限
について、実際に動かしてみてわかったことを中心に解説しています。
20260806-IcebergMeetup_SnowflakePostgres-Mirroring
ダウンロード
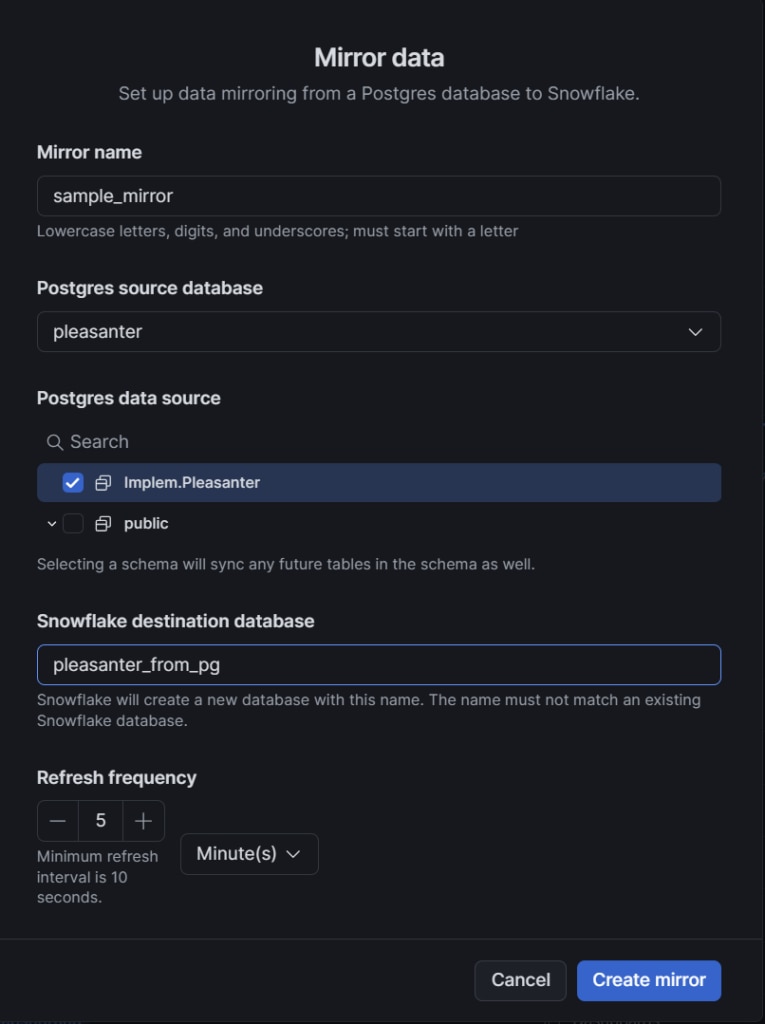
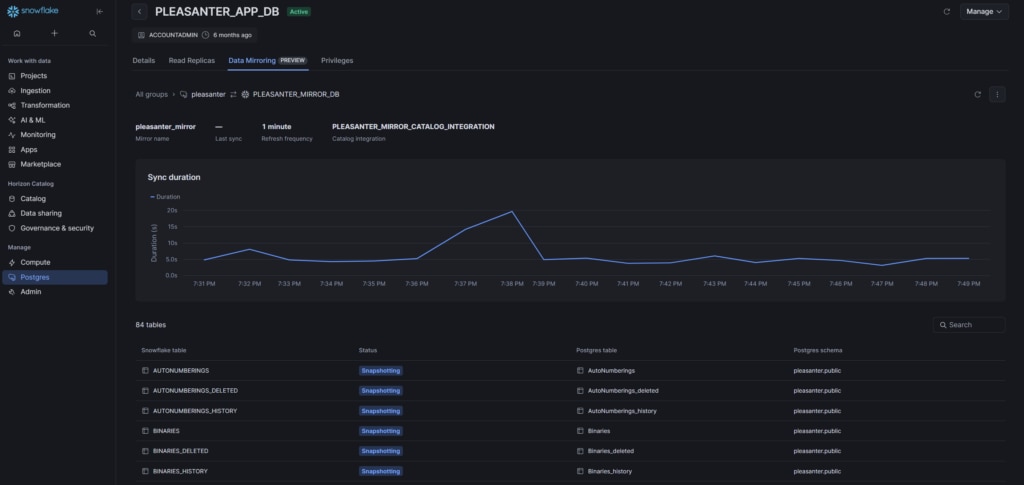
なお、検証にあたっては公式ブログ等ではコマンドでの作り方が中心で解説されていたので、それに則ってコマンドで作成しているのですが、すでにSnowsightでのMirroringの作成、ステータス確認などのメニューができていて、GUIだけでも作成・管理ができるようです。
作成
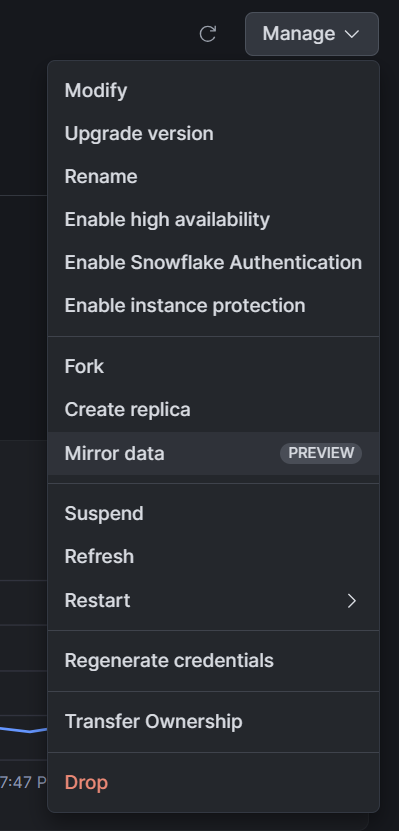
ステータス確認
PostgresからSnowflakeにミラーしているのがアイコンで見えていますね。かわいい。
(双方向の矢印はいまは間違っているはず、ゆくゆくはできるようになるらしいけど。)
懇親会やXでの反応を受けて
Snowflakeのイベントではないので、Iceberg勢、PostgreSQL勢がそれなりにいて、Snowflakeのことは知らないけど実装には興味があるという方が多かったような印象でした。
SnowflakeのData Superheroとして活動しているのでどうしても製品の魅力に寄りがちですが、ポジショントークではなく中立的に、でもこうあるべきという自分なりの思想を込めていたスライドに対してよい反応をいただけてとても有難く、同じ考えの人がいるとか間違ってないなっていう肌感が得られました。
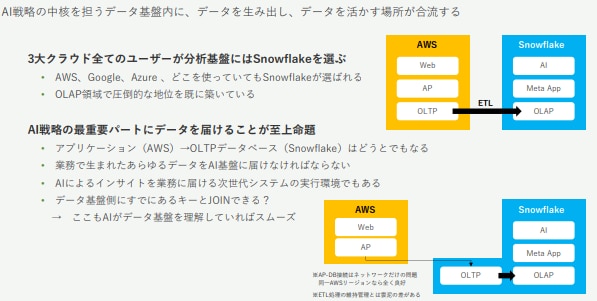
↑このへん。業務システムの裏のデータベースを選ぶ際、業務システム単体でみると「AWS RDSを選ばない理由がない」(他クラウドも当然同様、ここでは例としてのAWSとしています。)というのは誰もが思うことではありますが、AIのために業務のデータをデータ基盤に届けることは企業のインフラ戦略の至上命題になってくるという思想です。そこを一番軽くするにはアプリ開発者のスキルセットはそのままに、データベースサービスをデータ基盤側に寄せることだと考えています。Snowflake Postgresの価値もそこ。なのでこの横向きの矢印であるMirroringがめちゃ重要なピースなわけですね。
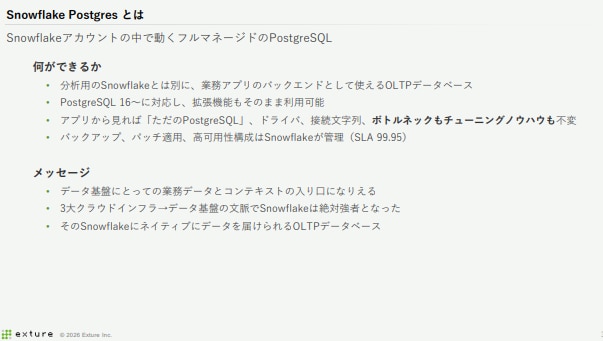
↑PostgreSQL勢からいただいたコメントとしては、PostgreSQLの性能トラブルを一度でも経験したような方だと、内部実装が同じでボトルネックも含め勘所が同じというのはマネージドサービスになっても扱いやすいポイントになるよねと意気投合しました。(内部実装に手を入れて高速・高機能などを達成していたとして、リッチな環境では選ばれるかもしれないが気軽な選択肢にはなりづらい)
ガチるべき領域ではNewSQLとかガンガン使っていきましょうよ、というデータベースエンジニアとして憧れに似た想いがあるんですが、第一の選択肢としてはこっちだよねみたいな。
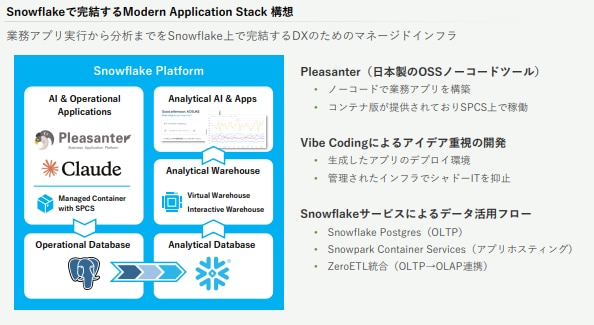
↑登壇テーマからするとオマケみたいなページですが「Snowflakeでアプリも動いちゃうよ」というページも良い反応をいただけました。Snowflake Postgresの必要性を考えたときに、インフラ戦略全体に影響するテーマであると感じていて、1サービスで完結でできるスピード最優先で実現できる範囲、3大クラウドや他のサービスとインテグレーションが必要だけどより高度に安価にできる範囲といったレイヤー戦略が結構いいのではと考えています。(Snowflake Postgresの必要性を考えているので、Snowflakeはその戦略の中核に置く前提ではあります。)それこそIcebergとかOTFのおかげで後から必要に応じて引っ越す育てる自由度が高まっているので、迷わず置ける場所を決めてしまうのが良いと考えています。
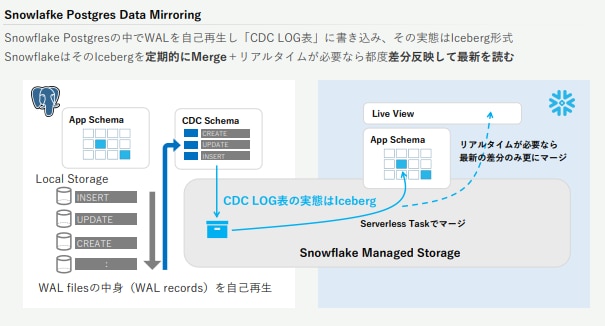
あとは本題のこのページ。
なぜPostgresのリソースを使ってIcebergの中間テーブルを書くのか(Snowflakeのコンピュートを使わないのか)を複数の方から質問いただきました。これは他の実装では成しえなかった、唯一の正解とも言うべきこの方式の強い点が表れていると思います。
追加課金が不要なMirroringの第一ステップ
Postgresは業務アプリのバックエンドとして常駐(サービス提供時間帯など書き込みがある=Mirroringする間は)するコンピュートで、時間単価はSnowflakeの他のコンピュートと比べても安く設定されています。常駐する業務アプリの裏側の余剰リソースで、追加課金なしでCDC LOGの書き込みが完了しています。ちなみにSnowflake Postgresのコンピュート費用はAWS RDSと比べてもオプション次第ですが見劣りしない価格になっています。ストレージ単価が高めとか、バックアップや監視やミラーリングのIncludeとか、RDSと比べるとこの形ならどっちがどうと見るべきポイントがあるんですが、Mirroringのコストに関わるコンピュート費用で言ったら断然安い部類のコンピュートで、しかもどのみち稼働しているものの余剰分に収まるということです。
一方、Snowflakeでリアルタイム要件の高いデータ同期(CDC)をやろうとすると、ETLツールなどでCDCジョブを管理する費用と、加えて受け取り側のSnowflakeのコンピュート(仮想ウェアハウス)を常時起動することになり、仮に更新がほとんどない環境だとしてもリアルタイムを待ち受ける目的では1万円/日~を見ておく必要があります。アーキテクチャを再考しStremingを検討した方が安いかもしれないぐらいですね。
Snowflakeは受け取り側の都合でコストメリットのある方式・タイミングで
今回紹介したMirroringの方式では、Postgres側のコンピュートリソースを使って安価にIceberg形式で差分を吐き出し、Snowflake側は一定時間間隔でのMergeジョブを動かします。例えば1時間に1回、1分のマージジョブが動くだけであれば10円~で済みます。リアルタイムな値が必要な場合はLive Viewを参照します。この参照の間、Snowflakeの参照用のコンピュートはどのみち稼働するもので、そのリソースを使って1時間前のMerged Tableと1時間分のCDC LOGをマージしながら結果を返してくれます。(これはCDC LOGが直接クエリできるIcebergだからこそ成せることで、中間がStreamとかだとそうはいきません。)ここでは3秒のクエリが5秒になるかもしれませんが費用に大きな影響はありません。
登壇を振り返って
私はIcebergはコミュニティのニュースを追っている程度、実装や実運用にはあまり触れずに来ていたのですが、S3とpg_lakeを作ってみたり(2026年3月ごろ)、Snowflakeマネージド領域を使ったpg_lake(6月)、そしてNative Mirroring(8月)と、Snowflake Postgres × Snowflakeの進化にあわせて触れる機会になり、そしてあっという間に「詳細を知らなくても作れる」マネージドサービスになっていました。
Iceberg MeetupではありますがIceberg部分に関することは教わる部分がほとんどで、例えばMerge-on-Read、Copy-on-WriteみたいなIceberg用語を使えばもっとシンプルにこの場にわかりやすく伝わったのでは、とかは後から皆さんと会話していて思いました。
PostgresやSnowflakeの仕組み・勘所については思った以上に良い反応をいただけており、トークとして歓迎していただけたり、実装として注目されている領域だなとは改めて見えてきました。別のDB製品、別のクラウドでも近しい実装がされてきたり、違う実装だけど同じ結果になるなら比較対象になってきたりとか、OLTP-OLAP連携(HTAPではない)については製品をまたいで追いかけてみたいと思っています!