Tableauアナリティクスペイン完全攻略 #4 Tableauのクラスタリングは何をしているのか 機械学習モデルで複雑な多変量を分析しきる
エクスチュアのシガです。カニが食べたいです。大学から新宿まで散歩がてら歩いて帰ると途中にあるデッカイカニを思い出しています。
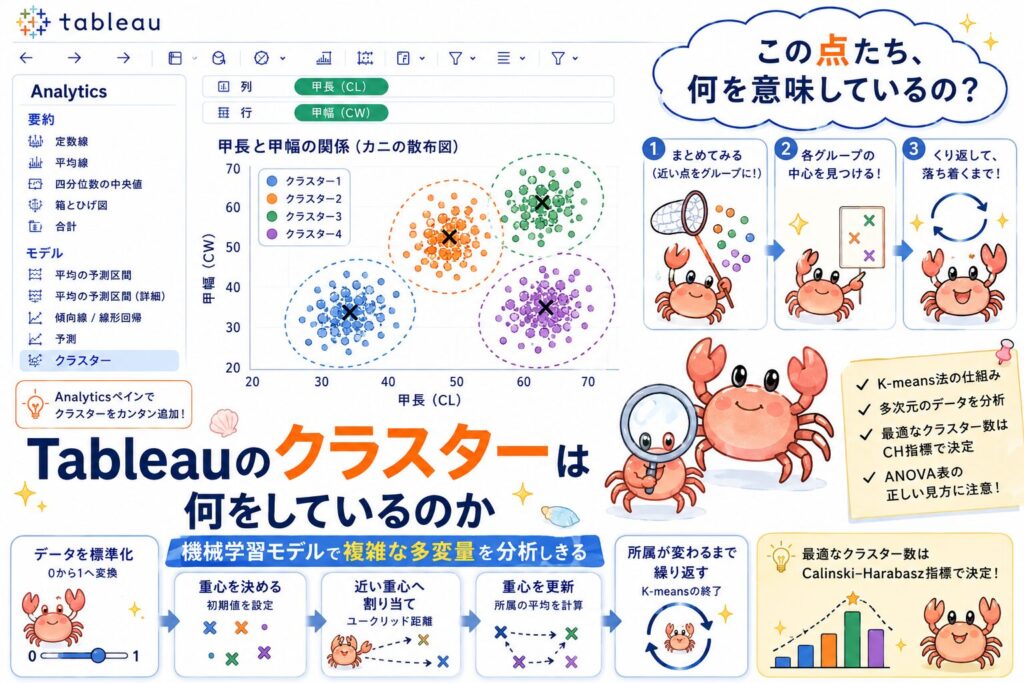
アナリティクスペインシリーズ4本目では、ビュー上のマークを、機械学習によってグループ分けする「クラスター」というモデルについて解説していきます。具体的にはその裏側で動いているK-means法と呼ばれる機械学習モデルについて解説を行っています。なお、機械学習モデルの中でもK-means法は「教師なし学習」と呼ばれる分類に属します。このブログでは詳しく説明をしませんが、概念が気になる方はぜひ、弊社の過去ブログをご覧ください。それぞれリンクは以下の通りです。( 機械学習 / 教師なし学習 /教師あり学習 )
Tableauのビューは行*列の2次元で構成されるため、できる分析は2次元に限られると勘違いしそうになります。しかし、クラスタリングでは、画面に表示されていない変数も計算へ追加できます。ビュー上では2次元の散布図を表示しながら、その裏側では3つ、4つ、5つといった複数の変数を使い、多次元空間におけるマーク同士の近さを計算できます。3次元以上の複雑な分析を実現できるということになります。是非、ものにしていただきたいと思います。
今回もオープンデータを使いながら、解説を進めていきます。使用するのは、RのMASSパッケージに収録されているcrabsデータになります。200匹のカニについて、次の5種類の身体寸法が記録されています。各変数の詳しい情報はこのブログが参考になると思われます。今回もこのリンクに.twbxを置いてありますので、ぜひいじりながら理解をしてみてください。
目次[非表示]
- 1.K-means法は何をしているのか
- 1.1.分析ユニット:観測を多次元空間上の点として表す
- 1.2.「似ている」を定義する:ユークリッド距離の近さ
- 1.3.重心を探し出す:分類の起点を決め、近さ(=類似度)を測る
- 1.3.1.1.k個の中心を用意する
- 1.3.2.2.各観測を最も近い中心へ割り当てる
- 1.3.3.3.所属したカニの平均を、新しい重心にする
- 1.3.4.4.所属が変わらなくなるまで繰り返す
- 1.4.結局のところ、何を最小化しているのか
- 2.Tableauでk-means法を使う
- 2.1.Tableauでは、1マークが1観測になる
- 2.2.Tableauも所属が変わらなくなるまで繰り返す
- 2.3.入力変数は0から1へ変換される
- 2.4.Tableauは初期中心を乱数で決めない
- 2.5.クラスター数を指定しない場合
- 3.これやるな:k-means法で起こりやすい誤用
- 4.まとめ
K-means法は何をしているのか
ここではK-means法が具体的にどのようなモデルで、どのような計算に基づいて、観測を似ているもの同士に分けているのかを解説しています。YouTubeにとても分かりやすい解説がありましたので、ぜひそちらをまずご覧になってください。仰々しい名前に対して、やっていることは実はシンプルです。全く同じ説明を文章と数式で理解するとどうなるか確認するように読み進めてみてください。
なお、筆者も今回このブログを執筆するために初めてしっかりモデルの中身を勉強しました。勇気があれば、筆者が読んだこの資料や、この資料、このページをご覧ください。あとになるにつれ難しくなりますが、説明していることはすべてK-means法です。今回は特に一番最後に紹介したページに沿って説明を展開します。なおここでは、各観測の所属先とクラスターの重心という2つの未知数を交互に更新する最適化問題として説明されています。
分析ユニット:観測を多次元空間上の点として表す
K-means法では、分析に使う変数の数だけ次元を増やしながら出来上がった座標空間上に1件の観測を配置します。
例えば、カニの甲長CLだけを分類に使うなら、1匹のカニはxi=(CLi)x_i=(CL_i)のように1次元(数直線)上の1点として表現されます。甲長CLと甲幅CWを使うなら、xi=(CLi,CWi)x_i=(CL_i,CW_i)という2次元空間上の点になります。さらに、例えば今回記録されている5種類の身体寸法をすべて使うなら、1匹のカニは、xi=(FLi,RWi,CLi,CWi,BDi)x_i=(FL_i,RW_i,CL_i,CW_i,BD_i)という5次元空間上の点として扱われます。
3次元以上の空間を2次元空間であるPCの画面で正確に可視化することはできません。ゆえに、あくまでビューは行シェルフと列シェルフに置かれた変数で定義されます。しかし、座標空間の次元が増えても、その点(各観測値)をどのように扱うかは変わりません。Tableauの画面上には甲長と甲幅しか表示していなくても、クラスタリングへ残りの3変数を追加すれば、Tableauは5次元空間におけるカニ同士の近さを計算します。
「似ている」を定義する:ユークリッド距離の近さ
K-means法にとって、「似ている」とは距離が近いことです。
2次元の散布図上に2匹のカニがいるとします。2匹の甲長の差をΔCL\Delta{CL}、甲幅の差をΔCW\Delta{CW}とすると、その距離は次のように計算できます。
したがって、K-means法でいう「似ている」は、あくまでも 分析者が入力した変数において距離が近いことを意味します。身体寸法だけを入力したなら、身体寸法が近いカニを似ていると判断します。生息地、年齢、性格など、入力していない特徴まで似ていると判断しているわけではありません。何を入力変数として選ぶかによって、「似ている」の意味そのものが変わります。
重心を探し出す:分類の起点を決め、近さ(=類似度)を測る
K-means法の「k」は、作成するクラスター数です。我々は、各観測から所属先クラスターの重心までの平方ユークリッド距離を合計し、その値が小さくなるようなK個の重心とクラスター分割を探します。なお、「means」は平均を意味します。K-means法は、各クラスターを代表するk個の平均点を探す方法だと考えると理解しやすくなります。計算は、次の手順を繰り返します。
1.k個の中心を用意する
定義した空間上にランダムでk個、クラスターの重心の候補を置きます。この中心は、セントロイドとも呼ばれます。
2.各観測を最も近い中心へ割り当てる
それぞれのカニから、すべての重心までの距離を計算します。そして、最も近い重心を持つクラスターへ、そのカニを割り当てます。
3.所属したカニの平均を、新しい重心にする
それぞれのクラスターに所属したカニについて、変数ごとの平均値を計算します。
甲長と甲幅を使っているなら、
(クラスター内の平均甲長,クラスター内の平均甲幅)
が新しい重心です。5つの変数を使っているなら、5つの変数それぞれの平均値からなる点が新しい重心になります。
4.所属が変わらなくなるまで繰り返す
重心が移動すると、それまで所属していたクラスターより、別のクラスターの重心に近くなるカニが出てきます。
そこで再び、各カニを最も近い重心へ割り当て直します。その後、変更後のメンバーから新しい重心を計算します。
この「所属の更新」と「重心の更新」を、所属関係に変化がなくなるまで繰り返します。
結局のところ、何を最小化しているのか
K-means法が小さくしようとしているのは、各観測と所属先の重心との2乗距離の合計です。
K-means法は、SSW、すなわちクラスター内平方和が小さくなるように、カニの所属先と重心を更新します。ユークリッド距離の式には平方根がありますが、K-means法では平方根を取る前の平方ユークリッド距離を使います。平方根を取っても距離の大小関係は変わらないため、最も近い重心を探すうえでは同じ結果になるからです。
つまり、K-means法が直接行っているのは、 同じクラスター内のカニを、それぞれの重心の周囲へできるだけコンパクトにまとめることです。その結果として、クラスター同士も比較的分離した状態になります。ただし、K-means法が最適化のために参照しているのは重心同士の距離ではなく、あくまでもクラスター内平方和の小ささです。
Tableauでk-means法を使う
Tableauのクラスタリングも基本的には同じですが、Tableauで使う際に把握しておきたい実装上の特徴があります。
Tableauでは、1マークが1観測になる
Tableauがクラスタリングするのは、データソースの行そのものではなく、現在のビューに表示されているマークです。Tableauはビュー内の各マークを、いずれかのクラスターへ割り当てます。ここでは、次の2つを区別する必要があります。
ビュー上のディメンション:1マークが何を表すかを決める
クラスタリングの入力変数:マーク間の距離を計算する
たとえば、1行が1回の注文であるデータでも、顧客ごとに集計されたビューなら、1マークは1注文ではなく1顧客です。クラスタリングに使われるメジャーも、その顧客単位で集計された値になります。クラスタリングを実行する前に、行シェルフ、列シェルフ、そしてマークカードに置かれた ディメンションを確認してください。現在のビューにある1マークは、何を表しているのか、分類よりも先に明確にする必要があります。
Tableauも所属が変わらなくなるまで繰り返す
Tableauは、平方ユークリッド距離を使ったLloyd法によってK-meansクラスタリングを計算します。
各マークを最も近い重心へ割り当て、所属マークの平均値から重心を更新します。その後、より近い重心が変わったマークを再割り当てします。この処理を、クラスターの所属関係に変化がなくなるまで繰り返します。なお、ここでの停止条件は、後述するCalinski–Harabasz指標とは別の話です。
所属が変わらなくなる
→ あるkにおけるK-means計算の終了Calinski–Harabasz指標を比較する
→ 採用するkを決めるための処理
入力変数は0から1へ変換される
ユークリッド距離は、変数の値域に強く影響されます。たとえば、次の2変数をそのまま使ったとします。
利益率:0~0.5
売上:0~1億円
この場合、距離のほとんどが売上によって決まり、利益率の差はほぼ無視されます。そこでTableauは、クラスタリングに使う各変数をmin-max正規化によって0から1の範囲へ変換します。
今回使用する数値入力変数は、上記の式に投入され0から1の範囲へ変換されます。現在のTableauでは、このmin-max正規化がクラスタリングの前処理として使われています。ただし、正規化で解決できるのは、単位や値域の違いです。似た内容を持つ変数を複数入れた場合に、その情報の重複を取り除く機能ではありません。
例えば、今回、最初に甲長CLと甲幅CWだけを使って4クラスターを作り、次に5種類すべての身体寸法を使って同じく4クラスターを作ったとします。しかし、分類結果は大きく変わりません。多くのカニは同じ体格帯のクラスターに残り、所属が変わったのは主に境界付近の個体でした。甲長が大きいカニは、甲幅、体深、前後の幅も大きい傾向にあります。変数を5つに増やしても、その5つが主に「身体全体の大きさ」という似た情報を持っていたため、分類の基本構造は変わらなかったと考えられます。つまり、次元を増やすことと、重複しない新たな情報を増やすことは同じではありません。
Tableauは初期中心を乱数で決めない
一般的なK-means法では、初期中心をランダムに選ぶ実装があります。それゆえに初期中心が異なると、同じデータでも異なる局所解へ到達する可能性があります。しかし、Tableauは、2クラスターから順に分割して初期中心を作る独自の手順を採用しています。その初期中心から、平方ユークリッド距離を使い所属クラスターを決めていきます。K-means法の弱みである再現性の欠如を一部克服するように、データに対して一定の初期値が必ず固定されるようになっているのです。乱数による初期化がないため、同じデータ、同じマーク、同じ入力変数、同じクラスター数という条件なら、原則として分類結果は同じになります。Tableauはこの性質を「決定論的」と説明しています。
なお、初期中心を作る詳細な分割手順はかなり複雑です。実際にTableauを使ううえでは、Tableauは初期中心を乱数任せにしているわけではないと把握しておけばよいでしょう。
クラスター数を指定しない場合
K-means法は、kが決まった後に、観測をどのように分けるかを計算する方法です。つまり、K-means法の計算だけでは、k = 2がよいのか、k = 4がよいのか、その最適な値は決められません。
Tableauでクラスター数を指定しない場合、Tableauは複数のkについてK-means法を実行し、Calinski–Harabasz指標で各結果を評価します。Calinski–Harabasz指標は以下のように与えられます。
ここで、
(SSB):クラスター間平方和
(SSW):クラスター内平方和
k:クラスター数
(N):観測数
です。大まかに自然言語で表現しようとすると、クラスター間のばらつきクラスター内のばらつき\frac{\text{クラスター間のばらつき}} {\text{クラスター内のばらつき}}を、クラスター数と観測数によって調整した指標です。クラスター内ではマークがまとまり、クラスター間では離れているほど、CH指標は大きくなります。
Tableauは、k = 2, 3, 4 ・・・と順繰りにK-means法を実行し、CH指標の 最初の局所最大値に対応するクラスター数を採用します。最初の局所最大値が見つからない場合は、既定では最大25クラスターまで試行するそうです。設定可能な上限は50だそうです。たとえば、次のような結果なら、Tableauが採用するのは、全体で最も大きいk = 5ではなく、最初の山となるk = 3です。
クラスター数 | CH指標 |
2 | 40 |
3 | 55 |
4 | 48 |
5 | 70 |
なお、CH指標はk=1では定義されません。そのため、この自動選択は「データを分ける必要がない」という1クラスターの結論を選ぶことはできません。
これやるな:k-means法で起こりやすい誤用
ANOVAのp値を通常の検定結果として読む
Tableauで[クラスターの説明]を開くと、各入力変数についてANOVAのF値とp値p値が表示されます。Tableau公式ヘルプでは、このANOVA表を、どの変数がクラスターの識別に効果的だったかを確認するためのものとして説明しています。( Tableau ヘルプ)しかし、このp値p値を、各クラスター間にどれだけ違いがあるのかを知るための分散分析として同じように読むことには問題があります。なおANOVAとは「分散分析」と呼ばれる、3つ以上の群間において平均値に差があるかどうかを検定する統計検定です。
K-means法は、入力変数について、「クラスター内の差を小さく」しながら「クラスター間の差を大きくする」ように、サンプルを各クラスターに分類しています。つまり、その後、同じ入力変数についてANOVAを行いクラスター間に差がありましたと報告しても、差が出やすいのは当然です。差が大きくなるようにグループを作り、そのグループには差があったと確認しているため、かなりのマッチポンプです。
K-means法で作成したクラスター間の平均差へ古典的な仮説検定をそのまま適用すると、第一種過誤率(実際には母平均に差がないにもかかわらず、差があると判断してしまう確率)が膨らむことが示されています。 Chen and Witten(2023)は、クラスターが同じデータから選ばれたという過程を考慮するselective inferenceの方法を提案しています。そのため、本記事ではTableauのANOVA表を、今回のクラスター分割に、どの入力変数が強く関係していたかを見るための記述的な診断として扱うことをお勧めします。p値p値が小さいことを根拠に、母集団にも、このクラスター間の平均差が存在するとは結論づけません。
K-means法が不得意な形状へ使う
K-means法は、各観測を最も近い重心へ割り当てます。そのため、重心の周囲に比較的丸くまとまったクラスターを扱うのが得意です。一方、密度や大きさが大きく異なる群、外れ値を含むデータ、複雑な形をした群では、期待した分類にならないことがあります。( Google for Developers)
たとえば、次のような形をしたデータです。
三日月形やリング状のクラスター
細長く傾いたクラスター
密度が大きく異なるクラスター
サイズが大きく異なるクラスター
外れ値に重心を引っ張られるデータ
明確な切れ目がなく、連続的に変化しているデータ
今回のカニは、甲長と甲幅の散布図上で、小型から大型へほぼ連続的に並んでいます。ここへk=4を指定すると、K-means法は連続的な体格の変化を4つに分割します。しかし、これは自然界に4種類の体格集団が存在することを意味しません。
K-means法は、自然なクラスターがなくても、kを指定すればその数に分けます。出来上がった色分けを見てから、それぞれを独立した「タイプ」として実体化しないよう注意が必要です。
クラスタリングに使った変数を、クラスターで説明する
Tableauで作ったクラスターは、グループディメンションとして保存し、ほかのワークシートでも利用できます。クラスターを後続の分析で説明変数として使うこと自体が、常に間違いというわけではありません。しかし、問題になるのは、クラスタリングに使った変数そのものや、それらからほぼ機械的に作られる変数を、クラスターによって説明して新しい発見のように扱う場合です。
今回のカニでいえば、5種類の身体寸法からクラスターを作った後に、クラスターによって甲長が異なったと報告するようなものです。甲長の違いを使ってクラスターを作っているので、異なっていてしかるべきなのです。一方で、クラスタリングに使っていない外部変数との関係を見ることには意味があります。今回なら、性別や色型が候補になります。クラスター別の性別構成やクラスター別の色型構成などを確認することで、身体寸法によって作られたクラスターが、別の属性とどのように対応しているかを探索できます。
ただし、性別や色型とクラスターが対応したとしても、クラスターに所属したことが、性別や色型を生み出したという因果関係を意味するわけではありません。クラスターは原因ではなく、入力した身体寸法に基づいて分析者が作った分類です。
まとめ
Tableauのクラスターは、複数の変数からなる多次元空間で、マーク同士の近さを計算する
K-means法は、各観測を最も近い重心へ割り当て、重心を更新する処理を、所属が変わらなくなるまで繰り返す
Tableauでは、1マークが1観測となり、数値入力変数は0から1へ正規化される
クラスター数を指定しない場合は、Calinski–Harabasz指標を使って候補となる kk を評価する
得られたクラスターは絶対的な分類ではない
ANOVAのp値p値や、クラスタリングに使った変数との関係を過剰に解釈しない
See You Soon!