Tableau × BigQuery コストを意識したBI設計のすすめ
目次[非表示]
はじめに:BIツールとBigQueryの関係
TableauなどのBIツールは、データソースに対してクエリを自動生成・実行します。ユーザーがダッシュボードを操作するたびにBigQueryへクエリが発行されるため、スキャン量(処理データ量)が積み重なりやすい構造になっています。
BigQueryはスキャンしたデータ量に応じて課金される(オンデマンド料金)ため、BIダッシュボードの利用頻度が高いほど、知らぬ間にコストが膨らむリスクがあります。
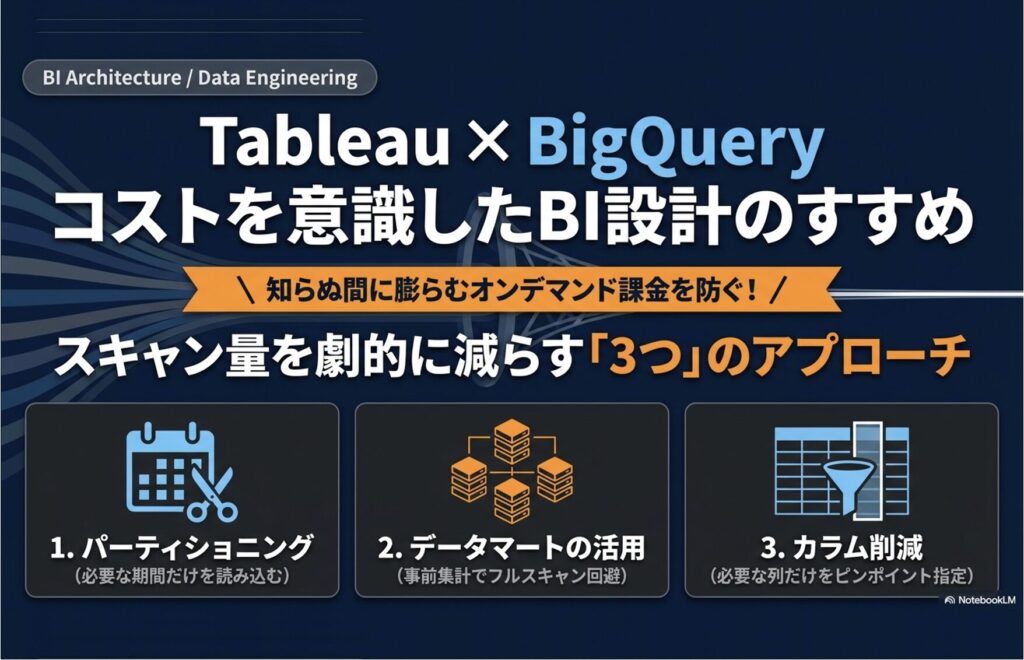
本記事では、スキャン量を削減する3つのアプローチ(パーティショニング・データマートの活用・カラム削減)を実際にクエリを実行して検証します。
なお、スキャン量を抑える方法としてBigQueryのデータをTableau独自のフォーマットに取り込む抽出接続も有効な選択肢です。抽出接続ではダッシュボード操作時にBigQueryへのクエリが発生しないため、コストを大きく抑えることができます。ただし本記事では、リアルタイムにBigQueryへクエリを発行するライブ接続を前提として、クエリ設計の観点からスキャン量を削減する方法に焦点を当てます。
データの接続
この記事ではDATA SaberのOrdealで扱われる「サンプル-スーパーストア.xls」を例とします。
https://drive.google.com/drive/u/0/folders/1kXSb3fqPTt3VcPjGUSgOmrztlRfvvpMH
Tableau PublicではBigQueryをデータソースとして選択できないため、Tableau Desktop Free Editionを使用します。
BigQueryに「サンプル-スーパーストア.xls」をロードし、Tableauからテーブルを選択して下記のようなグラフを作成してみます。

BigQueryのジョブエクスプローラーを確認すると、Tableauからのクエリが実行されていることが確認できます。

スキャン量を減らす3つのアプローチ
1. パーティショニング
テーブルを日付などのカラムで分割し、WHERE句で絞り込んだ際に必要な期間のデータだけを読み込む仕組みです。パーティションが設定されていないテーブルでは、WHERE句で日付を指定しても全データをスキャンしてしまいます。
以下のクエリで、パーティションあり・なしのテーブルを同一条件で実行し、ドライランで表示されるスキャン量を比較しました。
1 2 3 4 5 6 7 8 9 10 11 | -- パーティションなしSELECT *FROM saber_sandbox.sample_superstoreWHERE オーダー日 >= '2016-01-01'-- このクエリを実行すると、2.46 MB が処理されます。-- パーティションありSELECT *FROM saber_sandbox.sample_superstore_partitionWHERE オーダー日 >= '2016-01-01'-- このクエリを実行すると、820.13 KB が処理されます。 |

パーティションなしでは 2.46 MB のスキャンが発生していたのに対し、パーティションありでは 820.13 KB に削減されました。
なお、実際のスキャン量はINFORMATION_SCHEMAを使って以下のように確認できます。
1 2 3 4 5 6 7 8 9 10 11 12 | SELECT creation_time, user_email, ROUND(total_bytes_processed / POW(1024, 2), 2) AS scan_mb, queryFROM region-asia-northeast1.INFORMATION_SCHEMA.JOBS_BY_PROJECTWHERE creation_time >= TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 1 HOUR) AND job_type = 'QUERY' AND state = 'DONE'ORDER BY creation_time DESCLIMIT 20; |

2.データマートの活用
用途別に集計・加工済みのマートテーブルを用意し、生データへのフルスキャンを避けるアプローチです。Tableauのダッシュボードで使う集計をあらかじめBigQuery側で計算しておくことで、クエリの処理量を削減できます。
今回は以下のマートテーブルを作成しました。
1 2 3 4 5 6 7 8 9 10 11 12 13 | CREATE OR REPLACE TABLE saber_sandbox.mart_sales_summary ASSELECT オーダー日, 地域, カテゴリ, サブカテゴリ, 顧客区分, SUM売上) AS 売上合計, SUM利益) AS 利益合計, SUM数量) AS 数量合計, COUNT(DISTINCT オーダーID) AS オーダー数FROM saber_sandbox.sample_superstoreGROUP BY 1, 2, 3, 4, 5; |
生テーブルとマートテーブルに対して同等の集計クエリを実行し、スキャン量を比較しました。
1 2 3 4 5 6 7 8 9 10 11 | -- 生テーブル(フルスキャン)SELECT 地域, カテゴリ, SUM売上)FROM saber_sandbox.sample_superstoreGROUP BY 1, 2-- このクエリを実行すると、316.66 KB が処理されます。-- マートテーブル(集計済み)SELECT 地域, カテゴリ, SUM売上合計)FROM saber_sandbox.mart_sales_summaryGROUP BY 1, 2-- このクエリを実行すると、292.71 KB が処理されます。 |

スキャン量は 316.66 KB → 292.71 KB と約 8% の削減となりました。今回はサンプルデータのため行数が少なく効果が限定的でしたが、データ量が大きくなるほどマートの効果は顕著になります。数百万行・数十カラムの生テーブルに対して毎回集計クエリを走らせるケースでは、マートへの事前集計による削減効果は大きくなります。
3. カラム削減(列の絞り込み)
BigQueryは列指向ストレージを採用しているため、参照したカラム分のデータしかスキャンしません。SELECT * で全カラムを取得すると、不要なカラムも含めてスキャンが発生します。必要なカラムだけを指定することで、スキャン量を大きく削減できます。
1 2 3 4 5 6 7 8 9 | -- SELECT *(全20カラム)SELECT *FROM saber_sandbox.sample_superstore-- このクエリを実行すると、2.46 MB が処理されます。-- 必要カラムのみ(3カラム)SELECT オーダー日, 地域, 売上FROM saber_sandbox.sample_superstore-- このクエリを実行すると、283.12 KB が処理されます。 |

全20カラムを取得した場合は 2.46 MB のスキャンが発生していたのに対し、3カラムに絞ると 283.12 KB まで削減されました。
Tableau自体はシートで使うフィールドだけを自動的に絞り込んでクエリを発行するため、カラム削減の恩恵はTableauが自動的に受けています。ただし以下のケースでは注意が必要です
・計算フィールドが多い場合:複雑な計算フィールドで多くのカラムを参照していると、スキャン対象が増える
・カスタムSQLを使っている場合:SELECT * を手書きしていると全カラムスキャンになる
まとめ
今回はサンプルスーパーストア(10000行)を使って3つのアプローチを検証しました。
パーティショニング:2.46 MB → 820.13 KB
データマートの活用:316.66 KB → 292.71 KB
カラム削減:2.46 MB → 283.12 KB
数KB〜数MB程度のスキャン量では、料金への影響はほぼゼロです。BigQueryのオンデマンド料金は東京リージョンで1TBあたり約$6.00であり、毎月1TBまでは無料枠が適用されます。
ただし、TableauなどのBIツールではユーザーが操作するたびにBigQueryへクエリが発行されています。フィルターを変更する、別のページに移動する、ダッシュボードを開くだけでも、その都度クエリが実行されます。複数のシートが並んだダッシュボードであれば、1回の操作でシートの数だけクエリが飛ぶこともあります。
社内で10人のユーザーが1日に何度もダッシュボードを操作する環境では、1日あたりのクエリ実行回数は数十〜数百回に達します。テーブルが大規模であればあるほど、1回あたりのスキャン量も大きくなるため、月間のスキャン量は積み重なって無視できない規模になります。パーティションやカラム削減で1回あたりのスキャン量を減らすことは、そのままコスト削減に直結します。
BI設計の早い段階からパーティション・マート・カラム設計を意識しておくことが、長期的なコスト管理の観点でも重要です。
おわりに
ダッシュボードを閲覧するユーザーの視点からは、データソースに対するクエリは見えずらいため、操作のたびにBigQueryへクエリが飛んでいることを意識されている方は少ないと思われます。だからこそ、データ基盤の設計段階やBI作成の段階で、スキャン量を意識した設計をしておく必要があります。
次回は、実際に運用が始まった後にスキャン量や課金をどうやって監視するか、具体的な方法を紹介します。
この記事はData Saberコミュニティ活動の一環として執筆しました。