Session Report: Govern Your Entire Data and Al Estate – Inside and Outside Snowflake
こんにちは中村です。
Snowflake Summit 26にて Horizon Catalog セッションに参加したので、その内容についてレポートをまとめました。
Horizon Catalogについてはこちらが公式の記事になります。
目次[非表示]
- 1.信頼できるAI回答に必要なもの
- 2.Horizon Catalogの全体像
- 3.1. 相互運用性:データを動かさず、どこからでも使う
- 4.SaaS・外部メタデータとの接続
- 5.Universal Search:データ資産全体を横断検索する
- 6.Agentic Query:外部データベースにも自然言語で問い合わせる
- 7.2. Horizon Context:AIとBIが読む「文脈」を作る
- 8.Semantic Views:AIとBIの単一の定義
- 9.クエリ時にコンテキストを自動適用する
- 10.Cortex Sense:CoCoとCoWorkのコンテキストランタイム
- 11.3. ガバナンス:信頼できるデータから信頼できる回答へ
- 12.機微データ保護とAI Guardrails
- 13.Intent-Driven Governance:意図を書くとSnowflakeが実装する
- 14.AI Governance:エージェント、スキル、MCPサーバーを可視化する
- 15.まとめ:質問から、ガバナンスされたAI回答へ
信頼できるAI回答に必要なもの
Snowflake Summit 26 の Horizon Catalog セッションでは、AI エージェント活用における根本的な問いが提示されました。
> エージェントに質問するだけで、信頼できる回答を得るには何が必要なのか。
たとえば「今四半期、EMEA のエンタープライズアカウントのうち、解約リスクが最も高いのはどれか?」と聞いたとき、AI が返す回答は単に自然言語としてそれらしいだけでは不十分です。信頼できる回答には、データの鮮度、ビジネス上の意味、アクセス制御、リネージ、機微データ保護、AI ガードレールが必要になります。
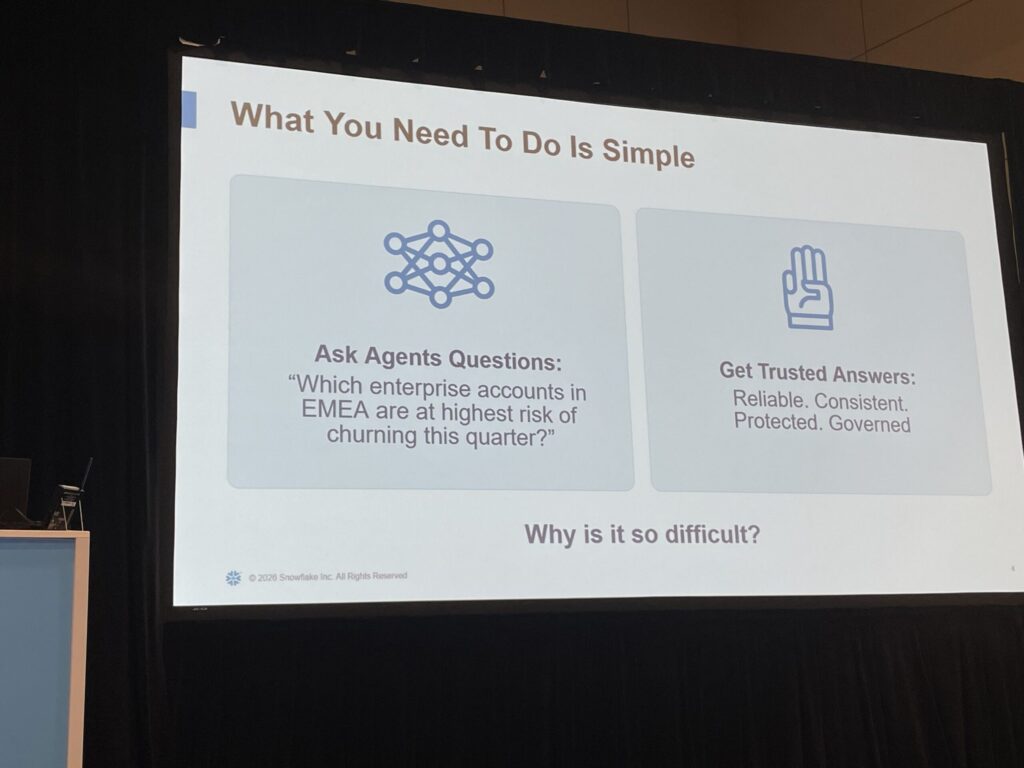
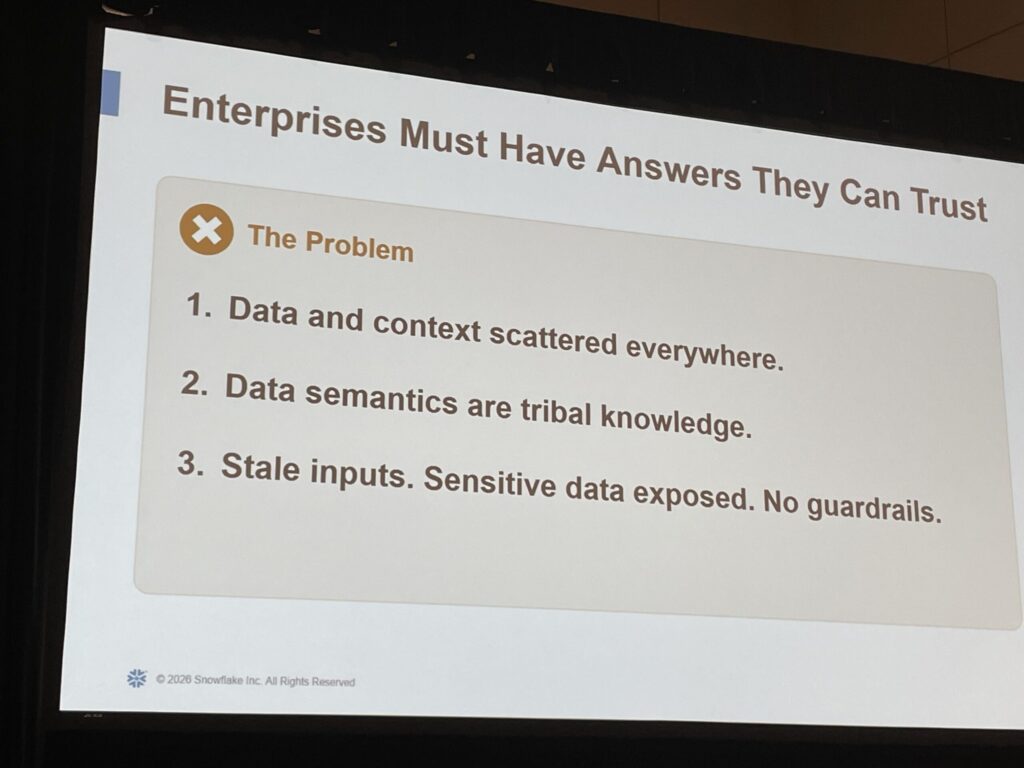
セッション冒頭では、その実現を難しくしている課題が三つに整理されていました。
Data and context scattered everywhere
データとコンテキストが Snowflake 内外のさまざまなシステムに分散している
Data semantics are tribal knowledge
メトリクスやビジネス定義が、一部の人だけが知る暗黙知になっている
Stale inputs / No guardrails
古い入力や機微データ露出、AI 出力へのガードレール不足がある
Horizon Catalogの全体像
この課題に対する Snowflake の答えが Snowflake Horizon Catalog です。スライドでは、Horizon Catalog は「信頼できる回答」のために構築されたユニバーサルなエージェント型カタログとして紹介されていました。
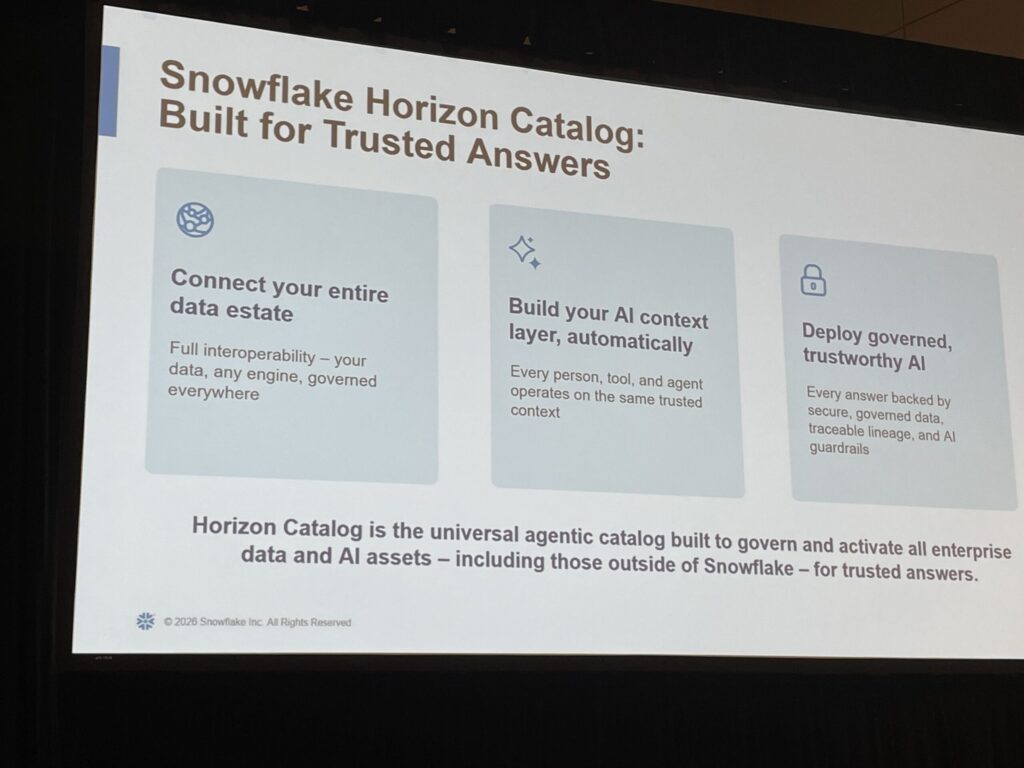
Horizon Catalog が担う役割は、大きく三つに分けられます。
Connect your entire data estate
Snowflake 内外のデータ、SaaS、外部データベース、BI/ETL ツールを接続する
Build your AI context layer automatically
AI や BI が参照する文脈、意味、リネージ、人気度、説明を自動で構築する
Deploy governed, trustworthy AI
セキュアでガバナンスされたデータ、追跡可能なリネージ、AI ガードレールに基づく回答を実現する
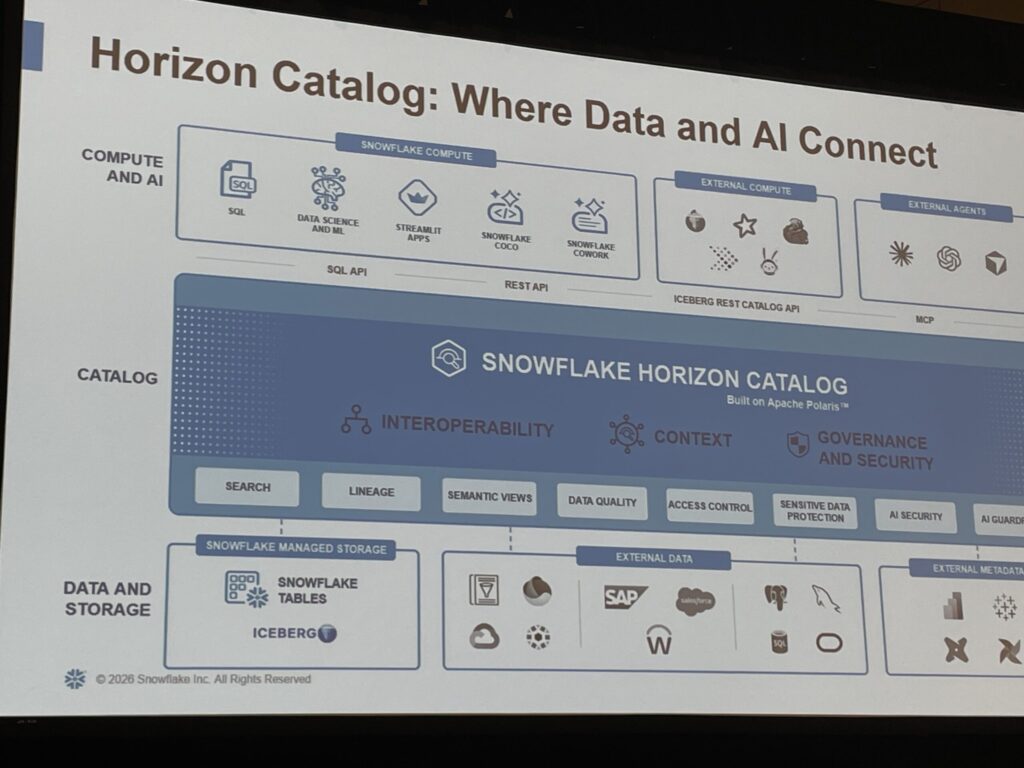
アーキテクチャとしては、上位に SQL、Data Science / ML、Streamlit Apps、Snowflake CoCo、Snowflake CoWork、外部エージェントがあり、その下に Snowflake Horizon Catalog が配置されます。カタログは Apache Polaris を基盤とし、Interoperability、Context、Governance and Security を中核機能として持ちます。
1. 相互運用性:データを動かさず、どこからでも使う
Horizon Catalog の一つ目の柱は Interoperability Without Compromise です。スライドでは「Any data, any engine, any cloud – governed from one place」と表現されていました。
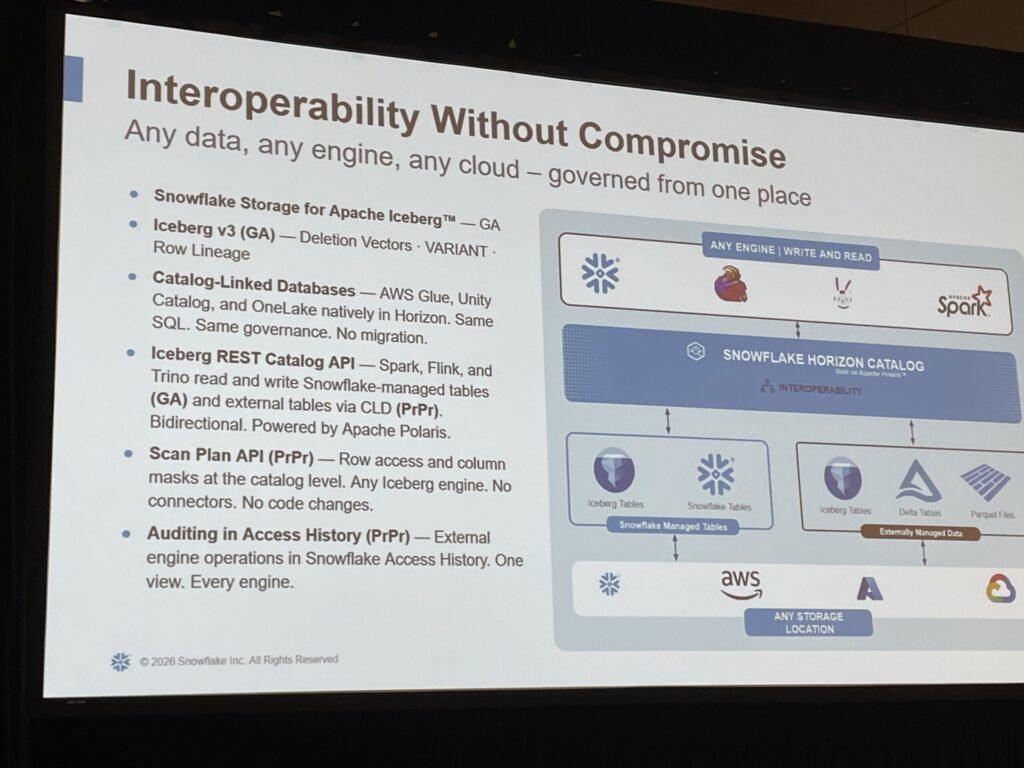
主な機能は次の通りです。
Snowflake Storage for Apache Iceberg
Apache Iceberg 向けの Snowflake Storage。GA
Iceberg v3:Deletion Vectors、VARIANT、Row Lineage に対応。GA
Catalog-Linked Databases:AWS Glue、Unity Catalog、OneLake を Horizon にネイティブ統合。同じ SQL、同じガバナンス、移行不要
Iceberg REST Catalog API:Spark、Flink、Trino などから Snowflake 管理テーブルや外部テーブルを読み書き
Scan Plan API:カタログレベルで行アクセスや列マスクを適用。コネクタやコード変更なし
Auditing in Access History:外部エンジンの操作も Snowflake Access History で監査
ここで重要なのは、Snowflake だけで完結する世界ではなく、Iceberg、外部エンジン、外部ストレージ、外部メタデータを含めて一つのガバナンス面で扱うという考え方です。
SaaS・外部メタデータとの接続
相互運用性は Iceberg だけに閉じていません。SaaS アプリとのゼロコピー統合も紹介されていました。
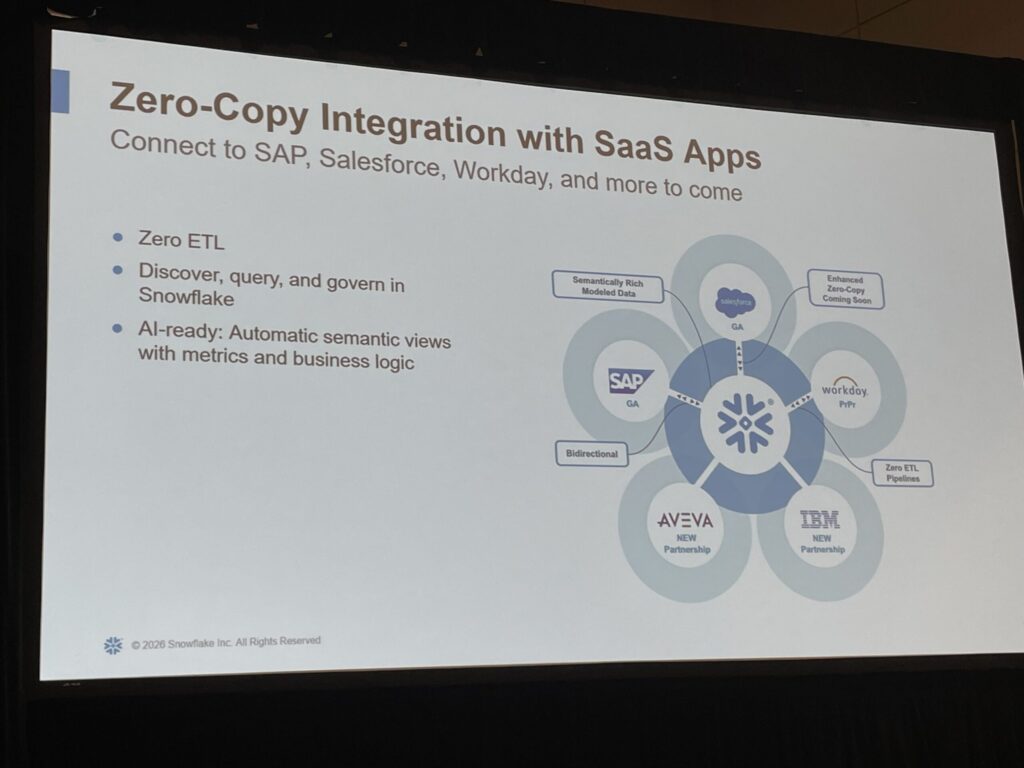
SAP、Salesforce、Workday などの SaaS データを Snowflake へ接続し、データをコピーせずに検出、クエリ、ガバナンスできる構成です。スライドでは、SAP と Salesforce は GA、Workday は Private Preview として示されていました。さらに AVEVA と IBM との新しいパートナーシップも掲載されていました。
また、Select Star の技術を Horizon Catalog にネイティブ統合した Metadata Connectors も紹介されました。
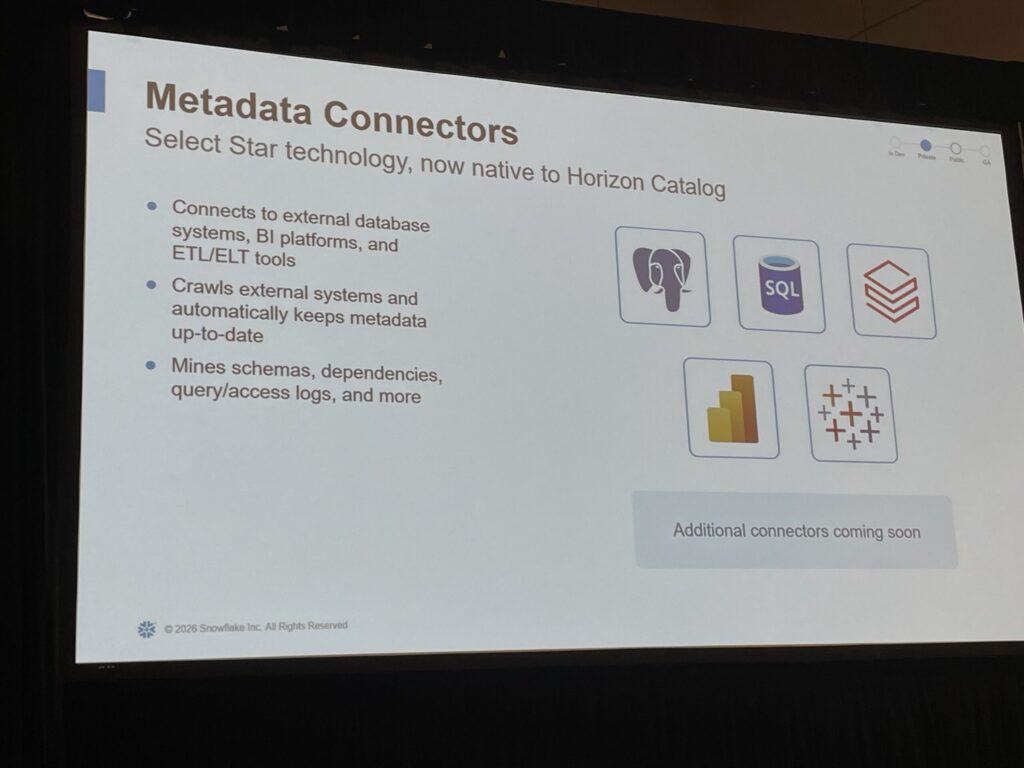
これにより、外部データベース、BI プラットフォーム、ETL/ELT ツールをクロールし、スキーマ、依存関係、クエリログ、アクセスログなどのメタデータを自動的に最新化できます。
Universal Search:データ資産全体を横断検索する
接続されたデータやメタデータは、検索体験にも反映されます。スライドでは Search Across Your Entire Data Estate として、Snowflake と外部システムを横断する Universal Search が紹介されていました。
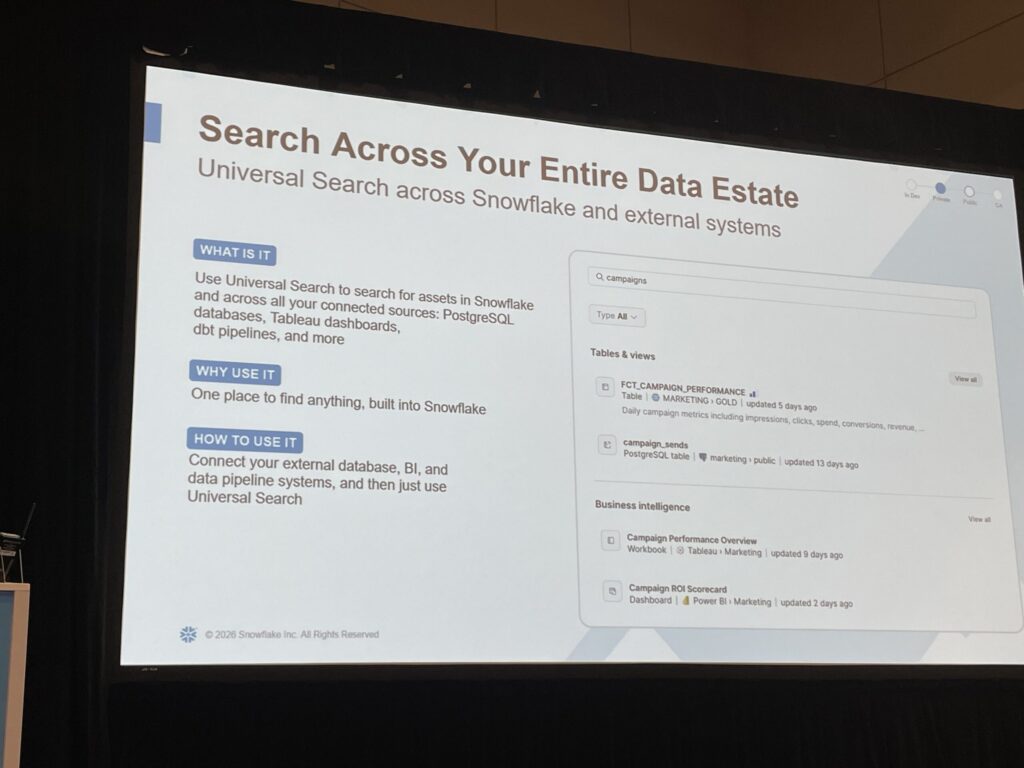
Universal Search を使うと、Snowflake 内のテーブルだけでなく、PostgreSQL データベース、Tableau ダッシュボード、dbt パイプラインなど、接続された外部ソースの資産も同じ場所から検索できます。
デモ画面では campaigns と検索し、Snowflake の FCT_CAMPAIGN_PERFORMANCE テーブル、PostgreSQL の campaign_sends テーブル、Tableau の Workbook、Power BI の Dashboard が同じ検索結果に並んでいました。
これは、データを分析する前段階である「そもそもどこに何があるのか」を探す体験を、Snowflake に集約するものです。データカタログが人間向けの一覧表にとどまらず、AI や BI が参照する文脈の入口にもなっていることがわかります。
Agentic Query:外部データベースにも自然言語で問い合わせる
さらに、Horizon Catalog が見えているデータであれば、Snowflake CoCo が自然言語で問い合わせられるという Agentic Query for External Databases も紹介されました。
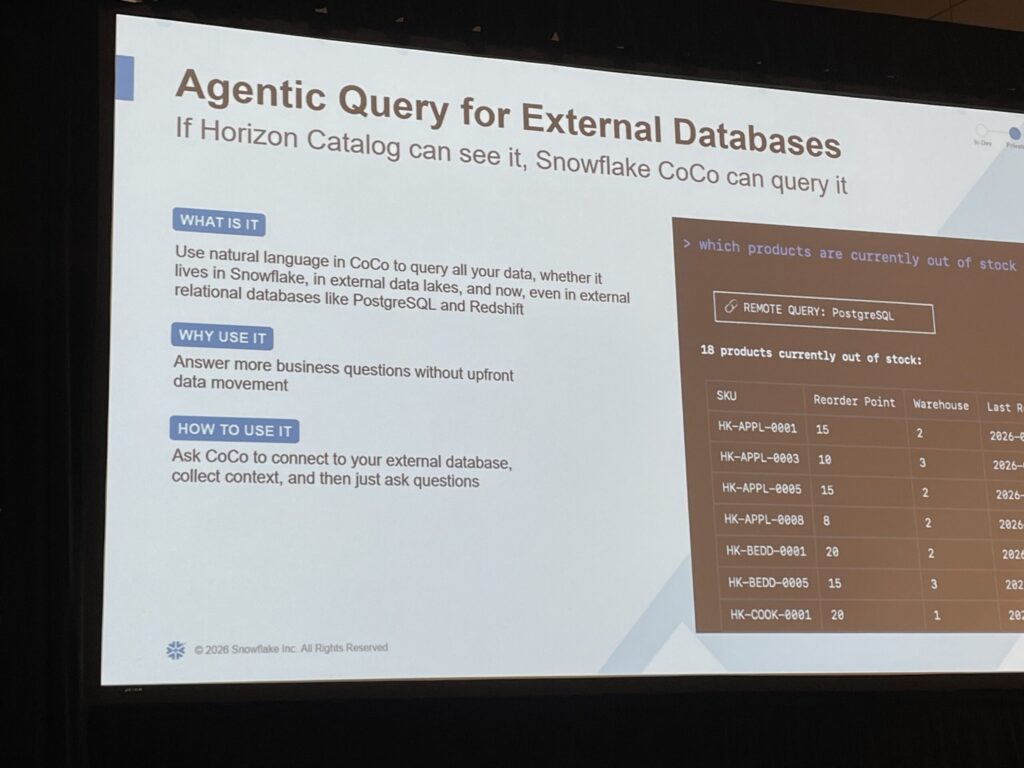
スライドでは「If Horizon Catalog can see it, Snowflake CoCo can query it」と説明されています。Snowflake 内のデータだけでなく、外部データレイクや PostgreSQL、Redshift のような外部リレーショナルデータベースに対しても、自然言語で質問できるという考え方です。
デモでは「which products are currently out of stock」と質問し、PostgreSQL に対するリモートクエリとして、在庫切れの商品一覧を取得していました。
ここでのポイントは、データを事前に Snowflake へ移動しなくてもよいことです。外部データベースに接続し、Horizon Catalog がコンテキストを収集すれば、ユーザーはその後、通常のビジネス質問として問い合わせられます。
2. Horizon Context:AIとBIが読む「文脈」を作る
二つ目の柱は Horizon Context です。スライドでは「Active Context for AI, BI, and Apps」と説明されていました。
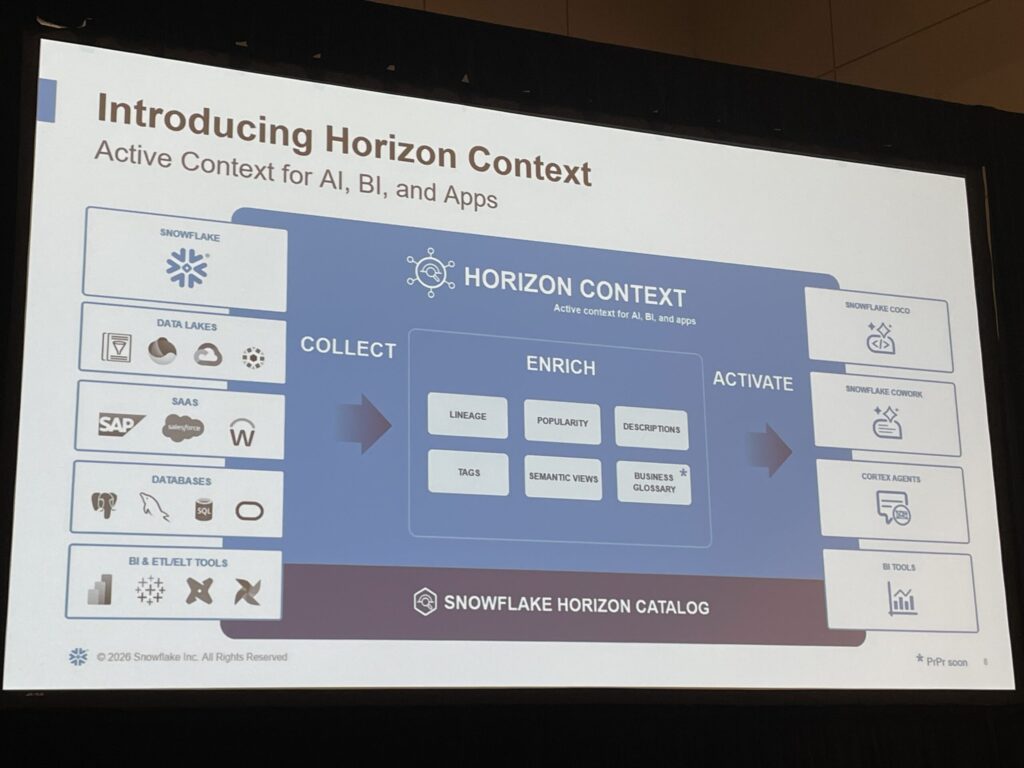
Horizon Context は、分散したシステムからコンテキストを集め、リネージや人気度、説明、タグ、セマンティックビュー、ビジネス用語集で強化し、CoCo、CoWork、Cortex Agents、BI ツールで活用できるようにします。
流れはシンプルです。
“`
Collect -> Enrich -> Activate
“`
より具体的には、次のように整理できます。
Collect
データベーススキーマ、BI セマンティックモデル、メトリクス定義、ダッシュボード、データパイプライン定義、クエリ/利用ログを収集
Enrich
列レベルリネージ、人気度、AI 生成ドキュメント、所有者や認証タグ、セマンティックビューを付与
Activate
CoCo、CoWork、Cortex Agents、BI ツール、外部エージェントがコンテキストを利用
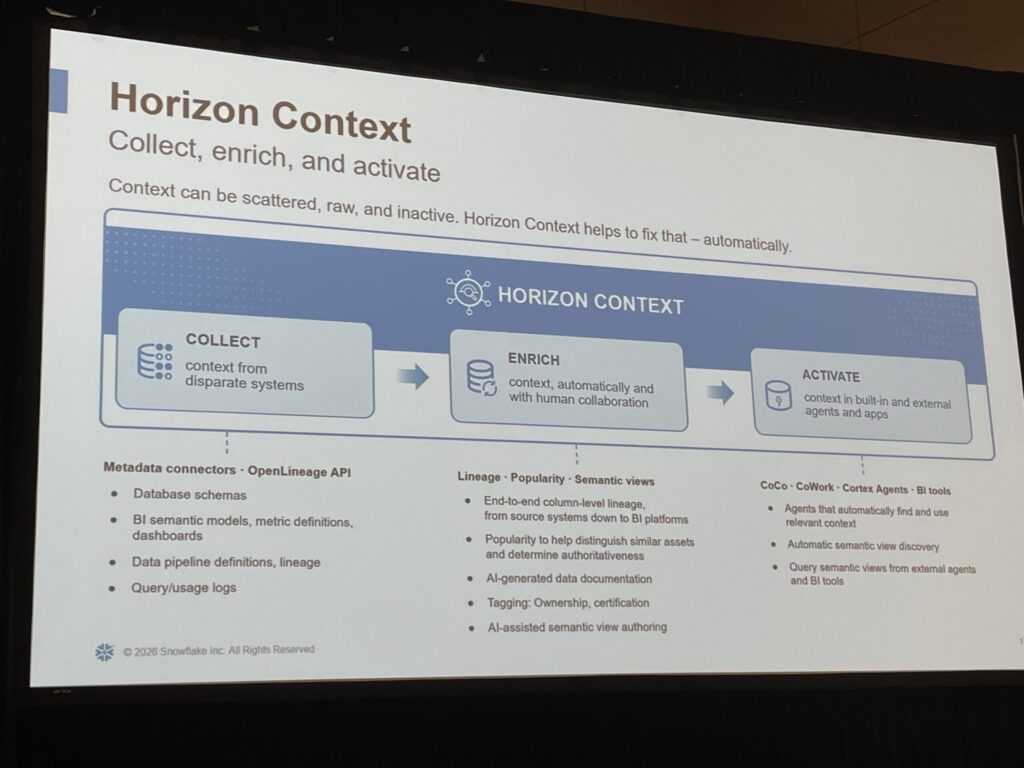
これにより、AI エージェントは「どのテーブルを見ればよいか」だけでなく、「どの定義が信頼できるのか」「どのメトリクスが正式なのか」「BI 出力から元データまでどうつながっているのか」を理解できるようになります。
Semantic Views:AIとBIの単一の定義
Horizon Context の中でも重要なのが Semantic Views です。スライドでは「Every AI agent and BI tool reads from the same source」と表現されていました。
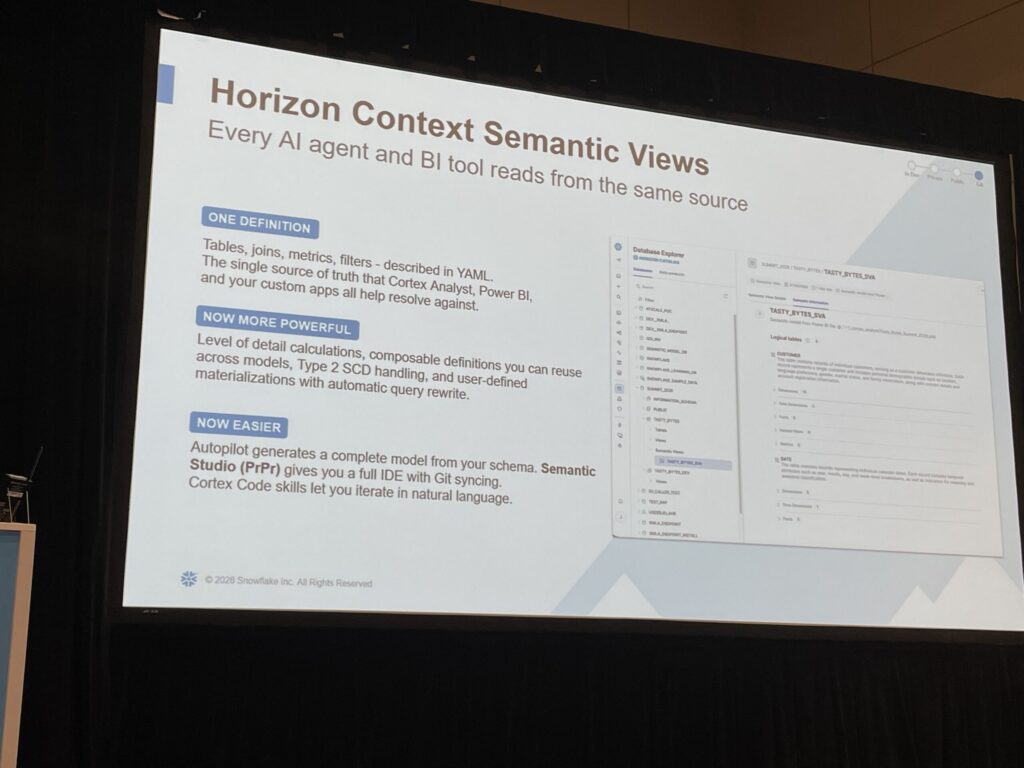
Semantic Views は、テーブル、結合、メトリクス、フィルタを YAML で定義し、Cortex Analyst、Power BI、カスタムアプリなどが同じ定義を参照できる仕組みです。
今回のスライドでは、Semantic Views の強化点として次の内容が紹介されていました。
Level of detail calculations
モデル間で再利用できる composable definitions
Type 2 SCD handling
自動クエリリライト付きの user-defined materializations
スキーマからモデルを生成する Autopilot
Git 同期付き IDE としての Semantic Studio
Cortex Code skills による自然言語での反復改善
AI エージェントが自然言語で回答するとき、同じ意味定義を BI ツールやアプリケーションも参照できるため、「AI の回答とダッシュボードの数値が違う」という問題を減らせます。
クエリ時にコンテキストを自動適用する
さらに印象的だったのが、コンテキストを クエリ時に自動適用する デモです。
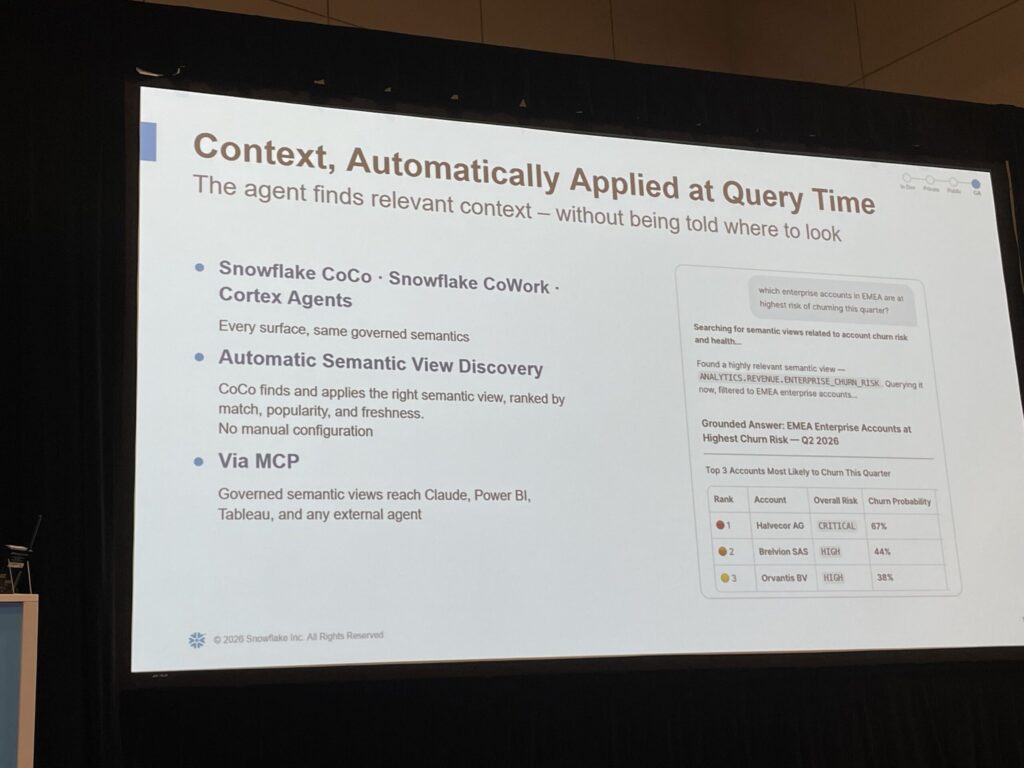
ユーザーが「今四半期、EMEA のエンタープライズアカウントのうち、解約リスクが最も高いのはどれか?」と聞くと、CoCo が関連する Semantic View を探し、マッチ度、人気度、新鮮さに基づいて適切なビューを選びます。
デモではANALYTICS.REVENUE.ENTERPRISE_CHURN_RISK というセマンティックビューを見つけ、EMEA のエンタープライズアカウントに絞ってクエリし、根拠に基づく回答を返していました。
ポイントは、ユーザーが「このビューを使って」と指示しなくても、エージェント側が適切なコンテキストを探索・適用することです。さらに MCP 経由で、Claude、Power BI、Tableau、外部エージェントにもガバナンス済みの Semantic Views を届けられると説明されていました。
Cortex Sense:CoCoとCoWorkのコンテキストランタイム
Horizon Context をさらにリアルタイムに活用するための仕組みとして Cortex Sense も紹介されました。
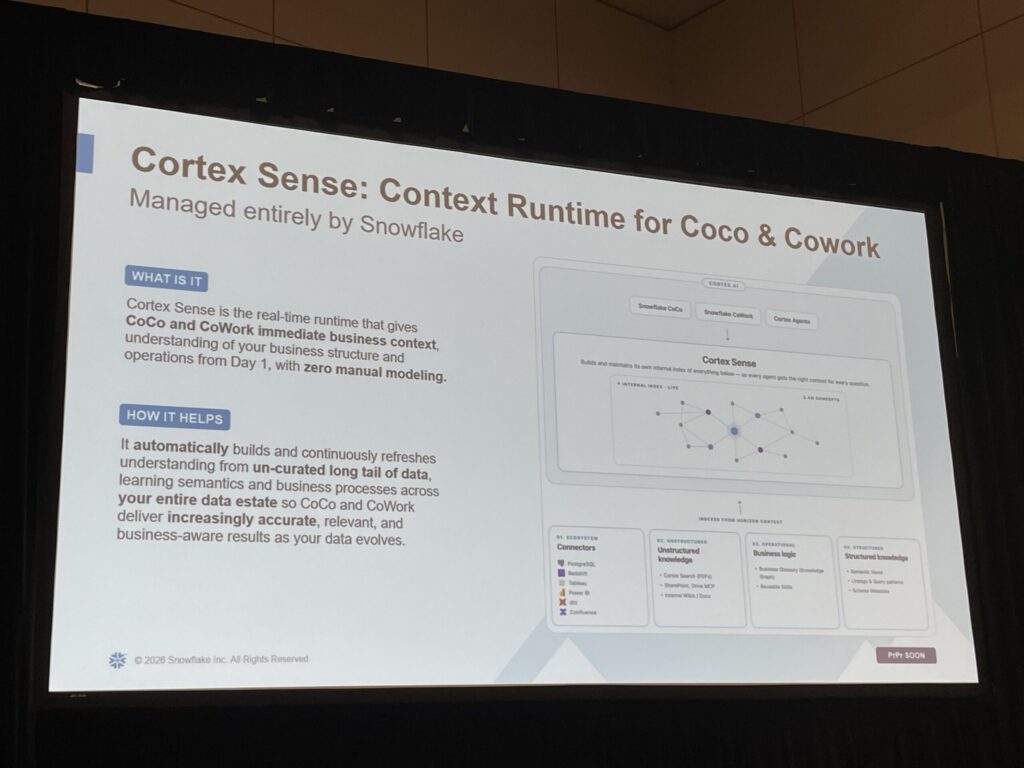
Cortex Sense は、CoCo と CoWork に即座にビジネスコンテキストを与えるランタイムです。Snowflake が完全に管理し、手動モデリングなしで、ビジネス構造や業務プロセスを理解することを目指しています。
スライドでは、Cortex Sense が Horizon Context から次のような情報をインデックス化すると示されていました。
Ecosystem
PostgreSQL、Redshift、Tableau、Power BI、dbt、Confluence
Unstructured
Cortex Search、SharePoint、Drive、MCP、社内 Wiki / Docs
Operations
Business Glossary Knowledge Graph、Reusable Tasks
Structured
Semantic Views、Lineage & Query patterns、Schema Metadata
つまり、エージェントが毎回ゼロから探索するのではなく、企業内のデータ、ナレッジ、業務文脈を継続的に理解していくためのレイヤーです。
3. ガバナンス:信頼できるデータから信頼できる回答へ
三つ目の柱は、ガバナンスとセキュリティです。Horizon Catalog のゴールは、単にデータをつなぐことではなく、ガバナンスされた AI 回答 を返すことです。
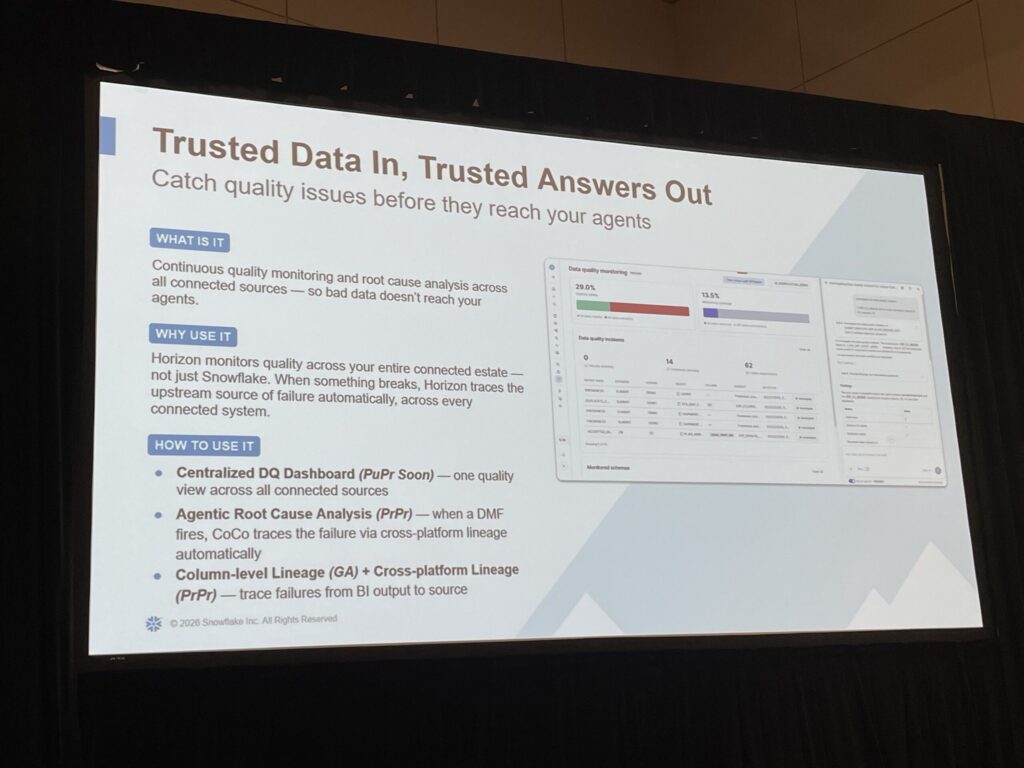
まず紹介されたのが、接続されたすべてのソースを対象にしたデータ品質監視と根本原因分析です。Snowflake 内だけではなく、外部ソースまで含めて品質を監視し、問題が起きたときにはクロスプラットフォームリネージを使って上流の原因を追跡します。
スライドでは次の機能が挙げられていました。
Centralized DQ Dashboard
Agentic Root Cause Analysis
Column-level Lineage
Cross-platform Lineage
AI エージェントに渡る前に品質問題を検知できることは、AI 活用では特に重要です。古いデータや壊れたデータが入力されると、どれだけモデルが優秀でも回答は信頼できません。
機微データ保護とAI Guardrails
次に紹介されたのが、AI を活用した機微データ保護です。
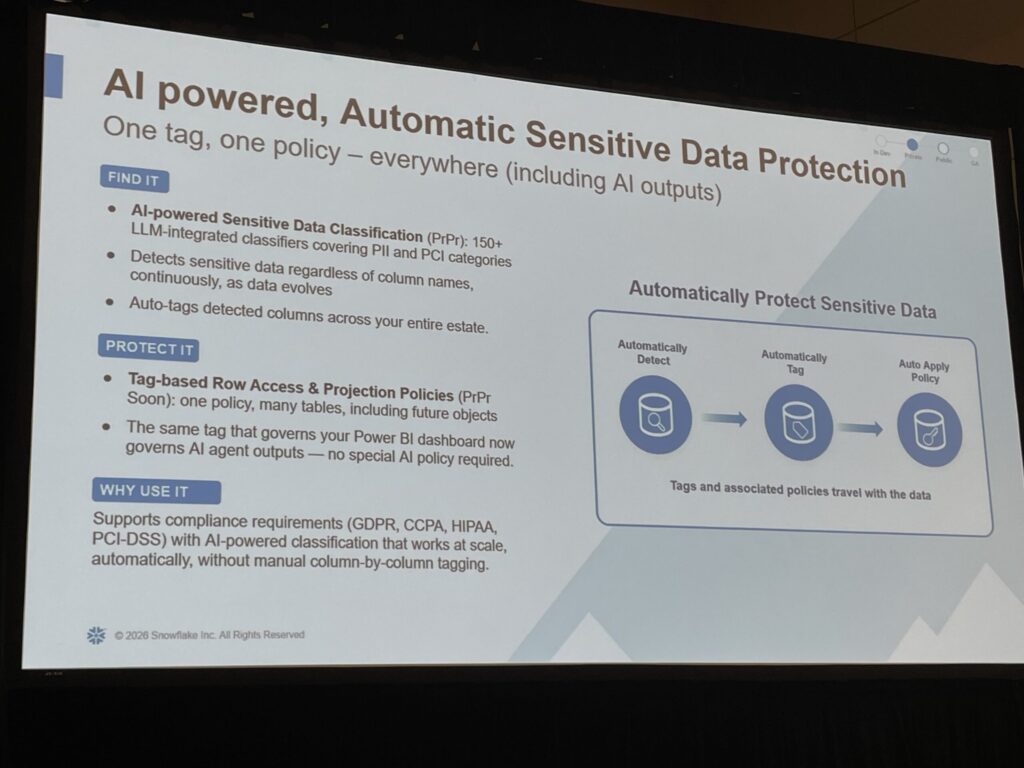
150 以上の LLM 統合分類器により、PII や PCI に該当するデータを列名に依存せず検出し、データ資産全体で自動タグ付けします。さらにタグベースの行アクセスやポリシー適用により、Power BI ダッシュボードを制御する同じタグで AI エージェントの出力も制御できると説明されていました。
そのうえで、Cortex AI Guardrails が AI パイプラインの実行時保護を担います。
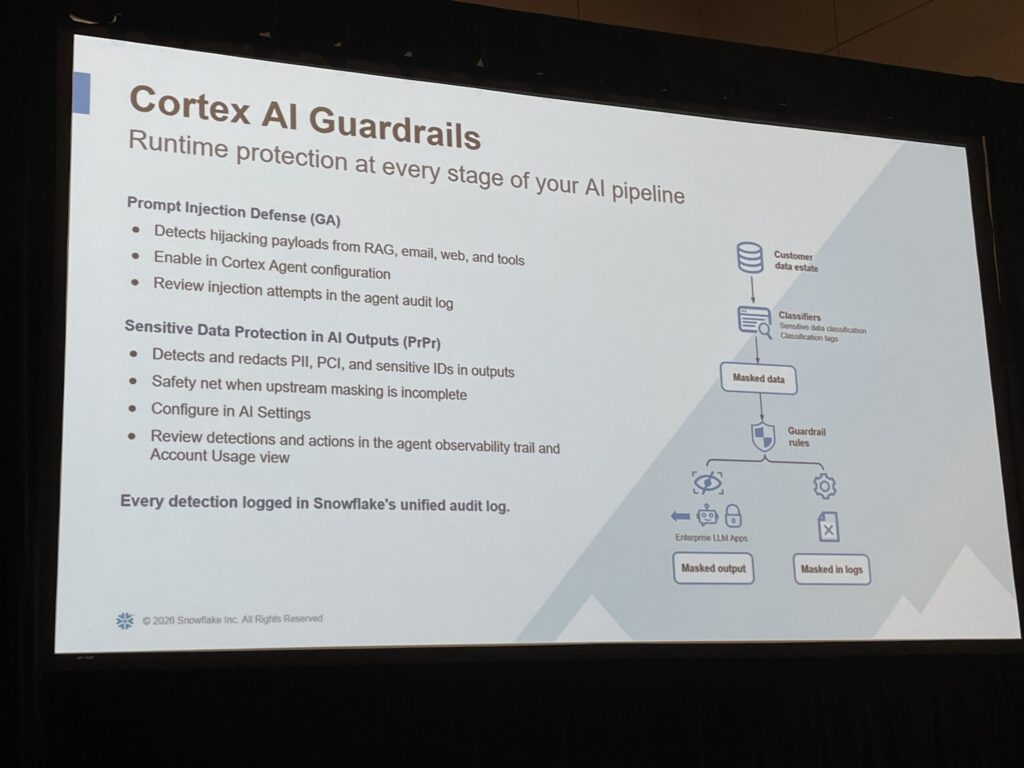
主な内容は次の通りです。
Prompt Injection Defense
RAG、メール、Web、ツール経由のプロンプトインジェクションを検出。GA
Sensitive Data Protection in AI Outputs
AI 出力内の PII、PCI、機微 ID を検出・編集。Private Preview
Unified Audit Log
すべての検出を Snowflake の統合監査ログに記録
AI エージェントの回答そのものだけでなく、回答生成の途中、出力、ログまで含めて保護する点が強調されていました。
Intent-Driven Governance:意図を書くとSnowflakeが実装する
ガバナンスの中でも特に未来感があったのが Intent-Driven Governance です。
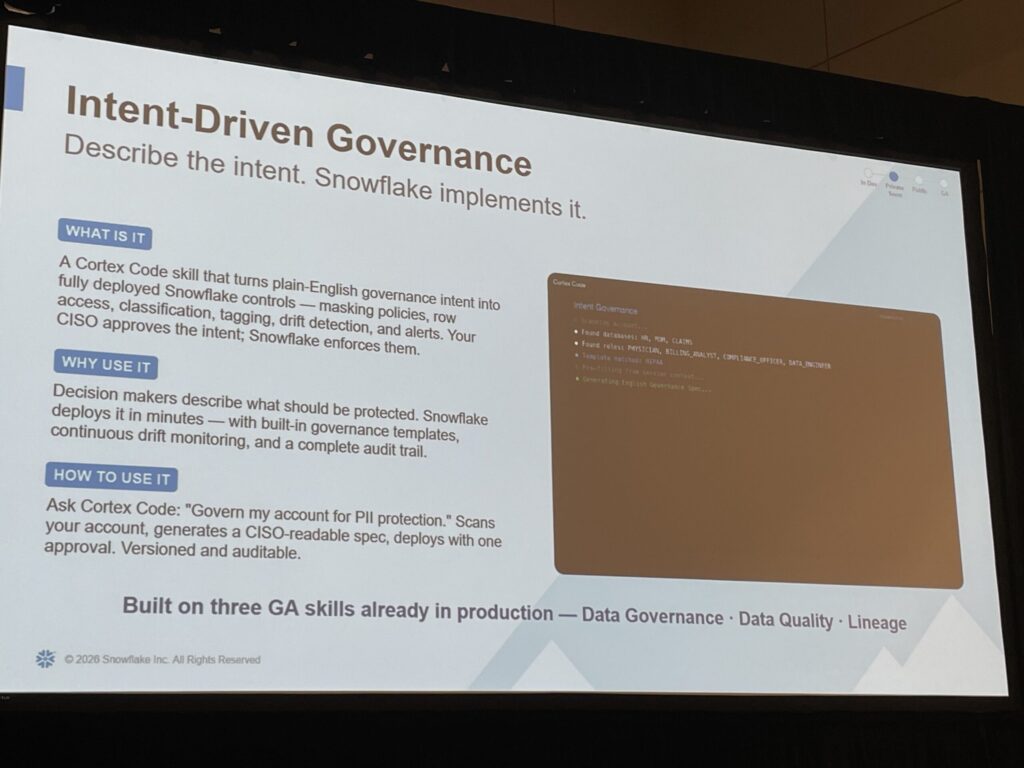
これは、平易な英語で書いたガバナンス意図を、Snowflake の具体的な制御に変換する Cortex Code スキルです。スライドでは次のように説明されていました。
> Describe the intent. Snowflake implements it.
たとえば「PII 保護のためにアカウントをガバナンスして」と依頼すると、アカウントをスキャンし、HIPAA などのテンプレートを照合し、CISO が読める仕様を生成し、承認後にマスキングポリシー、行アクセス、分類、タグ付け、ドリフト検出、アラートを展開するという流れです。
ガバナンス担当者が細かい SQL やポリシー実装を一つずつ書くのではなく、「何を守りたいか」を記述し、Snowflake がそれを実装・監査可能にする方向性が示されていました。
AI Governance:エージェント、スキル、MCPサーバーを可視化する
最後に、AI 資産そのものを可視化・統制する AI Governance も紹介されました。
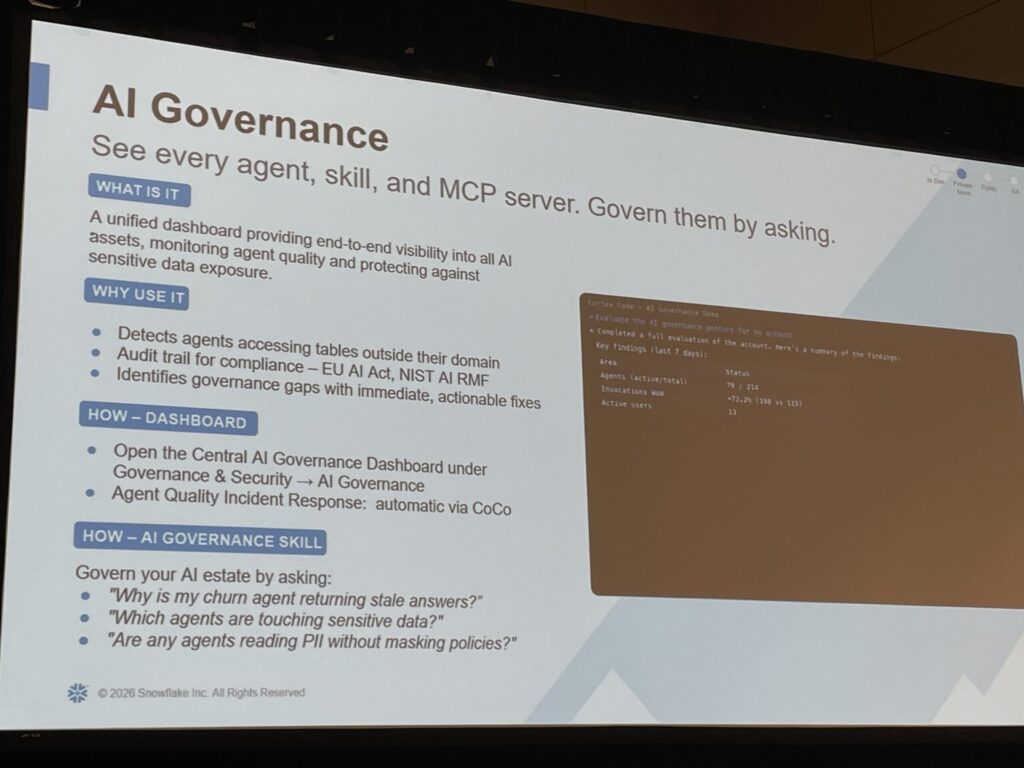
AI Governance は、すべてのエージェント、スキル、MCP サーバーを対象に、エンドツーエンドの可視性を提供する統合ダッシュボードです。
スライドでは、次のような用途が挙げられていました。
エージェントが担当ドメイン外のテーブルにアクセスしていないかを検出
EU AI Act や NIST AI RMF に対応する監査証跡を提供
ガバナンスギャップを特定し、すぐに実行できる修正を提示
CoCo による Agent Quality Incident Response を自動化
さらに、AI Governance Skill に対して次のように質問できる例も示されていました。
> Why is my churn agent returning stale answers?
> Which agents are touching sensitive data?
> Are any agents reading PII without masking policies?
AI エージェントが増えるほど、「誰が何を見ているのか」「どのエージェントが古い回答を返しているのか」「機微データに触れていないか」を把握するのは難しくなります。Horizon Catalog は、AI の利用そのものもガバナンス対象として扱おうとしている点が印象的でした。
まとめ:質問から、ガバナンスされたAI回答へ
セッションの最後では、Horizon Catalog の価値が「From Question to Governed AI Answer」として整理されていました。
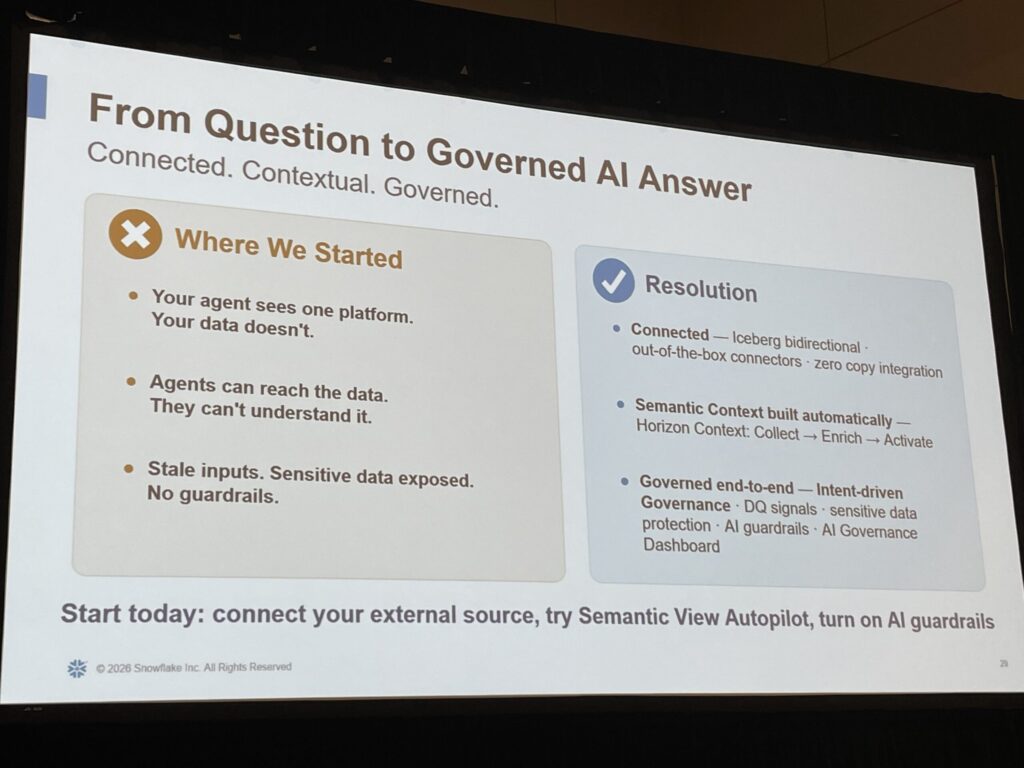
出発点は、次のような状態です。
エージェントは1つのプラットフォームしか見ていないが、データは複数の場所にある
エージェントはデータに到達できても、その意味を理解できない入力が古く、機微データが露出し、ガードレールがない
Horizon Catalog はそれに対して、次の三つで解決しようとしています。
Connected
Iceberg の双方向接続、標準コネクタ、ゼロコピー統合でデータ資産を接続
Semantic Context
Horizon Context により、収集、強化、活用の流れでコンテキストを自動構築
Governed end-to-end
Intent-driven Governance、DQ signals、機微データ保護、AI Guardrails、AI Governance Dashboard で統制
今回のセッションから見えた Horizon Catalog の本質は、単なるデータカタログではなく、AI が企業データを安全に理解し、信頼できる回答を返すための基盤 だということです。
これまでデータカタログは、人間がデータを探すためのものという印象が強かったかもしれません。しかし Horizon Catalog は、AI エージェント、BI ツール、外部エンジン、SaaS、MCP サーバーまで含めて、企業データの意味とガバナンスを届けるレイヤーとして設計されています。
AI 活用が進むほど、単にモデルを導入するだけでは足りません。データが接続され、意味が共有され、品質とアクセスが管理され、出力まで保護されている必要があります。Horizon Catalog は、その全体像を Snowflake の中で実現しようとする大きな一歩だと感じました。