Session report: Zero-ETL Citizen Development onSnowflake: Apps with Postgres and SPCS
こんにちは中村です。
Snowflake Summit 26で弊社の、日本 PostgreSQL ユーザ会の理事長であり、Snowflake Data Superheroes でもある喜田が登壇したので、そのセッション、「Zero-ETL Citizen Development on Snowflake: Apps With Postgres And Snowpark Container Services」のレポートをしていこうと思います。
セッション全体のメッセージは、とてもシンプルです。
> アプリを、データがすでにある場所で作る。
この記事では、セッションで語られた内容をもとに、Snowflake 上で業務アプリを動かす意味、構成要素、Pleasanter を使ったリファレンス実装、そして市民開発がどのように広がっていくのかを整理します。
目次[非表示]
なぜ今この話なのか:OLTP と OLAP の境界が崩れている
セッション冒頭で提示されたテーマは、オペレーショナルシステムと分析システムの境界が崩れつつある というものでした。
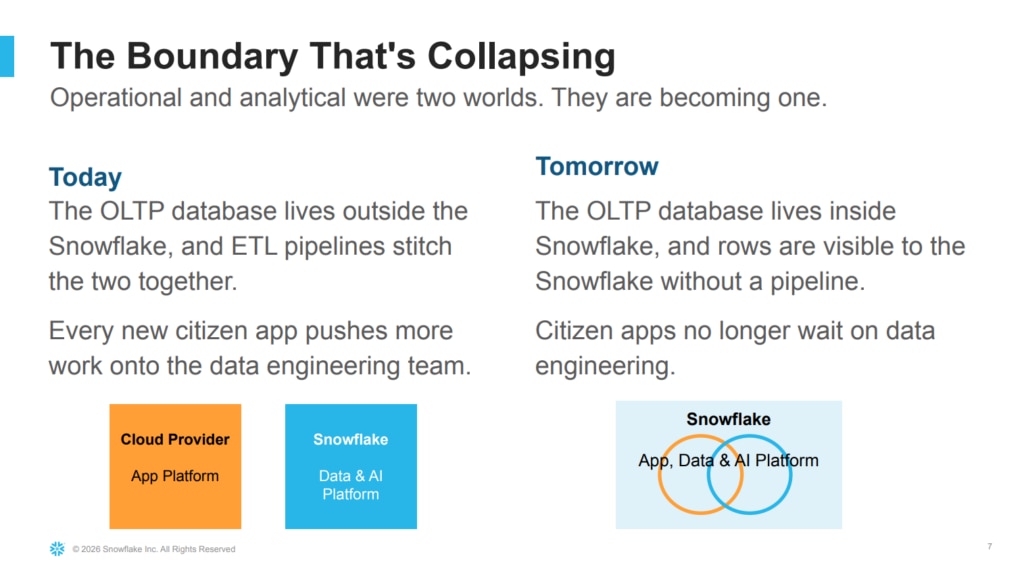
従来の構成では、業務アプリを支える OLTP データベースは Snowflake の外にあります。アプリは外部の PostgreSQL や RDBMS に書き込み、そこから ETL や CDC パイプラインを通じて Snowflake にデータを届けます。
この構成では、新しい市民開発アプリが増えるたびに、データエンジニアリングチームの作業も増えます。アプリを作るだけでは終わらず、分析基盤へデータを渡すためのパイプライン設計、運用、監視が必要になるからです。
一方、Snowflake Postgres が登場すると絵が変わります。業務アプリの OLTP データベース自体を Snowflake の中に置き、そこに書き込まれたデータを Snowflake からパイプラインなしで利用できるようになります。
つまり、アプリ、データ、AI が同じプラットフォームの内側に近づいていきます。これは単に便利なマネージド PostgreSQL が増えた、という話ではありません。20 年近く続いてきた「業務データベースは外、分析基盤は中」という前提が変わる話です。
プラットフォームを支える構成要素
Snowflake Postgres の三つの差別化ポイント
Snowflake Postgres について、セッションでは「もう一つのマネージド Postgres ではない」と説明されていました。差別化ポイントは大きく三つです。
OLAP 王者の OLTP
多くの企業が分析データの行き先として Snowflake を選んでいる。その Snowflake に OLTP が加わることで、トランザクションデータが最初から分析基盤の近くに置かれる
Marketplace 流通の可能性
アプリの実行環境まで抽象化されれば、業務アプリを Snowflake Native App として Marketplace 経由で配布できる可能性がある
真のフルマネージド
VPC、サブネット、バックアップ設計などを意識せず、数クリックで本番データベースを作れる
特に印象的だったのは、インフラ整備にかかる時間の変化です。
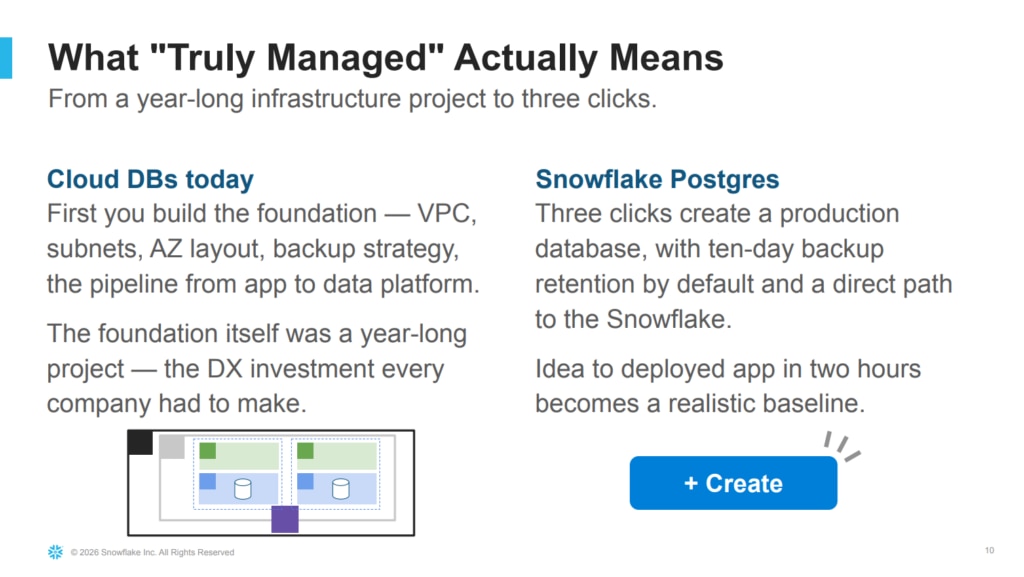
これまで AWS RDS などで業務アプリ基盤を作る場合、まず VPC、サブネット、AZ 構成、バックアップ戦略、Snowflake への連携パイプラインを整える必要がありました。データベース自体の作成は短時間でも、その前提となる基盤整備が大きなプロジェクトになります。
Snowflake Postgres では、データベース作成、デフォルトのバックアップ保持、Snowflake への接続経路がプラットフォーム側に寄せられます。セッションでは、「アイデアからアプリのデプロイまで 2 時間」 が現実的な基準になると語られていました。
これは、市民開発にとって非常に大きな変化です。誰かの小さな業務改善アイデアを試すために、最初から大きな基盤投資をしなくてよくなるからです。
SPCS:データプラットフォームの中でコンテナを動かす
二つ目の構成要素が Snowpark Container Services(SPCS) です。
SPCS を使うと、Web アプリ、MCP サーバー、モデルゲートウェイなど、任意のコンテナイメージを Snowflake の中で動かせます。AWS ECS などで動かすようなコンテナを、Snowflake アカウントの中に配置できるイメージです。
では、なぜ業務アプリを Snowflake の中で動かすのでしょうか。
セッションでは、ビジネスユーザーの視点から説明されていました。AWS アカウントやクラウドインフラは、多くの場合エンジニアの管理領域です。一方、Snowflake はすでに BI、Streamlit、SQL などを通じて、ビジネスユーザーがデータに触れる場所になっています。
SPCS は、その既存のデータ利用面をアプリ実行面に拡張します。業務ユーザーが作った小さなアプリを、普段触っているデータのすぐ隣に置けるようになるわけです。
業務アプリにとって重要な利点は三つあります。
Snowflake 認証済みユーザーだけがアクセスできる
新しいアプリをシャドー IT にせず、最初から監査可能な業務ツールにできる
アプリがデータと同じガバナンス境界に残る
アプリ、データ、AI が同じルールの中で動き、外部 SaaS への不要なデータ送信を避けられる
請求と管理面が一つになる
別クラウドのアカウントや追加の統制面を増やさずに済む
業務アプリ運用で重いのは、アプリのコードそのものよりも、認証、ネットワーク、権限、監査、請求、運用管理といった周辺です。SPCS は、その周辺の多くを Snowflake 側に寄せるための実行基盤として位置づけられていました。
Zero-ETL:消えていく Extract と Load
三つ目の構成要素が Zero-ETL です。
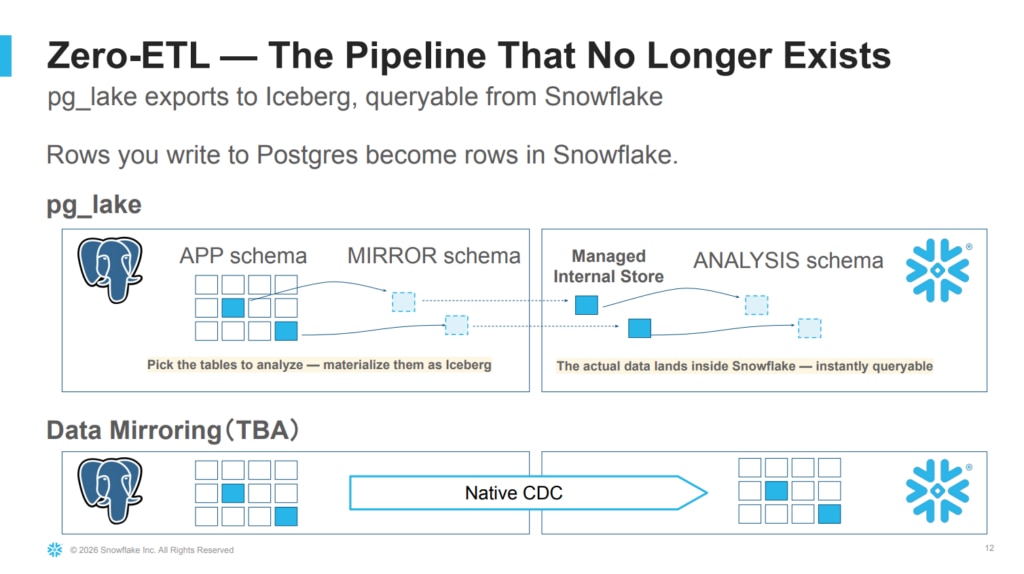
ここでの約束は、Postgres に書き込んだ行が Snowflake から使える行になる、というものです。CDC スケジューラを管理したり、Extract と Load のためのパイプラインを運用したりする負担を減らします。
ただし、セッションでは「Transform まで消えるわけではない」と明確に整理されていました。分析に適した形へデータを整える仕事は残ります。なくなるのは主に、データを取り出して分析基盤に載せるための作業です。
Zero-ETL の経路として、セッションでは二つの方向性が紹介されました。
pg_lake
PostgreSQL 側から分析に必要なテーブルを選び、Iceberg として Snowflake からクエリ可能にする目的特化型の連携
Data Mirroring
PostgreSQL のデータを Snowflake 側へ広く流す、ネイティブ CDC 型の連携
この二つは性格が異なります。
pg_lake では、どのデータを分析に出すかをアプリ側の責務として扱います。すべてを無差別に流すのではなく、業務アプリの文脈を知っている側が、分析に意味のある形でデータを Snowflake に届けます。
一方、Data Mirroring はより汎用的な CDC の方向性です。すべてのデータを Snowflake に流すことで、幅広い用途に対応しやすくなります。
どちらの方式でも共通しているのは、パイプライン維持の負担が下がることです。そして、データ連携が特別なプロジェクトではなく、プラットフォームの性質に近づいていくことです。
課金モデルが市民開発を後押しする
セッションでは、技術だけでなく課金モデルにも触れられていました。
多くの市民開発 SaaS はユーザー数課金です。この場合、営業、マーケティング、バックオフィスのメンバーに広く作成権限を渡すとコストが膨らみます。一方で、コストを抑えるために権限を絞ると、市民開発の価値そのものが出にくくなります。
Snowflake のリソースベース課金では、小さなアプリを必要な時間だけ動かすところから始められます。週に一度、月に一度しか使わないアプリであれば、常時稼働させる必要はありません。
Snowflake Postgres はウェアハウスのように停止できるため、最初は小さく始め、利用が増えてからスペックや可用性を上げる判断ができます。アプリが価値を証明する前に大きなコストを背負わなくてよい点は、市民開発にとって重要です。
課金モデルは、誰が作る側に回れるかを決めます。ここは、技術選定と同じくらい実務的なポイントだと感じました。
リファレンス実装:Pleasanter on Snowflake
後半では、リファレンス実装として日本発の OSS ローコードツール Pleasanter が取り上げられました。
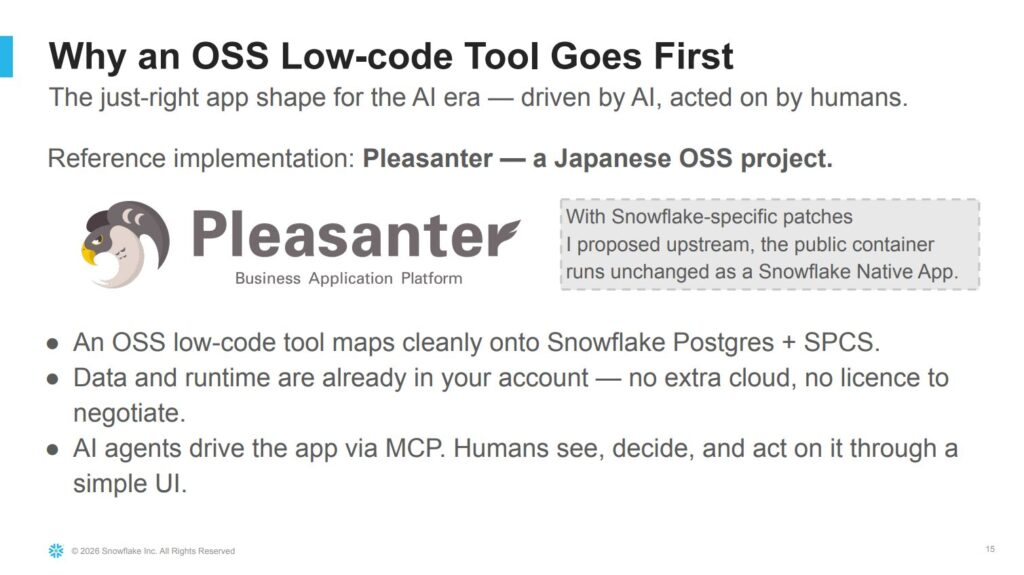
Pleasanter を選んだ理由は、ローコードツールそのものが特別だからではなく、AI 時代の業務アプリ像にうまく合うからです。
これからの業務アプリには、二つの使われ方があります。
AI エージェントが操作するアプリ
人間が見て、判断し、ボタンを押して操作するアプリ
前者には MCP インターフェースが必要です。後者にはシンプルな UI が必要です。Pleasanter のような OSS ローコードツールは、この両方を満たす土台になり得ます。
業務プロセスはアプリとして定義され、AI エージェントは MCP 経由でそこに書き込み、人間は UI で確認して判断します。アプリが AI の長期記憶のように機能し、作業履歴や業務文脈を Snowflake アカウントの中に残していく構成です。
アーキテクチャとしては、次のような流れです。
“`
ユーザー / AI エージェント
↓
Pleasanter on SPCS
↓
Snowflake Postgres
↓
Zero-ETL
↓
Snowflake の分析・AI 機能
“`
アプリが書き込むデータは Snowflake Postgres に入り、そこから Snowflake に届きます。そのデータが、分析や AI による次の改善の材料になります。
デプロイの流れ:コンテナから Native App へ
Pleasanter を Snowflake 上で動かすためのデプロイは、大きく二段階で説明されていました。
–Snowflake オブジェクトを用意する
コンテナイメージを登録し、Compute Pool と Snowflake Postgres インスタンスを作成する
Native App のセットアップ画面で接続する
Streamlit ベースのセットアップ UI から、アプリと Snowflake Postgres の接続情報を設定する
現時点では、SPCS と Snowflake Postgres の接続が完全にネイティブ統合されているわけではないため、接続情報は Snowflake Secrets として保持し、アプリ起動時に参照する形が取られています。
それでも、コンテナイメージ、Compute Pool、Postgres インスタンス、セットアップ UI という構成により、業務アプリを Snowflake Native App として配布、設定、起動する道筋が見えます。
Pleasanter に提案した二つのパッチ
この構成を動かすために、登壇者は Pleasanter の上流に二つのパッチを提案したと説明していました。
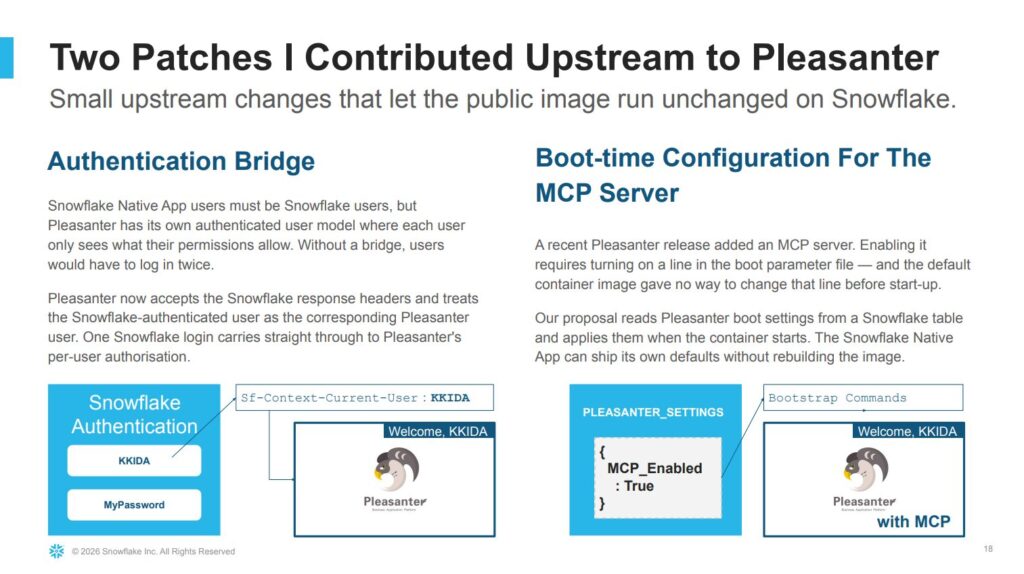
一つ目は 認証ブリッジ です。
Snowflake Native App のユーザーは Snowflake ユーザーとして認証されます。一方、Pleasanter には独自のユーザーモデルと権限管理があります。何もしなければ、ユーザーは Snowflake と Pleasanter の両方にログインする必要があります。
そこで、Pleasanter が Snowflake のレスポンスヘッダーを受け取り、Snowflake で認証済みのユーザーを対応する Pleasanter ユーザーとして扱えるようにします。これにより、Snowflake のログインが Pleasanter 側のユーザー権限にそのままつながります。
二つ目は MCP サーバーの起動時設定です。
Pleasanter には MCP サーバー機能がありますが、有効化には起動パラメータの変更が必要です。標準のコンテナイメージでは、起動前にその設定を変える方法がありませんでした。
そこで、Snowflake テーブルに持たせた起動設定をコンテナ起動時に読み取り、Pleasanter の設定に反映する仕組みを提案しています。Native App の配布者は、コンテナイメージを作り直さずに既定値を差し替えられるようになります。
まだワークアラウンドが必要な点
セッションでは、現時点で Snowflake 側に期待したい改善点も率直に語られていました。
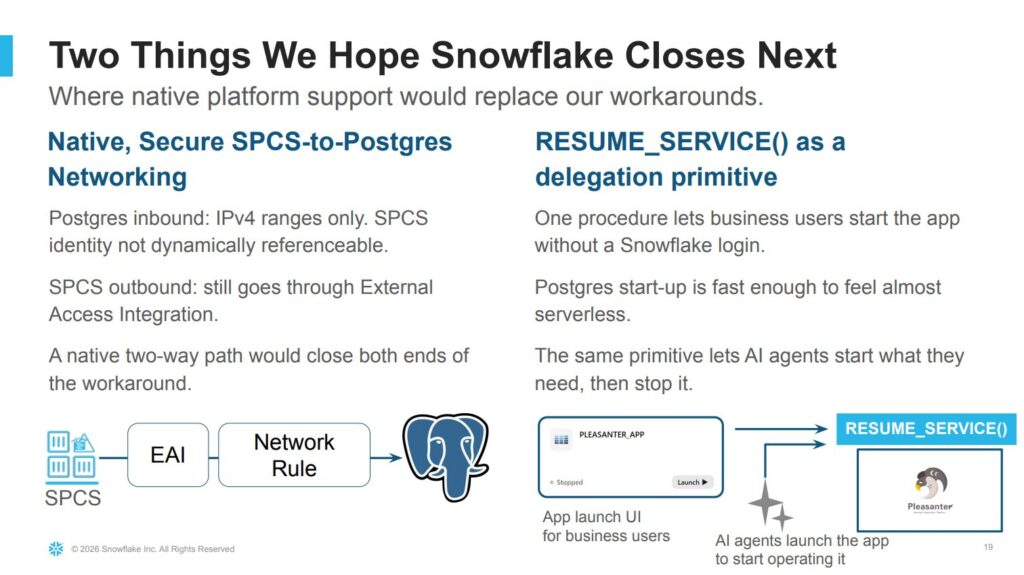
一つ目は、SPCS と Snowflake Postgres の双方向でネイティブかつセキュアな接続 です。
現状では、Postgres のインバウンド許可は IPv4 レンジ指定が中心で、SPCS サービスの ID を動的に送信元として扱うことが難しいと説明されていました。また、SPCS から Postgres へ出ていく通信側も External Access Integration を経由する必要があります。
この両端のワークアラウンドがなくなり、SPCS と Snowflake Postgres の間にネイティブな安全経路ができれば、構成はさらにシンプルになります。
二つ目は、RESUME_SERVICE を委譲のためのプリミティブとして使うこと です。
Native App 内に RESUME_SERVICE プロシージャを置き、その実行権限だけを業務ユーザーに渡せば、ユーザーは Snowflake に直接ログインせずにアプリ、Compute Pool、Snowflake Postgres を起動できます。
Postgres の起動が十分速ければ、体感としてはほぼサーバーレスに近くなります。さらに、AI エージェントに「このアプリを起動して」と頼むと、必要なリソースを起動し、処理を行い、終わったら止めるという世界も見えてきます。
デモで見る市民開発体験
デモ1:議事録がチケットになる
一つ目のデモは、会議の議事録から Pleasanter のチケットを作成する というものでした。
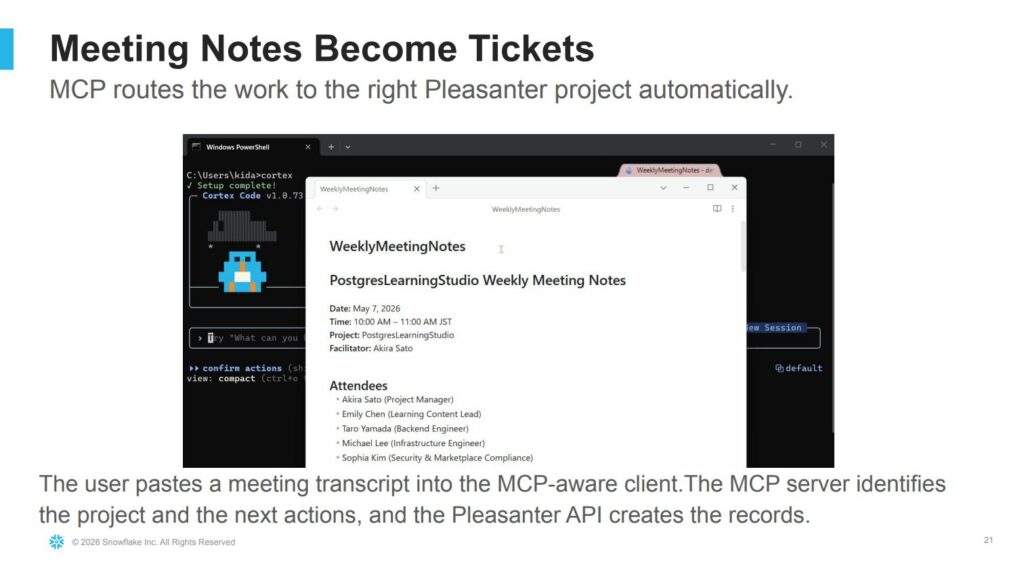
ユーザーが MCP 対応クライアントに会議の文字起こしを貼り付けます。MCP サーバーが内容を読み取り、該当するプロジェクトと次のアクションを特定します。そして Pleasanter API がレコードを作成します。
重要なのは、この一連の流れが Snowflake アカウントの境界内で完結することです。
ETL はありません。Webhook で外部 SaaS に飛ばす必要もありません。ユーザーの「この議事録を整理して」という一つの意図が、Pleasanter の行として残ります。
デモ2:Cortex が顧客履歴を事前入力する
二つ目のデモは、顧客面談の日報を作るときに、過去の文脈を Cortex AI Functions が事前入力する というものです。
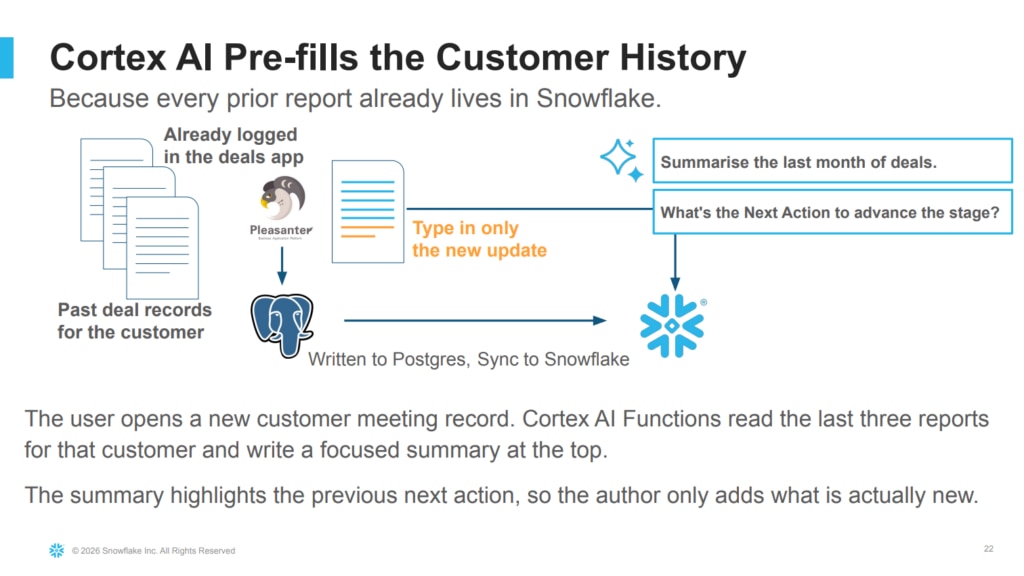
ユーザーが新しい顧客面談レコードを開くと、Cortex AI Functions がその顧客の直近三件のレポートを読み取り、要点を冒頭に要約します。前回のネクストアクションも強調されるため、ユーザーは本当に新しい情報だけを追記すればよくなります。
ここでもポイントは、過去のレポートがすでに Snowflake 上の行として存在していることです。モデルを別途デプロイする必要も、外部にデータを渡す必要もありません。データがある場所で、そのまま AI が支援します。
アプリ自身の利用データが次の改善の材料になる
これらのデモが示しているのは、単なる入力補助ではありません。
業務アプリが Snowflake Postgres にデータを書き込み、そのデータが Snowflake に届くようになると、アプリ自身の利用データも次の改善サイクルの材料になります。
たとえば、次のような情報です。
誰が、どの業務で、どのアプリを使っているか
どのページやレコードが閲覧、更新されているか
どの業務フローに時間がかかっているか
どの業務構造を見直すと効果が大きいか
従来の DX では、現場の小さな改善アイデアを IT で拾い、効率化し、そこから出てきたデータを次の改善に使う、というループが目指されてきました。
このセッションで示されたのは、そのループの AI 時代版です。アプリが業務を進め、アプリがデータを残し、AI がそのデータを読んで次の業務改善を支える。ここに Zero-ETL の意味があります。
ローコードを超えて:好きなアプリを好きな形で作る
Pleasanter はあくまでリファレンス実装です。セッションの後半では、ローコードに限らない二つのアプリ例も紹介されました。
コミュニティミートアップ中に音声をリアルタイムで文字起こしし、後からレビューやブログ化に使える形で残すアプリ
英語プレゼン練習用に、スライド台本に対して音声認識を行い、ペースや発音のフィードバックを返すアプリ
どちらも Pleasanter 上で作ったものではなく、自分で作ったアプリです。
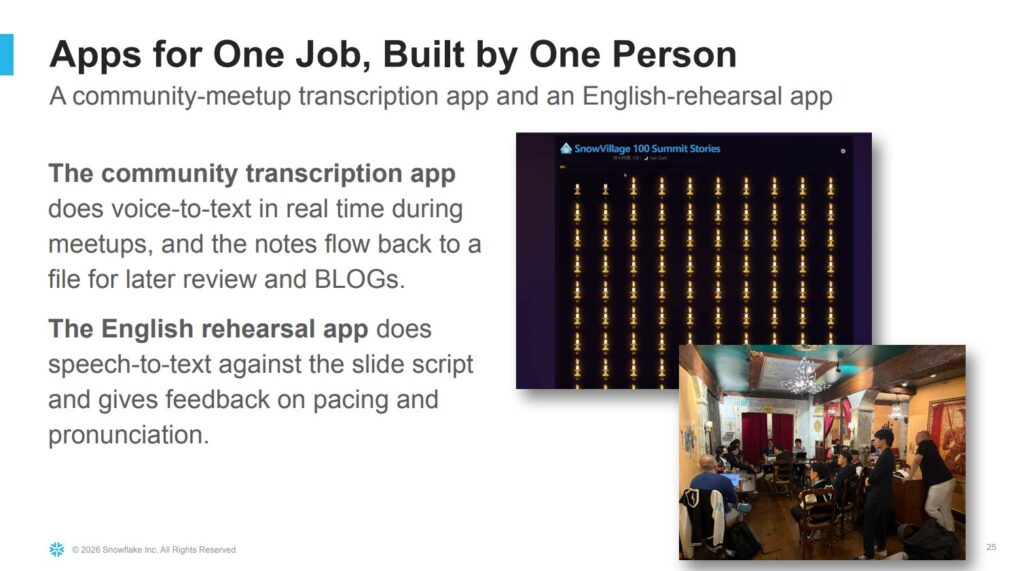
ここで強調されていたのは、作るものはローコードに縛られない という点です。Claude、Vercel、好きなフレームワーク、どのような作り方でもよい。コンピュートは SPCS、状態管理は Snowflake Postgres に置けば、別のクラウドアカウントやインフラ議論を増やさずに済みます。
自分の作業を少し楽にするために作ったアプリが、隣の同僚へ、チームへ、部門へ、全社へと広がっていく。その途中でデプロイの基本形が変わらないことが、Snowflake 上で業務アプリを動かす価値として語られていました。
成長段階ごとの同じデータパス
セッションでは、アプリが広がっていく段階も整理されていました。
スタート
Snowflake Postgres を小さく使い、SPCS と Streamlit を組み合わせる
pg_lakeがデータを運ぶ
部門スケール
Postgres を M や L に拡張しつつ、SPCS と Streamlit の形は維持する
全社スケール
Postgres を XL にし、必要に応じて AWS も組み合わせる。ガバナンスや共有サービスが加わる
ハイパースケール
NewSQL や AWS ネイティブ構成が主 OLTP になる場合もある。ETL や CDC は必要な場所でだけ使う
重要なのは、アイデア段階から大規模展開まで、データの通り道の考え方が大きく変わらないことです。
小さく始め、価値が出たらスケールし、必要なところだけ専用構成にする。その間、アプリデータが Snowflake に届き、分析と AI の材料になるという基本線は維持されます。
まとめ:アイデアがアプリになり、アプリがデータを生み、AI が業務を支える
今回のセッションを通じて、持ち帰るべきポイントは三つだと感じました。
アイデアがアプリになる時代
業務を知っている人が、自分の改善アイデアをアプリとして形にできる
データがすでにある場所でアプリを動かす
Snowflake Postgres と SPCS により、アプリ、データ、AI を同じガバナンス境界に近づけられる
Zero-ETL が改善ループを回す
アプリが生んだデータが Snowflake に届き、Cortex や分析の材料になる
Snowflake Postgres、SPCS、Zero-ETL は、それぞれ単独でも強力な機能です。しかし、このセッションで面白かったのは、それらをつなげて 「業務アプリを Snowflake 上で作り、動かし、AI が読み書きできるようにする」という一つの世界観として見せていた点です。
AI 活用というとチャットや検索に目が向きがちですが、実際の業務では「日々の作業を進めるアプリ」と「そこに蓄積されるデータ」が重要になります。
そのアプリをデータの近くに置き、AI が自然に読み書きできる状態にする。Snowflake Postgres と SPCS、そして Zero-ETL がそろうことで、市民開発は単なる小規模アプリ作成ではなく、業務改善のデータ循環を作る取り組みに変わっていくのだと感じました。