コーディングエージェント用語解説
コーディングエージェント、使ってますか
私はプライベートでも、ゲーム開発、ローカル便利アプリ開発、ナレッジ蓄積、資格勉強の壁打ちなどで、AIをかなりヘビーに使い倒しています。
AIで作ったキャラクターに過度な感情移入をしてしまう、AIの利用時間が1日のほとんどを占める、といった話も見かけるようになりました。今では「AI依存症」という、いかにも新たなお金の匂いがする言葉まで生まれています。
良くも悪くも、それくらいAIの利用は社会に浸透してきました。
とはいえ、Xで驚き屋さんたちのポストを見ていると、「よくわからない単語が飛び交っている」と感じる方も多いかもしれません。
OpenAIがFable 5をリリースするとかいう、本当によくわからないことを言っている(自動と思われる)アカウントもありますが、それは一旦脇に置いておくことにします。
コーディングエージェント、Tool Calling、プロンプト、RAG、MCP、ハーネス。
なんとなく聞いたことはあるが、それぞれ何が違うのかはよくわからない。そんな状態になりがちです。
この記事では、コーディングエージェントの周辺で飛び交っているAI関連用語について、単なる言葉の意味だけでなく、実際にどのようなファイルやプログラムが動いているのかまで含めて整理します。
AIをなんとなく使う段階から、もう少し構造的に理解して使う段階へ進むための助けになれば幸いです。
目次[非表示]
エージェントって?
エージェントという概念は、LLM以降に突然生まれたものではありません。
古典的なAIでは、エージェントは、環境を知覚し、その環境に対して行動するものと説明されます。
そのうち合理的エージェントは、これまでに得た知覚や環境についての知識をもとに、性能評価基準の期待値が高くなる行動を選びます。
強化学習の文脈では、環境から報酬を受け取り、将来を含む累積報酬の期待値が大きくなるように行動方針を学習します。
現在流行しているLLMベースのAIエージェントも、この考え方の延長にあります。
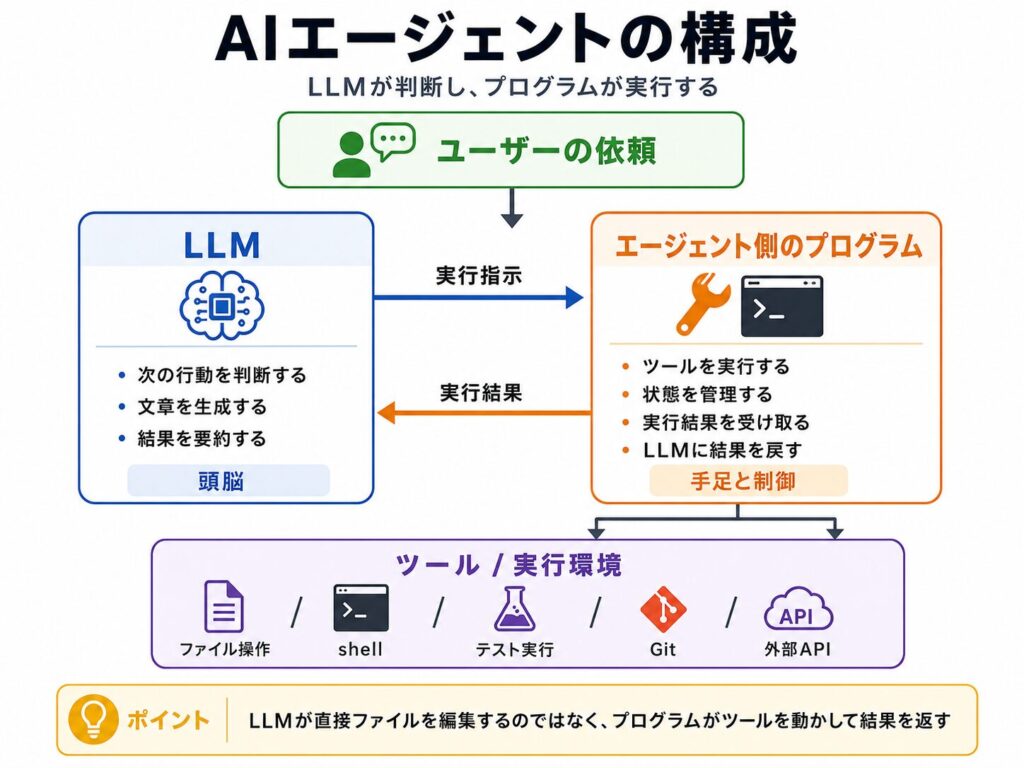
LLMは、ユーザーの依頼や作業中の情報を読み取り、「次に何をするべきか」を判断します。
ただし、LLMそのものが直接ファイルを編集したり、コマンドを実行したり、GitHubのIssueを読みに行ったりするわけではありません。
LLMはあくまで、次に取るべき行動を決めます。
実際の実行は、エージェント側のプログラムが行います。
現在よく使われる方式は、Tool Calling / Function Calling と呼ばれるものです。
これは、LLMにあらかじめ「使えるツールの一覧」を渡しておき、LLMが必要に応じて「このツールを、この引数で呼び出してほしい」と返す仕組みです。
エージェント側に次のようなツールが用意されています。
- `read_file(path)`
- `search_files(query)`
- `edit_file(path, diff)`
- `run_shell(command)`
- `run_tests(command)`
Step1. 指示を解釈する
ユーザーが「このバグを直して」と依頼すると、LLMはまず状況を読み取り、「関連ファイルを探すべきだ」と判断します。
エージェント側のプログラムが、実際にファイル検索ツールを実行します。
検索結果が返ってくると、その結果をまたLLMに渡します。
Step2. ファイル読み込みと出力
LLMは、「このファイルを読むべきだ」と判断します。
エージェント側のプログラムがファイル読み取りツールを実行し、ファイル内容をLLMに渡します。
Step3. ファイルの修正
LLMが、「この部分を修正すべきだ」と判断すると、エージェント側のプログラムがファイル編集ツールを実行します。
このように、AIエージェントは次のようなループで動いています。
超簡易な擬似コードを用意するとしたら以下のようになります。
messages = [
    {"role": "user", "content": "ログイン処理のバグを直して"}
]

tools = {
    "read_file": read_file,
    "search_files": search_files,
    "edit_file": edit_file,
    "run_tests": run_tests,
}

while True:
    # 1. LLMに現在の状況を渡す
    response = call_llm(
        messages=messages,
        tools=tools.keys()
    )

    # 2. LLMが「ツールを使いたい」と返した場合
    if response.type == "tool_call":
        tool_name = response.tool_name
        arguments = response.arguments

        # 3. 実際の処理はローカルのプログラムが実行する
        result = tools[tool_name](**arguments)

        # 4. 実行結果をLLMに戻す
        messages.append({
            "role": "tool",
            "name": tool_name,
            "content": result
        })

        continue

    # 5. LLMが最終回答を返したら終了
    if response.type == "final_answer":
        print(response.content)
        break
考え方自体はかなりAPIに近いです。
あらかじめ「使えるツールの一覧」と「それぞれの引数の形」をLLMに渡しておきます。
エージェント側のプログラムが、指定された引数でツールを実行し、その実行結果をLLMに戻すイメージです。
この意味では、LLMは自然言語を解釈し、次に呼び出すツールと引数を選ぶ、確率的で動的なディスパッチャ/プランナーのように振る舞います。
プロンプト
LLMに渡す指示文を指します。
ユーザーが入力する文章だけでなく、システム側であらかじめ与えられる指示、出力形式の指定、禁止事項、役割設定などもプロンプトに含まれます。
以下のような指示をすることが一般的でしょう。
あなたはこのリポジトリを修正するコーディングエージェントです。
まず関連ファイルを読み、必要最小限の差分で修正してください。
ファイルを変更した場合は、可能な範囲でテストを実行してください。
実行できなかった場合は、その理由を報告してください。
このような指示を毎回チャットで書くのは面倒です。
そこで、コーディングエージェントでは、プロジェクト内にエージェント向けの指示ファイルを置くことがあります。
代表的なものが AGENTS.md や CLAUDE.md です。
AGENTS.md は、AIコーディングエージェント向けのREADMEのようなものです。
AGENTS.mdの公式サイトでも、AGENTS.mdはエージェント向けのREADMEとして、AIコーディングエージェントがプロジェクトで作業するための文脈や指示を置く場所だと説明されています。
なお、対応するファイル名は製品によって異なります。CodexはAGENTS.mdを読み、Claude CodeはCLAUDE.mdを読みます。AGENTS.mdという名前だけで、すべてのコーディングエージェントが自動的に読むとは限りません。
コーディングエージェントでは、AGENTS.md や CLAUDE.md のような指示ファイルを、エージェント側のプログラムが読み取り、その内容をLLMへのコンテキストとして渡す実装がよく見られます。
次のような内容を書いておくと良いでしょう。
# AGENTS.md

## Project overview

このリポジトリは、社内向けのデータ連携基盤です。
主に Python, TypeScript, Snowflake, dbt を使用します。

## Commands

- install: `pnpm install`
- lint: `pnpm lint`
- test: `pnpm test`
- typecheck: `pnpm typecheck`
- dbt compile: `dbt compile`

## Coding rules

- 既存の設計に合わせる
- 大きな責務変更を勝手に行わない
- public APIを変更する場合は影響範囲を説明する
- SQLでは暗黙的な型変換に注意する

## Safety rules

- `.env` や秘密情報を出力しない
- 本番DBへの書き込みを行わない
- 破壊的な変更は、実行前に確認を求める
ただし、これらは強制設定ではなく、LLMに対する指示です。
本当に強制したいことは、設定ファイルだけでなく、ハーネス、サンドボックス、OSやIAMの権限、CI、hooksなど、実行環境側の仕組みで制約する必要があります。
Codexであれば、承認ポリシー、サンドボックスのモード、MCPサーバーなどは、AGENTS.mdではなくconfig.toml側の領域です。
この設定ファイルは、LLMに到達する前にエージェント側のプログラムによって読み込まれます。
そして、サンドボックス、承認ポリシー、利用可能な接続先などの実行条件を決め、エージェント側のプログラムが「何を実行できるか」「何を実行させないか」を制御します。
LLMは「このツールをこの引数で実行してほしい」と返します。
しかし、その指示がそのまま実行されるとは限りません。
エージェント側のプログラムは、設定ファイルやポリシーを確認し、その操作を許可するかどうかを判定します。
許可されていない操作であれば実行しません。
承認が必要な操作であれば、ユーザーに確認します。
つまり、LLMは実行したい操作を提案しますが、実行可否はエージェント側の実行基盤によって判定されます。必要に応じて人間の承認が求められ、最終的にはサンドボックスやOS、IAMの権限によって実行可能な範囲が制限されます。
RAG
RAGは Retrieval-Augmented Generation の略で、日本語では検索拡張生成と呼ばれることがあります。
名前はやや大げさですが、やっていることは比較的シンプルです。
LLMが回答や判断をする前に、外部の文書やデータベースから関連情報を検索し、その検索結果をLLMに渡す仕組みです。
コーディングエージェントにおける挙動
コーディングエージェントで考えると、RAGのイメージはかなり掴みやすくなります。
たとえば、ユーザーが次のように依頼したとします。
> ログイン処理のバグを直してこのとき、LLMが最初からリポジトリ全体の中身を知っているわけではありません。
そこでエージェント側のプログラムが、ファイル検索や読み取りを行います。
たとえば、内部的には次のような流れになります。
ユーザーの依頼
  ↓
関連しそうなキーワードで検索する
  ↓
該当するファイルを読む
  ↓
必要な部分をLLMに渡す
  ↓
LLMが内容を解釈する
  ↓
次に読むべきファイルや修正箇所を判断する
もう少し具体的に言えば、grep や ripgrep で関連ファイルを探し、cat や read_file のような仕組みで中身を読み、その内容をLLMのコンテキストに入れます。
search_files("login redirect")
  ↓
src/auth/login.ts が見つかる
  ↓
read_file("src/auth/login.ts")
  ↓
ファイル内容をLLMに渡す
  ↓
LLMがコードを読んで判断する
つまり、LLMがローカルファイルを直接覗いているわけではありません。エージェント側のプログラムがファイルを読み、そのテキストをLLMに渡しています。
ただし、指定された1つのファイルを読むだけなら、通常は「ファイル読み込み」や「コンテキスト取得」と呼びます。
大量の仕様書やソースコードから、質問やタスクに関連する箇所を検索して取り出し、その断片をLLMに渡す場合に、RAGという呼び方がより適切になります。
コーディングエージェントにおけるgrep、コード検索、LSP、シンボルインデックスなどを使った情報取得は、広い意味ではRAG的な処理と考えられます。
RAGらしくなるのは、大量の文書やコードの中から、関連しそうな部分を検索して取り出し、LLMに渡す場合です。
仕様書なら、見出しや段落単位で検索すればよいことが多いです。
一方でソースコードでは、ファイル名、関数名、クラス名、import、呼び出し関係、型定義、テストとの対応などを見る必要があります。
コーディングエージェントでは、次のような検索手段が組み合わされます。
- ファイル名検索
- grep / ripgrep
- import / reference検索
- 関数名やクラス名の検索
- LSPによる定義ジャンプ
- ASTやsymbol index
- Embedding検索
- Issue / PR検索
コーディングエージェントで言えば、リポジトリやドキュメントの中から必要な文脈を探し出し、LLMに渡す仕組みだと考えると分かりやすいでしょう。
検索の効率化
以下のようなCode Mapを用意し、AGENTS.mdから参照先として示しておくとよいでしょう。小規模なものであれば最初に読ませても構いませんが、大規模なプロジェクトでは必要なときだけ参照させる方が効率的です。
なお、Code Mapが古くなるとエージェントを誤った場所へ誘導するため、コード変更に合わせて更新する必要があります。
# Code Map

## 認証

- `src/auth/login.ts`
  - ログイン処理
  - redirect先の決定
- `src/auth/session.ts`
  - セッション作成・検証
- `src/middleware.ts`
  - 未ログイン時のredirect

## ユーザー管理

- `src/users/service.ts`
  - ユーザー取得・更新
- `src/users/repository.ts`
  - DBアクセス

## API

- `src/app/api/users/route.ts`
  - ユーザーAPI
- `src/app/api/auth/route.ts`
  - 認証API
MCP
MCPは Model Context Protocol の略です。
RAGやエージェントと一緒に語られることが多いですが、MCPはRAGそのものでも、エージェントそのものでもありません。
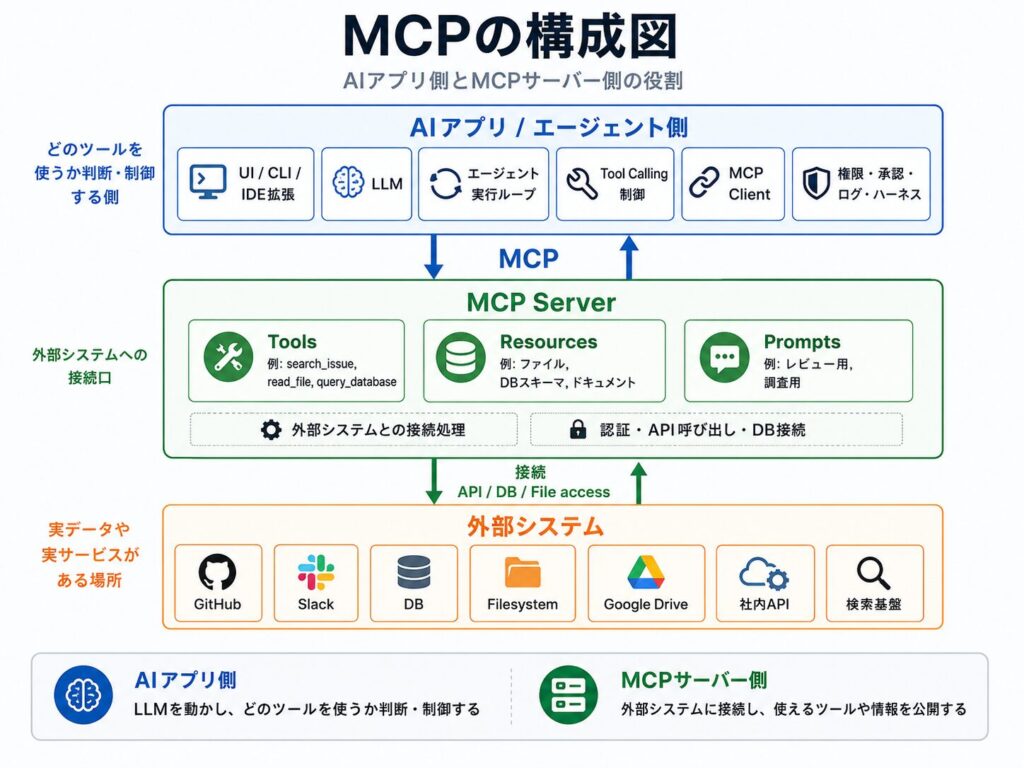
MCPは、AIアプリケーションが外部ツールや外部データソースに接続するための標準プロトコルです。
エージェントをGitHub、Slack、Google Drive、社内DB、ローカルファイル、チケット管理ツールなどに接続したい場合、その接続口を標準化しています。
Tool Callingが「LLMがどのツールを呼ぶかを選ぶ仕組み」だとすれば、MCPは「ツールの発見・呼び出し・結果の受け渡しを、AIアプリと外部サーバーの間で標準化する仕組み」です。
Resources、Prompts、Toolsが主要な要素として定義されています。
大まかな構成図は以下です。
認証はどこで管理すべき?
MCPを使う場合、GitHub、Slack、DB、Google Driveなどの外部サービスに接続するための認証情報が必要になります。
ここで重要なのは、認証情報をLLMに持たせないことです。
LLMにAPIキーやアクセストークンを読ませる必要はありません。
LLMは「Issueを検索したい」「DBスキーマを取得したい」「Slackに投稿したい」といったツール呼び出しを提案します。
実際に認証情報を使って外部サービスへ接続するのは、MCPサーバー側、またはMCPサーバーが参照するSecret ManagerやOAuthトークンストアです。
基本の役割分担はこうです。
LLM:
  認証情報を持たない
  ツール呼び出しを判断する

AIアプリ / MCP Client:
  MCP Serverへ接続する

MCP Server:
  外部サービスへの接続処理を担当する
  必要な認証情報を使ってAPIやDBにアクセスする

Secret Manager / OAuth Token Store:
  APIキー、OAuth token、DB接続情報などを保管する
例: Lambdaでやるとしたら
参考例に、Lambdaでやるとしたらどうする?を考えてみます。
必ずしも最適解ではないので、あくまで一例として捉えてください。
認証情報はLLMではなくLambda側で扱います。
たとえば、GitHubやSlack、DBに接続するMCPサーバーをLambdaで作る場合、構成は次のようになります。
AIアプリ / エージェント
  ↓
MCP Client
  ↓
API Gateway / Lambda Function URL
  ↓
Lambda上のMCP Server
  ↓
AWS Secrets Manager
  ↓
GitHub / Slack / DB / 社内API
この場合、GitHub tokenやSlack token、DB接続情報などは、Lambdaのコードやプロンプトに直接書きません。
Secrets Managerに保存しておき、Lambdaの実行ロールに必要なsecretだけを参照できる権限を付与します。
Secrets Manager:
  認証情報を保存する

Lambda実行ロール:
  必要なsecretだけ参照できる

Lambda上のMCP Server:
  Secrets Managerから認証情報を取得する
  その認証情報を使って外部APIやDBに接続する

LLM:
  認証情報は見ない
  MCPサーバーが返した実行結果だけを見る
Lambdaでは、Streamable HTTPを使ったステートレスなリモートMCPサーバーとして実装するのが比較的わかりやすいでしょう。ただし、長時間のストリーミングや状態を持つセッションが必要な場合は、別の実行基盤も検討する必要があります。
ハーネス
エージェントは、LLMを中心にツールを使いながら作業する仕組みです。
RAGは、必要な情報を外部から検索してLLMに渡す仕組みです。
MCPは、外部ツールや外部データソースに接続するための標準的な口です。
では、それらを実際にどう安全に動かすのでしょうか。
ここで出てくるのが、ハーネスです。
ハーネスという言葉は、やや広く使われます。
コーディングエージェントの文脈では、エージェントを動かすための実行基盤、制御基盤のようなものだと考えると分かりやすいです。
LLMが「このファイルを編集したい」「このコマンドを実行したい」「このMCPサーバーを呼びたい」と判断したとしても、それをそのまま実行してよいとは限りません。
ハーネスは、その間に入って以下のようなものを制御します。
- どのツールを使わせるか
- どの操作を許可するか
- ユーザー承認を求めるか
- どの環境で実行するか
- 実行結果をどうLLMに戻すか
- ログをどう残すか
- 機密情報をどう隠すか
LLMがツール呼び出しを返したとき、ハーネスはすぐにコマンドを実行するのではなく、設定やポリシーを確認します。
このコマンドは許可されているか。
作業ディレクトリは安全か。
ネットワークアクセスは必要か。
ユーザー承認が必要な操作ではないか。
ログに残すべき内容は何か。
問題なければ、ハーネスはコマンドを実行します。
実行結果が返ってきたら、そのstdoutやstderrをLLMに渡します。
逆に、危険な操作であれば止めます。
エージェントの安全性はLLMの自制心だけに頼るものではありません。
実行前に止める仕組み、実行範囲を制限する仕組みが必要です。
ポリシーを確認しているのは、基本的には普通のプログラムです。
ハーネスは起動時に設定ファイルを読み込み、利用可能なツール、書き込み可能な場所、ネットワークアクセス、承認が必要な操作などを内部の設定として保持します。
あとがき: 「あんなこといいな、できたらいいな」を実現しよう
コーディングエージェントは万能ではありませんが、実用レベルにはなってきました。
ただし四次元ポケットのように、なんでも出してくれるものではありません。
エージェントにできるのは、あくまで「与えられた環境の中で、使える道具を使い、与えられた情報をもとに作業すること」です。
AIだからといって、汚部屋に放り込まれて完璧に片付けられるわけではありません。
まず足の踏み場を作る必要があります。
地味な準備がコーディングエージェントの実力を左右するほか、出来上がったものは人間の目を必ず通すことが大切です。
コーディングエージェントは、「あんなこといいな、できたらいいな」をかなり現実に近づけてくれます。
以前なら「時間ができたらやる」と積まれていたものを、実際に動く形へ持っていきやすくなりました。
これからの時代は「やりたいこと」がある人が強い時代だと個人的には考えています。