今だからこそ学ぶオントロジー
オントロジーとは
オントロジー(ontology)とは元々、哲学用語で存在論を意味する言葉です。
ざっくり言えば、「何が存在するのか」「存在するものはどのような種類に分けられるのか」「それらはどのような性質や関係を持つのか」を考える分野です。
情報科学におけるオントロジーは、この問いをもう少し実務的に引き寄せたものです。
つまり、ある業務領域において、何を存在するものとして扱うのか。
それらを何と呼び、どう分類し、互いにどう関係づけるのか。
そして、その意味を人間にもコンピューターにも扱える形で明示するものです。
たとえば「顧客」「案件」「契約」「請求」「ユーザー」といった言葉は、社内では当たり前のように使われます。
しかし、それぞれが何を指すのか、どの粒度の概念なのか、どのシステムのどのデータと対応するのかは、必ずしも自明ではありません。
オントロジーは、こうした概念と関係を整理するための、意味の設計図です。
ただし、ここで扱うオントロジーは、OWL/RDFで厳密に記述された形式オントロジーというより、業務で使いやすい lightweight ontology、つまり概念・関係・物理マッピングを整理した意味定義書に近いものです。
目次[非表示]
バベルの塔の寓話
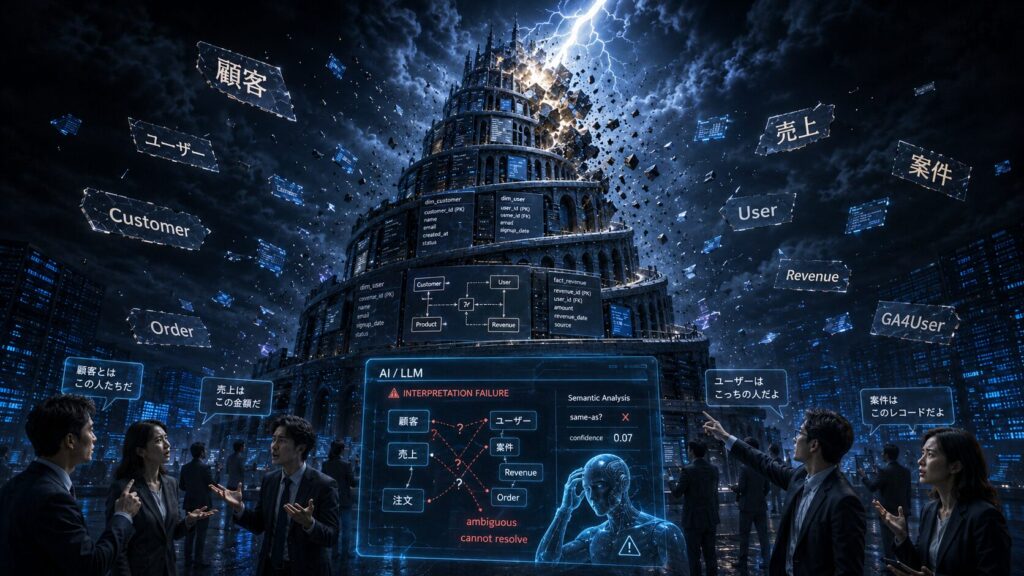
バベルの塔の寓話では、人々は同じ言葉を使って塔を建てようとしました。
しかし、言葉が乱されたことで互いに意思疎通できなくなり、建設は止まってしまいます。
これは、現代のデータ基盤でも他人事ではありません。
同じ「顧客」という言葉を使っていても、営業、経理、サポートで指しているものが違う。
同じ「ユーザー」という言葉を使っていても、EC、GA4、認証基盤で意味が違う。
同じ「売上」という言葉を使っていても、税込、税抜、キャンセル後、出荷後で定義が違う。
言葉は同じでも、意味が違う。
この状態でデータをつなぎ、AIに読ませると、混乱はそのまま再生産されます。
オントロジーは、この小さなバベルを避けるために、言葉が指す概念と関係を明示する考え方です。
分類学で考えてみる
ヒト(Homo sapiens)はヒト属(Homo)に属する、現在唯一の現生種です。
もう少し分類をたどると、ヒト属はヒト科に属し、ヒト科は霊長目に属し、霊長目は哺乳綱に属します。
ここでは説明を簡略化して、主要な階級だけを示します。
実際の分類では、亜門・亜綱・亜目・上科・亜科・族などを挟む場合があります。
真核生物
 └── 動物界
      └── 脊索動物門
           └── 哺乳綱
                └── 霊長目
                     └── ヒト科
                          └── ヒト属
                               └── ヒト(Homo sapiens)
このような分類は、「その対象が何の仲間なのか」を理解するうえで非常に強力です。
ヒトは哺乳類であり、霊長類であり、ヒト科の生物である。
分類をたどることで、対象の位置づけが見えてきます。
「ヒト」は「哺乳類」の一種である。
このような関係を is-a と呼びます。
タクソノミーでは、主にこの is-a 関係を使って、概念を階層的に整理します。
一方で、「指」は「手」の一部であり、「手」はヒト個体の身体の一部です。
このような部分と全体の関係は part-of と呼びます。
指 part-of 手
手 part-of 身体
身体 part-of ヒト個体
ここで注意しておきたいのは、次のような関係は成り立たないことです。
× 指 is-a 哺乳綱
× 指 part-of 哺乳綱
「指」は哺乳綱の一種ではありません。
また、「指」は哺乳綱の一部でもありません。
他に混同しやすいものとして、具体的な個体と分類の違いがあります。
× 忠犬ハチ公 is-a 犬
○ 忠犬ハチ公 instance-of 犬
自然言語では「ハチ公は犬である」と言えるので少しややこしいですが、ここでいう is-a は、自然言語の “A is a B” ではなく、概念同士の subclass 関係を指します。
ハチ公は一個体であり、犬の下位分類ではありません。
したがって、厳密には is-a ではなく、具体例を表す instance-of として扱います。
オントロジーでは、このように関係の種類を明示するだけでなく、その関係がどの種類の概念同士に使えるのかも考えます。
業務概念で考えてみる
業務でよく扱う概念を、少し単純化して整理すると次のようになります。
株式会社〇〇 instance-of 法人顧客
法人顧客 is-a 顧客
部署 part-of 会社
この場合、「株式会社〇〇」は「法人顧客」の個体であり、「法人顧客」は「顧客」の下位概念です。
したがって、「株式会社〇〇」は広い意味では顧客に属すると考えられます。
ただし、実務では注意も必要です。
「顧客」を人物や法人の種類として扱うのか、それともある契約や取引における役割として扱うのかで、モデルは変わります。
たとえば、より厳密に表すなら次のように考えることもできます。
株式会社〇〇 instance-of 法人
株式会社〇〇 plays-role 顧客 in 取引関係
つまり、「株式会社〇〇は法人であり、ある業務文脈において顧客という役割を担っている」と見るわけです。
最初は「法人顧客 is-a 顧客」として理解しても問題ありません。
ただ、オントロジーを実務に適用するときは、「それは実体なのか、役割なのか」を意識すると、モデルが壊れにくくなります。
具体的にはどう使うのか
ここまで、オントロジーは「概念と関係を整理するもの」だと説明してきました。
では、実務では何に使うのでしょうか。
大きく分けると、使い道は2つあります。
1つ目は、AIに社内データや文書を扱わせるためです。
2つ目は、データベースやデータ基盤上で、データの意味を管理するためです。
まずは、わかりやすいAIでの利用から考えてみます。
AIでオントロジーを使う
オントロジーの使い道として、まずわかりやすいのはAIです。
生成AIやLLMエージェントに社内文書、コード、DB定義、仕様書、問い合わせ履歴を読ませることは、かなり現実的になってきました。
ただし、AIが読めるようになったからといって、用語の意味が自動で揃うわけではありません。
たとえば、ECサイトにGA4を導入し、そのデータを使って分析基盤を作るケースを考えてみます。
このとき、一見すると「ユーザー」という概念は単純に見えます。
しかし、実際にはそうではありません。
ECサイト側には、会員、購入者、配送先、支払者、ログインアカウントといった概念があります。
一方、GA4側にも、ユーザー、アクティブユーザー、新規ユーザー、リピーター、User-ID、user_pseudo_id などがあります。
どれも「ユーザーっぽい」ものですが、同じものとは限りません。
たとえば、ECサイトでは次のように分ける必要があります。
BusinessParty = 人または法人などの取引主体
Account       = ログイン主体
Customer      = 顧客役割
Buyer         = 注文者
Payer         = 支払者
Recipient     = 受取人
Order         = 注文
OrderItem     = 注文明細
Product       = 商品
一方、GA4では次のような概念が登場します。
GA4User
GA4ActiveUser
GA4NewUser
GA4ReturningUser
GA4UserId
GA4UserPseudoId
GA4Session
GA4Event
GA4PurchaseEvent
GA4Item
ここで重要なのは、ECサイト上の Customer と、GA4上の User が同じとは限らないことです。
ECの Customer は、会員登録や購入履歴を持つ顧客かもしれません。
GA4の User は、ブラウザやアプリ上の識別子に基づいて集計された利用者かもしれません。
ログインしていない閲覧者も、GA4上ではユーザーとして扱われる可能性があります。
次のように定義しておくと、ひとまず安全でしょう。
GA4User close-match Visitor
GA4User identifiedBy GA4UserId or GA4UserPseudoId

GA4UserId represents FirstPartyUserIdentifier
GA4UserId mayMapTo AccountId
GA4UserId mayMapTo InternalUserId
GA4UserId mustNotContain PII

GA4UserPseudoId identifies PseudonymousVisitorIdentifier
GA4UserPseudoId close-match ClientIdOrAppInstanceId
GA4UserPseudoId mustNotBeUsedAs CustomerId

BusinessParty mayPlayRole Customer
Account is-a LoginIdentity
Account mayBelongTo BusinessParty

GA4PurchaseEvent is-a GA4Event
GA4PurchaseEvent close-match Order
GA4PurchaseEvent has TransactionId
GA4PurchaseEvent mayMapTo Order via ecommerce.transaction_id

GA4Item part-of GA4PurchaseEvent
GA4Item close-match ProductOrSku
GA4UserPseudoId を DeviceId と呼びたくなることがありますが、これはやや危険です。
WebではClient ID、アプリではApp Instance IDに近い識別子として扱われるため、物理デバイスそのものを識別していると考えるべきではありません。
また、GA4UserId も AccountId と常に同じとは限りません。
GA4のUser-IDには、サービス側が一意で安定したIDを送信します。
そのIDが会員IDなのか、アカウントIDなのか、社内ユーザーIDなのか、ハッシュ化された別IDなのかは実装次第です。
このように整理しておくと、AIに分析定義やSQL設計を任せるときの事故を減らせます。
たとえばAIに、「GA4のユーザー数とECの顧客数を比較するSQLを書いて」と依頼した場合、オントロジーがなければAIは user_id や customer_id をそれっぽく結合してしまうかもしれません。
AIに分析や設計を任せる場合、こうした関係を明示したMarkdownを先に読ませておくと、用語の誤解を減らせます。
AIにとってのオントロジーは、単なる用語集ではありません。
「このデータは何を意味するのか」「似ている概念は本当に同じなのか」「どのIDで結合してよいのか」を判断するための地図です。
なお、GA4 reports 上の Users や Active users と、BigQuery Export 上で COUNT(DISTINCT user_pseudo_id) した値も同一とは限りません。
前者はGA4の指標定義、reporting identity、しきい値、モデリングなどの影響を受けます。
後者はエクスポートされたイベントデータ上の識別子集計です。
同じ「ユーザー数」でも、どのレイヤーで数えているかによって意味が変わります。
ここを曖昧にしたままダッシュボードを作ると、会議で数字が合わず、最終的に「GA4が悪い」「SQLが悪い」「見たくないものを見ている人間が悪い」という、いつもの三択になります。
AIに与える
以下は、AIに読ませる docs/ontology/ga4_ec.md の例です。
GA4の一般的な概念や標準フィールドについては、公式ドキュメントをもとにAIで初稿を作ることもできます。
ただし、user_id に何を入れているか、Cookieや同意管理がどう実装されているか、transaction_id がEC側の注文IDと一致するか、といった実装固有の情報は必ず人間が確認する必要があります。
カスタム属性、会員IDの仕様、Cookie IDの取り扱い、サイト構成、URL遷移、注文完了フローなどは、ネットに落ちている情報ではありません。
こういう部分は、社内の仕様書や実装を見て、人間が書く必要があります。
Codex等に与えるAgentとして
リポジトリでCodexのようなエージェントを使う場合は、AGENTS.md にも同じ前提を書いておくとよいです。
# AGENTS.md

## Domain ontology

This project analyzes GA4 data for an ecommerce website.

Before modifying SQL, dbt models, dashboards, metric definitions, or documentation related to GA4, ecommerce, users, customers, orders, or purchases, read:

```text
docs/ontology/ga4_ec.md
```

## Important rules

Do not assume that the following concepts are identical:

```text
GA4User != Customer
GA4UserPseudoId != CustomerId
GA4UserId != AccountId unless explicitly documented
GA4PurchaseEvent != Order
GA4Item != Product
Account != Customer
Buyer != Recipient
Payer != Customer
GA4 reports Users != COUNT(DISTINCT user_pseudo_id)
```

Use the ontology relation types consistently:

```text
is-a          = subclass / inheritance
instance-of  = concrete instance
part-of      = part-whole relationship
has-part     = whole-to-part relationship
close-match  = similar but not identical
same-as      = identical; very strong relation
maps-to      = physical or implementation mapping
mayMapTo     = possible mapping; validate before using
identifies   = identifier points to an entity or identifier scope
plays-role   = contextual role
represents   = concept represented by a field or ID
```

## SQL generation rules

When generating SQL:

1. Check the ontology before joining GA4 and ecommerce tables.
2. Use `transaction_id` to map GA4 purchase events to business orders only when implementation quality is validated.
3. In raw GA4 BigQuery Export, use `ecommerce.transaction_id`, not `event_params.transaction_id`.
4. When using raw GA4 `items`, remember that `items` is repeated and usually requires `UNNEST(items)`.
5. Do not use `user_pseudo_id` as a customer identifier.
6. Do not assume `user_id` equals `customer_id` or `account_id`.
7. Distinguish GA4 user metrics from business-side customer metrics.
8. Distinguish GA4 report metrics from BigQuery Export aggregations.
9. If the requested metric says "user", clarify whether it means GA4 user, active user, logged-in account, customer, buyer, payer, or recipient.

## Review checklist

When reviewing code or SQL, check:

* Are GA4 users incorrectly treated as customers?
* Are purchase events incorrectly treated as orders?
* Are item IDs incorrectly treated as product master IDs?
* Is the reporting identity assumption documented?
* Is the join key between GA4 and EC data explicitly defined?
* Are duplicate or missing transaction IDs considered?
* Are raw GA4 nested/repeated fields handled correctly?
* Are PII and access-control assumptions documented?
DBでオントロジーを扱う
データベースでオントロジーを使う場合を考えてみます。
前節では、ECサイトにGA4を導入して分析するケースを例に、GA4User、Customer、Account、Order、GA4PurchaseEvent などの概念が同じではないことを見ました。
顧客、注文、商品、GA4イベントなどのデータ本体は、通常どおりRDBやDWH上のテーブルとして保持します。
オントロジーが担当するのは、その上にある意味のレイヤーです。
具体的には、次の3つを管理します。
Concept:
  業務概念
  例: Customer, Account, Order, GA4PurchaseEvent

Relation:
  概念同士の関係
  例: is-a, part-of, close-match, maps-to

Physical Mapping:
  業務概念と物理テーブル・カラムの対応
  例: ec.orders.order_id maps-to OrderId
たとえば、SnowflakeやBigQuery上に、オントロジー管理用のメタデータテーブルを持つことが考えられます。
ONTOLOGY.CONCEPT
  業務概念を管理する

ONTOLOGY.RELATION
  概念同士の関係を管理する

ONTOLOGY.PHYSICAL_MAPPING
  業務概念と物理テーブル・カラムの対応を管理する
中身のイメージは次のようになります。
CONCEPT:
- GA4UserPseudoId
- GA4UserId
- PseudonymousVisitorIdentifier
- Visitor
- BusinessParty
- Account
- Customer
- Order
- OrderItem
- GA4PurchaseEvent
- Product
- GA4Item

RELATION:
- GA4UserPseudoId identifies PseudonymousVisitorIdentifier
- GA4UserPseudoId close-match ClientIdOrAppInstanceId
- GA4UserId mayMapTo AccountId
- Account mayBelongTo BusinessParty
- BusinessParty mayPlayRole Customer
- Customer places Order
- Order has-part OrderItem
- GA4PurchaseEvent close-match Order
- GA4PurchaseEvent mayMapTo Order via ecommerce.transaction_id
- GA4Item close-match ProductOrSku

PHYSICAL_MAPPING:
- events_YYYYMMDD.user_pseudo_id -> GA4UserPseudoId
- events_YYYYMMDD.user_id -> GA4UserId
- events_YYYYMMDD.ecommerce.transaction_id -> TransactionId
- events_YYYYMMDD.items.item_id -> GA4ItemId
- ec.orders.order_id -> OrderId
- ec.orders.customer_id -> CustomerId
- ec.order_items.product_id -> ProductId
このようにしておくと、物理的なテーブル名やカラム名だけでなく、
「そのカラムが業務上何を意味しているのか」
「どの概念とどの概念が対応しているのか」
をDB上で管理できます。
たとえば、GA4の ecommerce.transaction_id と ECの ec.orders.order_id は対応する可能性があります。
しかし、それは常に完全一致を意味するわけではありません。
そのため、関係としては次のように表します。
GA4PurchaseEvent close-match Order
GA4PurchaseEvent mayMapTo Order via ecommerce.transaction_id
ここで same-as ではなく close-match や mayMapTo としている点が重要です。
GA4のpurchaseイベントとEC側の注文DBは、似た概念ではありますが、計測漏れ、重複送信、キャンセル、返品、分割出荷、再決済などにより完全一致しない可能性があります。
DB上にこのような意味レイヤーを持っておくと、分析やAIによるSQL生成の前提を明示できます。
SnowflakeやBigQueryではどう扱うか
Snowflakeであれば、実務的には次のような分担が考えられます。
メタデータテーブル:
  概念、関係、物理マッピングを管理する

Tags:
  テーブルやカラムに業務概念・機密区分・データドメインを付与する

Semantic View:
  BIやAIが利用する分析用の意味レイヤーを定義する
Tagsは、物理カラムに名札を貼るイメージです。
このカラムはGA4の疑似ユーザーIDである
このカラムは注文IDである
このカラムは顧客IDである
このカラムは個人情報を含む
一方、Semantic Viewのようなセマンティックレイヤーは、分析者やAIが使う入口になります。
物理テーブルには、次のような名前が並んでいるかもしれません。
ga4.events
ec.orders
ec.order_items
ec.customers
しかし、分析者やAIが扱いたいのは、次のような業務概念や指標です。
顧客
注文
商品
売上
購入数
平均注文単価
コンバージョン率
セマンティックレイヤーは、この物理データと業務概念の間をつなぎます。
オントロジーが「何が存在し、それらがどう関係するか」を定義するものだとすれば、セマンティックレイヤーは、それを分析やAIが使える形で公開するためのレイヤーです。
BigQueryの場合も考え方は同じです。
実データはBigQueryのテーブルやビューとして保持します。
メタデータ管理にはKnowledge CatalogやBusiness Glossary、機密区分やカラムレベルアクセス制御にはpolicy tagsやdata policies、BI向けの意味定義にはLookMLのようなセマンティックモデルを使う構成が考えられます。
ここで注意したいのは、BigQueryのpolicy tagsは、主に分類・カラムレベルアクセス制御・マスキングのための仕組みであり、GA4PurchaseEvent close-match Order のような概念関係を表すものではないという点です。
つまり、SnowflakeでもBigQueryでも、すべてを1つの仕組みに押し込む必要はありません。
この分担にすると、データ基盤上の責務が整理されます。
業務概念と関係:
  メタデータテーブル、Knowledge Catalog、Business Glossary で管理する

物理カラムへの注釈:
  Snowflake Tags やカタログのメタデータを使う

機密区分・アクセス制御・マスキング:
  Snowflake Tags + masking policies
  BigQuery policy tags + data policies

分析用の指標・ディメンション:
  Snowflake Semantic View や LookML で公開する

AIやBI:
  セマンティックレイヤーやオントロジーを参照して分析する
オントロジーは、業務概念と関係の定義です。
タグは、物理データへの注釈です。
セマンティックレイヤーは、分析者やAIに向けた公開モデルです。
なぜDB上で管理するのか
オントロジーをDB上で管理するメリットは、検索・JOIN・監査がしやすくなることです。
たとえば、次のような確認ができます。
CustomerId はどのテーブルに存在するのか
GA4UserPseudoId を CustomerId として使っている箇所はないか
Order と close-match している概念は何か
売上指標はどの物理カラムから計算されるのか
GA4 purchase event と EC order の join key は何か
transaction_id の検証ルールはどこに書かれているか
また、AIエージェントにSQL生成や分析定義を任せる場合にも、物理スキーマだけでなく、意味レイヤーを参照させることができます。
AIに生のテーブル構造だけを渡すと、似た名前のカラムを見て、それっぽいJOINや集計を作ることがあります。
それっぽいSQLは出ます。
問題は、それが正しいとは限らないことです。
user_id、customer_id、account_id、user_pseudo_id は、名前だけ見ると似ています。
しかし、それぞれが何を識別しているのかは違うかもしれません。
だからこそ、DB上で次の情報を管理しておく価値があります。
このIDは何を識別するのか
このカラムはどの業務概念に対応するのか
この概念同士は same-as なのか close-match なのか
この指標はどの粒度で計算されるのか
このカラムに個人情報や機密情報は含まれるのか
このjoin keyは検証済みなのか
データベースがデータの置き場だとすれば、オントロジーはデータに貼る意味の設計図です。
DBでオントロジーを使う目的は、巨大な知識グラフを作ることではありません。
まずは、業務概念、関係、物理マッピングを管理する。
そのうえで、TagsやSemantic View、LookMLのようなセマンティックレイヤーを使い、分析者やAIが扱いやすい形で公開する。
このくらいから始めるのが、実務では扱いやすいと思います。
セマンティックレイヤーだけでは足りない
セマンティックレイヤーは、BIや分析において非常に重要です。
「売上とは何か」「注文数をどう数えるか」「コンバージョン率をどう計算するか」といった指標定義を揃えることで、ダッシュボードやレポートの数字を安定させられます。
しかし、LLMエージェントに複数システムをまたいだ作業を任せる場合、それだけでは足りません。
たとえば、ある顧客に対して、GA4上の行動、EC上の注文、問い合わせ履歴、返金履歴をたどり、必要ならメールを送るような処理を考えます。
このとき必要になるのは、単なる指標定義ではありません。
GA4上のユーザーとEC上の顧客はどう対応するのか
注文と問い合わせはどう紐づくのか
返金はどの注文に対するものか
エージェントはどこまで参照・実行してよいのか
実行結果はどう監査されるのか
このようなエンティティ同士の関係、ID解決、操作権限、監査まで含めた文脈が必要になります。
セマンティックレイヤーが「指標の辞書」だとすれば、オントロジーは「エンティティと関係の地図」です。
AIエージェントが実務で動くには、辞書だけでなく地図が必要になります。
どうやって設定するのか
ここまで、オントロジーをDB上の意味レイヤーとして扱う話をしてきました。
では、実際にはどこに何を設定すればよいのでしょうか。
SnowflakeとBigQueryでは機能名は違いますが、考え方はほぼ同じです。
大きく分けると、次の4層に分けて管理すると扱いやすくなります。
1. 業務概念の定義
2. 物理テーブル・カラムとの対応
3. カラムへのタグ付け、分類、アクセス制御
4. BI / AI向けのセマンティックレイヤー
以下にサンプルを示します。
必ずしも最適解でないことはご容赦を。
Snowflakeの場合
Snowflakeであれば、次のように分担できます。
業務概念・関係:
  メタデータテーブル

物理カラムへの意味付け:
  Object Tags

機密区分・マスキング:
  Object Tags + masking policies

BI / AI向けの意味レイヤー:
  Semantic View
まず、業務概念と関係は、専用のメタデータテーブルとして持ちます。
CREATE SCHEMA IF NOT EXISTS ONTOLOGY;

CREATE TABLE IF NOT EXISTS ONTOLOGY.CONCEPT (
    CONCEPT_ID      STRING,
    LABEL_JA        STRING,
    LABEL_EN        STRING,
    CONCEPT_TYPE    STRING,  -- entity, event, role, metric, attribute, identifier
    DEFINITION      STRING,
    OWNER           STRING,
    STATUS          STRING,
    NOTE            STRING,
    CREATED_AT      TIMESTAMP_NTZ DEFAULT CURRENT_TIMESTAMP
);

CREATE TABLE IF NOT EXISTS ONTOLOGY.RELATION (
    SUBJECT_CONCEPT_ID STRING,
    PREDICATE          STRING,  -- is-a, part-of, close-match, maps-to, identifies, mayMapTo
    OBJECT_CONCEPT_ID  STRING,
    DEFINITION         STRING,
    NOTE               STRING,
    CREATED_AT         TIMESTAMP_NTZ DEFAULT CURRENT_TIMESTAMP
);

CREATE TABLE IF NOT EXISTS ONTOLOGY.PHYSICAL_MAPPING (
    CONCEPT_ID      STRING,
    DATABASE_NAME   STRING,
    SCHEMA_NAME     STRING,
    OBJECT_NAME     STRING,
    COLUMN_NAME     STRING,
    MAPPING_TYPE    STRING, -- represents, identifier-of, derived-from, close-match
    CONFIDENCE      NUMBER(3,2),
    NOTE            STRING,
    CREATED_AT      TIMESTAMP_NTZ DEFAULT CURRENT_TIMESTAMP
);
たとえば、次のようなレコードを入れます。
CONCEPT:
  GA4UserPseudoId
  GA4UserId
  CustomerId
  OrderId
  GA4PurchaseEvent
  Order

RELATION:
  GA4PurchaseEvent close-match Order
  GA4PurchaseEvent mayMapTo Order via ecommerce.transaction_id
  GA4UserPseudoId identifies PseudonymousVisitorIdentifier
  GA4UserPseudoId close-match ClientIdOrAppInstanceId

PHYSICAL_MAPPING:
  GA4.EVENTS.USER_PSEUDO_ID -> GA4UserPseudoId
  GA4.EVENTS.USER_ID -> GA4UserId
  GA4.EVENTS.TRANSACTION_ID -> TransactionId
  EC.ORDERS.ORDER_ID -> OrderId
  EC.CUSTOMERS.CUSTOMER_ID -> CustomerId
次に、物理カラムにはTagsを付けます。
CREATE TAG IF NOT EXISTS ONTOLOGY.BUSINESS_CONCEPT
  COMMENT = 'Business concept represented by this object or column';

CREATE TAG IF NOT EXISTS ONTOLOGY.DATA_SENSITIVITY
  ALLOWED_VALUES 'PUBLIC', 'INTERNAL', 'CONFIDENTIAL', 'PII'
  COMMENT = 'Data sensitivity classification';

ALTER TABLE GA4.EVENTS
  MODIFY COLUMN USER_PSEUDO_ID
  SET TAG ONTOLOGY.BUSINESS_CONCEPT = 'GA4UserPseudoId';

ALTER TABLE EC.ORDERS
  MODIFY COLUMN ORDER_ID
  SET TAG ONTOLOGY.BUSINESS_CONCEPT = 'OrderId';

ALTER TABLE EC.CUSTOMERS
  MODIFY COLUMN CUSTOMER_ID
  SET TAG ONTOLOGY.BUSINESS_CONCEPT = 'CustomerId',
          ONTOLOGY.DATA_SENSITIVITY = 'PII';
Tagsは、物理オブジェクトに貼る名札です。
「このカラムは何を表すのか」「機密区分は何か」をDB上で見えるようにします。
ただし、Tagsだけでは GA4PurchaseEvent close-match Order のような関係性までは扱いにくいため、関係は ONTOLOGY.RELATION のようなメタデータテーブルで管理します。
最後に、BIやAI向けにはSemantic Viewを作ります。
Semantic Viewでは、物理テーブルの上に、論理テーブル、ディメンション、ファクト、メトリクス、関係を定義します。
たとえば、次のような意味レイヤーを作ります。
Logical tables:
  Customer
  Order
  OrderItem
  GA4Event

Dimensions:
  order_date
  product_category
  traffic_source

Metrics:
  orders
  revenue
  average_order_value
  purchase_events
  ga4_order_match_rate

Relationships:
  Customer -> Order
  Order -> OrderItem
  GA4PurchaseEvent -> Order via transaction_id
実装はSQLで CREATE SEMANTIC VIEW を書くか、SnowsightのウィザードやYAML定義を使うのが現実的です。
BigQueryの場合
BigQueryの場合も、基本的な考え方は同じです。
業務概念・関係:
  BigQuery上のメタデータテーブル

メタデータ管理・用語集:
  Knowledge Catalog / Business Glossary

機密区分・カラムレベルアクセス制御・マスキング:
  policy tags / data policies

BI向けの意味レイヤー:
  LookML / Looker semantic model
まず、BigQuery上にもオントロジー管理用のデータセットを作ります。
CREATE SCHEMA IF NOT EXISTS `project_id.ontology`;

CREATE TABLE IF NOT EXISTS `project_id.ontology.concept` (
  concept_id STRING,
  label_ja STRING,
  label_en STRING,
  concept_type STRING,
  definition STRING,
  owner STRING,
  status STRING,
  note STRING,
  created_at TIMESTAMP
);

CREATE TABLE IF NOT EXISTS `project_id.ontology.relation` (
  subject_concept_id STRING,
  predicate STRING,
  object_concept_id STRING,
  definition STRING,
  note STRING,
  created_at TIMESTAMP
);

CREATE TABLE IF NOT EXISTS `project_id.ontology.physical_mapping` (
  concept_id STRING,
  project_id STRING,
  dataset_name STRING,
  table_name STRING,
  column_name STRING,
  mapping_type STRING,
  confidence NUMERIC,
  note STRING,
  created_at TIMESTAMP
);
ここに、Snowflakeの場合と同じように、概念、関係、物理マッピングを入れます。
events_YYYYMMDD.user_pseudo_id -> GA4UserPseudoId
events_YYYYMMDD.user_id -> GA4UserId
events_YYYYMMDD.ecommerce.transaction_id -> TransactionId
events_YYYYMMDD.items.item_id -> GA4ItemId

ec.orders.order_id -> OrderId
ec.orders.customer_id -> CustomerId

GA4PurchaseEvent close-match Order
GA4PurchaseEvent mayMapTo Order via ecommerce.transaction_id
GA4UserPseudoId identifies PseudonymousVisitorIdentifier
GA4UserPseudoId close-match ClientIdOrAppInstanceId
GA4 BigQuery Export のraw tableでは、transaction_id は ecommerce.transaction_id にあります。
また、items はrepeated RECORDなので、商品単位で扱う場合は通常 UNNEST(items) が必要です。
もし社内で ga4.events のような整形済みビューを作るなら、そのビューがraw exportのどのフィールドから作られているかも physical_mapping に書いておきます。
ga4.events.transaction_id -> TransactionId
  derived-from events_YYYYMMDD.ecommerce.transaction_id

ga4.event_items.item_id -> GA4ItemId
  derived-from UNNEST(events_YYYYMMDD.items).item_id
次に、BigQueryではpolicy tagsを使って、機密区分やカラムレベルアクセス制御を設定します。
たとえば、CustomerId やメールアドレスのようなカラムには、PIIやConfidentialなどのpolicy tagを付与します。
BigQueryでは、policy tagをカラムスキーマに設定します。
イメージとしては次のような形です。
{
  "name": "customer_id",
  "type": "STRING",
  "mode": "NULLABLE",
  "policyTags": {
    "names": [
      "projects/project-id/locations/asia-northeast1/taxonomies/123/policyTags/456"
    ]
  }
}
policy tagsはアクセス制御やマスキングには向いていますが、GA4PurchaseEvent close-match Order のような概念関係を表すものではありません。
関係性は、BigQuery上の ontology.relation のようなメタデータテーブルで管理する方が扱いやすいです。
さらに、メタデータや業務用語の管理にはKnowledge CatalogのBusiness Glossaryを使えます。
たとえば、Business Glossaryに次のような用語を登録します。
Customer
Account
Order
GA4User
GA4PurchaseEvent
Revenue
ConversionRate
ここには、各用語の定義、注意点、オーナー、関連するデータ資産を登録しておきます。
これにより、データ利用者が「この用語は何を意味するのか」を探しやすくなります。
BI向けには、LookMLでセマンティックモデルを定義します。
たとえば、LookMLではディメンション、メジャー、JOIN関係を定義できます。
view: orders {
  sql_table_name: `project_id.ec.orders` ;;

  dimension: order_id {
    primary_key: yes
    type: string
    sql: ${TABLE}.order_id ;;
  }

  dimension: customer_id {
    type: string
    sql: ${TABLE}.customer_id ;;
  }

  measure: orders {
    type: count_distinct
    sql: ${order_id} ;;
  }

  measure: revenue {
    type: sum
    sql: ${TABLE}.order_amount ;;
  }
}

explore: orders {
  join: customers {
    type: left_outer
    sql_on: ${orders.customer_id} = ${customers.customer_id} ;;
    relationship: many_to_one
  }
}
このように、LookML側では分析者が使うディメンションやメジャーを定義します。
オントロジーが「意味のマスター」だとすれば、LookMLは「分析で使う公開モデル」です。
あとがき: バベルの塔を再び建てよう
オントロジーという言葉は、少し大げさに聞こえるかもしれません。
しかし、突き詰めるとこれはかなり古典的な問題でもあります。
哲学では古くから、「存在するものをどう分類するか」「名前は実在を指しているのか」「分類は世界側にあるのか、人間が便宜的に作ったものなのか」といった問いが扱われてきました。
中世哲学には、普遍論争という有名な議論があります。
ざっくり言えば、「犬」や「人間」のような普遍的な概念は本当に存在するのか、それとも個々の犬や個々の人間に付けられた名前にすぎないのか、という議論です。
これは一見、業務データとは無関係に見えます。
しかし、実務でも似たようなことは起きます。
「顧客」は本当にひとつの概念なのか。
「ユーザー」はログインアカウントなのか、購入者なのか、閲覧者なのか。
「注文」はGA4のpurchaseイベントと同じなのか。
「売上」は税込なのか、税抜なのか、キャンセル後なのか、出荷後なのか。
つまり、私たちも日々、かなり地味な普遍論争をしています。
会議室で。SQLで。Excelで。たまにSlackのスレッドで。
また、ウィトゲンシュタインは、言葉の意味はその使われ方にある、という考え方を示しました。
この見方は、社内用語を考えるうえでもかなり示唆的です。
同じ「ユーザー」という言葉でも、SNS、EC、社内システム、GA4では使われ方が違います。
使われ方が違えば、意味も違います。
人間は、その違いを文脈や空気で補正できます。
しかし、AIやデータ基盤は、その補正を勝手にはできません。
できているように見えるときは、だいたい推測しています。
この言葉は何を指しているのか。
何と同じで、何とは違うのか。
どの文脈で意味が変わるのか。
それを問い、整理し、共有可能な形にすること。
それが、オントロジーの実務的な価値です。
そしてこれは、今のところ人間が得意で、同時に苦手としている領域でもあります。
AIがもっともらしいSQLや仕様書を一瞬で出す時代になるほど、「そもそも何を同じものとして扱うのか」という問いは重くなります。
バベルの塔を再び建てるなら、まず必要なのは高い塔ではなく、同じ言葉で同じものを指すための地図です。