Adobe Analytics経験者のためのCustomer Journey Analytics入門
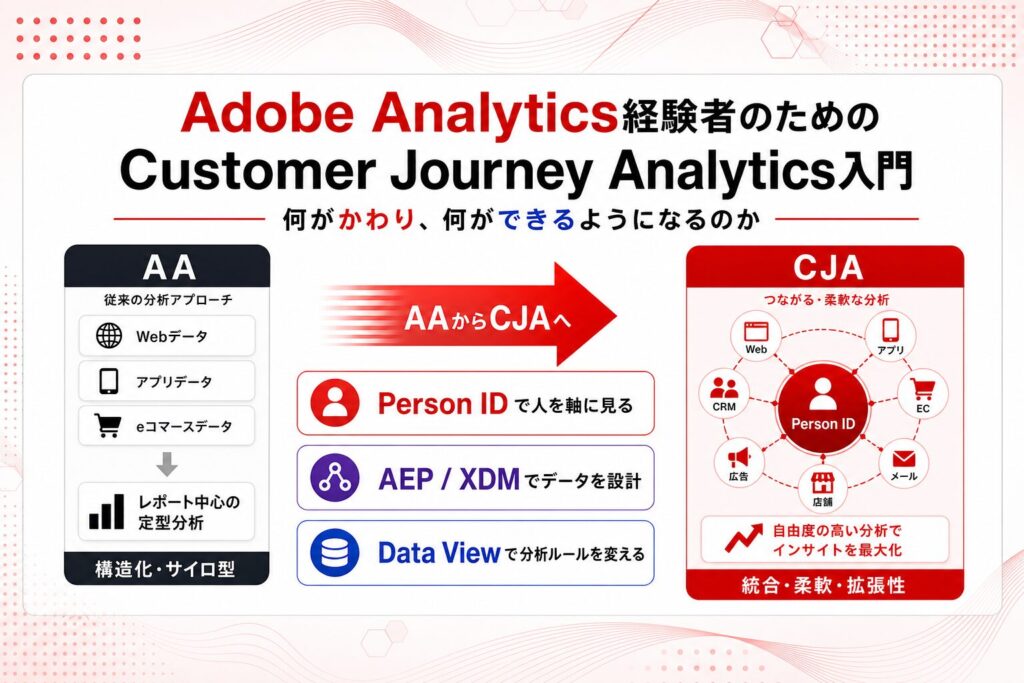
突然ですが Adobe Analyticsを使っていますか?
今回はタイトルにもあるように、Adobe Analytics経験者に向けて
Customer Journey Analytics と Adobe Analytics と比較しながら「Customer Journey Analytics とは何なのか・何が嬉しいのか」というような話をしていきます。
「Adobe Analytics 経験者」とは書いていますが、Adobe Analytics に触れたことがない方でも、「へ〜、Customer Journey Analyticsってそういう感じなのね」という雰囲気は感じてもらえるような内容にはなっているかと思います。
では、早速いってみましょう!
Adobe Analytics(以下、AA) を長く使っている人ほど
Customer Journey Analytics(以下、CJA)に触れた時に、最初の違和感が大きいかもしれません。
画面だけ見ると、CJAにも Analytics Workspaceがあり、フリーフォームテーブルがあり、セグメントや計算指標に近い考え方もあります。一見すると、「AAの新しい版」「レポートスイートが少し柔軟になったもの」に見えます。
ただ、実装や設計の観点では、CJAはAAの延長ではありません。
AAで中心にあったのは
レポートスイート、eVar、prop、event、処理ルール、分類、などでした。
CJAで中心になるのは
Adobe Experience Platform(以下、AEP)、XDMスキーマ、データセット、接続(Connection)、データビュー(Data View)です。
そして、その複数データセットを人物単位でつなぐ軸になるのが、接続で指定するPerson IDです。
つまり、CJAを理解する上で最初に切り替えるべきなのは
画面操作ではなくデータアーキテクチャの見方だと思います。
本記事では、AA経験者が CJA を理解しやすいように
AAとの違い、XDMスキーマ、データセット、接続、データビュー、Web SDK実装の順に整理します。
レポート画面の細かい操作説明などは最小限にして(正直レポート画面の操作感はAAとあまり変わらない)
実装・設計でつまずきやすい点を厚めに扱えればと思います。
目次[非表示]
- 1.CJAは「AAの新しいレポートスイート」ではない
- 2.AAと比較して、CJAの何が嬉しいのか
- 2.1.Person IDを軸とした分析基盤
- 2.2.後から試せる
- 2.3.分析対象のデータの幅
- 2.4.Eコマース情報の扱い
- 2.5.IDステッチ
- 2.6.接続とデータビュー
- 3.全体像:CJAではデータがどう流れるのか
- 4.1. [AEP]スキーマとデータセット:XDMスキーマはデータの設計図
- 5.2. [CJA]データセット:CJAで使う4種類のデータセット
- 5.1.イベントデータセット
- 5.2.プロファイルデータセット
- 5.3.ルックアップデータセット
- 5.4.概要データセット
- 5.5.AEPのデータセットとCJAのデータセット
- 5.5.1.AEPのデータセット定義とCJAのデータセット定義は異なる
- 5.5.2.AEPのデータ分類
- 5.5.3.クラスとは?
- 5.5.4.AEPデータセットとCJAデータセットの関係
- 5.5.5.ここまでの要点
- 5.5.6.AEPデータ分類とCJAデータセットタイプの関係まとめ
- 6.3. [CJA]接続:接続(connection)はデータセットを束ねる場所
- 7.4. [CJA]データビュー:データビューは CJA の分析ルールブック
- 7.1.コンポーネントは作るもの
- 7.2.永続性とアトリビューションは分けて考える
- 7.3.永続性の種類とデフォルト
- 7.4.派生フィールドで過去データの解釈を変える
- 7.5.重複排除は明示する
- 8.5. Web SDK:Web SDK実装は「送る前の設計」が9割
- 8.1.CJA向けのデータは最終的にXDMへ入れる
- 8.2.datastreamはサーバー側の分岐点
- 8.3.SPAでは参照元と仮想ページビューの扱いを決める
- 8.3.1.SPAでリファラーをどう扱うか – 設計の選択肢
- 8.3.2.例:選択肢3(永続性で持たせる)の実装
- 8.3.3.まとめ:コードとデータビューの分業
- 8.4.自動リンクトラッキングのlinkName問題
- 8.4.1.linkName自動取得の優先度
- 8.5.client hints は必要なものを明示する
- 9.XDM実装で困りやすいポイント
- 9.1._id は何者なのか
- 9.2.timestamp は形式とタイムゾーンに注意する
- 9.3.バッチ処理の「成功」を過信しない
- 9.4.null、空文字、空配列の扱い
- 9.5.スキーマパスとフィールドグループの落とし穴
- 10.Adobe Data Collection では非同期処理を待つ実装もできる
- 11.QAは「ビーコンがとんだ」で終わらせない
- 12.移行は「タグの置き換え」ではなく「分析基盤の再設計」
- 13.まとめ
CJAは「AAの新しいレポートスイート」ではない
AAでは、データはレポートスイートに送られます。
AppMeasurement.js や Web SDK などから送信されたデータは
AA側の処理ルール、マーケティングチャネル、分類、eVarの有効期限や配分といった設定に基づいて処理され
その結果がレポートで使われます。
この考え方では、実装時・収集時に決めたことが非常に強い意味を持ちます。
例えば、あるマーケティングチャネルルールが間違っていた場合、修正した日以降は正しくなっても
過去データに同じ修正を簡単に遡及適用することは難しいです。
また、AAでは、eVarの有効期限や配分、訪問定義などは収集時・前処理時の設定として強い意味を持ちます。
AAにもAttribution IQのように、後から見方を変えられる機能はありますが、CJAのデータビューほど広い範囲の分析ルールを柔軟に定義できるわけではありません。
CJAでは、まずAEP上にXDMスキーマ形式のデータを保存します。
その上で、CJAの接続が複数のデータセットを束ね、データビューでそのデータをどう解釈するかを定義します。
この違いを一言で言うなら、
AAは「収集時に解釈する」比重が大きく、
CJAは「レポート(データビュー)時に解釈する」比重も大きい、ということです。
※「設定方法」として「レポート(データビュー)時に解釈を決められる比重も大きい」という話であり
もちろん、実装前から設計として決めておくべきポイントも沢山あります。
AA経験者向けに差分をざっくり整理すると、次のようになります。
観点 | Adobe Analytics (AA) | Customer Journey Analytics (CJA) |
|---|---|---|
データの置き場所 | レポートスイート | AEPのデータセット |
分析の軸 | レポートスイート内のヒット、訪問、訪問者を中心に見る | Person IDを軸に、複数データセットの行動や属性を人物単位でつなぐ |
設計の中心 | eVar、prop、event、処理ルール、分類 | XDMスキーマ、接続、データビュー |
データの解釈 | 収集時に解釈が固定されやすい | レポート時に解釈を変えやすい |
値の種類が多いデータ | URL、検索語、SKUなどは、値の種類が増えすぎると詳細がまとめられることがある | URL、検索語、SKUなどをより元の粒度で扱いやすい |
複数データ統合 | AAの枠内での連携が中心 | Web、CRM、店舗、広告費などを同じ分析文脈に置きやすい |
注意点 | AA側の標準機能に守られる部分が多い | ID、重複排除、保持期間、データ型を自分たちで設計する責任が大きい |
速報性 | リアルタイム確認や短い間隔の監視に向く場面がある | AEP取り込みやステッチを挟むため、速報監視用途では期待値調整が必要 |
CJAのメリットは、Person IDを軸に複数のデータセットをつなぎ、AAよりも柔軟にデータを組み合わせ、過去データに対して新しい見方を試せることです。(※ Person IDという概念が非常に重要です)
eVarやpropの枠、値の種類が多いデータの扱いづらさ、レポートスイート中心の設計から離れ、Web以外の顧客接点も同じ分析の中に置きやすくなります。
一方で、デメリットもあります。
AAで自動的、または管理画面の標準機能として扱えていたものを、CJAではスキーマ、データセット、接続、データビュー、Datastream、Data Prep など、どこで実現するかを決める必要があります。
さらに、CJAは速報監視ツールというより統合分析の基盤です。反映までのレイテンシーがあるため、「いま飛んだビーコンをすぐレポートで見る」「1時間以内に異常検知する」といった運用は、別の監視設計と分けて考えた方が安全かもしれません。
また、CJAでも取り込み時のスキーマやデータ型は重要です。何でも後から直せるわけではありません。
ただ、データビューで派生フィールド、アトリビューション、永続性、セッション定義、重複排除などを設定できるため、元データを壊さずに複数の見方を試せます。
極端な例ですが、同じデータに対して
あるデータビューでは30分セッション、別のデータビューでは24時間セッションにする。
あるビューでは成果イベントと同じイベント内の値だけを見る、別のビューでは直近で観測された値を引き継ぐ。
URLから派生フィールドでカテゴリを切り出し、過去期間にも同じ分類を適用する。
など、AAで「実装した後に気づいたら厳しい」ことの一部を、CJAでは分析側の設計として扱えます。
一方で、AAで暗黙に用意されていたものを、自分たちで再設計する場面も増えます。
Bot除外、分類、購入の重複排除、マーケティングチャネル、訪問の考え方、イベントのシリアライズなどは、AAでは標準機能、専用の管理画面、実装変数として用意されていました。もちろんAAでも設定や実装は必要でしたが、CJAでは同じ名前の機能が用意されているとは限りません。
CJAでは、AEP、Datastream、Data Prep、ルックアップ、派生フィールド、フィルター、データビュー設定などを組み合わせて、自分たちの分析ルールとして作り直す必要があります。
AAと比較して、CJAの何が嬉しいのか
ここまでの話を、AA経験者の実務感覚に寄せて言い換えると、CJAの嬉しさは次の9つに整理できそうです。(あくまで筆者の個人的感覚です)
Person IDを軸に、Web、CRM、店舗などのデータを人物単位でつなぎやすい
過去データにも、後から新しい分類や見方を試しやすい
同じデータを、複数のセッション定義・アトリビューション・永続性で比較できる
Web、CRM、店舗、コールセンターなど、複数の接点を同じ分析文脈に置きやすい
広告費と売上、顧客属性と行動、オンラインとオフラインを同じWorkspaceで見やすい
eVar/prop/event番号の枠や、値の種類が多いデータの扱いづらさから離れやすい
products文字列のような実装から、商品情報を構造化データとして扱いやすい
IDステッチによって、匿名行動とログイン後行動をつなげて分析しやすい
接続とデータビューを使って、用途別の分析環境を作りやすい
Person IDを軸とした分析基盤
まず大きいのは、CJAがPerson IDを軸にした分析基盤であることです。
AAでは、レポートスイートの中に入ったWebのヒット、訪問、訪問者を中心に分析する感覚が強かったと思います。もちろんAAにも訪問者識別やECIDはありますが、CRM、店舗購買、コールセンター、広告費のようなデータを同じ人物軸で自然につなぐには、別の仕組みや工夫が必要でした。
CJAでは、接続に追加するデータセットごとにPerson IDを指定し、そのIDを軸にイベントデータやプロファイルデータを分析します。ここで重要なのは、指定したPerson IDが同じ人物を表すID体系になっているかです。
例えば、WebイベントではECIDをPerson IDにし、店舗購買データでは会員IDをPerson IDにした場合、CJAはその2つを同じ人物として扱ってはくれません。
WebとCRM、店舗、コールセンターを一気通貫で見たいなら、ログイン時に会員IDを送る、ステッチを使う、上流で共通IDに解決するなど、Person IDを同じ意味に揃える設計が必要です。
つまりCJAでは、「どのeVarに会員IDを入れるか」ではなく、「どのIDで人物をつなぎ、どのデータセットを同じジャーニーとして扱うか」が設計の中心になります。ここがAAとのかなり大きな違いです。
後から試せる
後から試せる範囲が広がります。
AAでは、処理ルール、マーケティングチャネル、eVarの有効期限や配分など、収集時や管理画面設定で決めたことが後の数字に強く影響します。
設定を間違えても、修正日以降は直せますが、過去データまで同じルールで簡単に再解釈できるわけではありません。
CJAでは、元データをAEPに保持したうえで、データビュー側で派生フィールド、アトリビューション、永続性、セッション定義などを設定できます。
前述の例を再度記載すると
URLからサイトカテゴリを切り出すルールを後から作る。
キャンペーンコードを、購入イベント自体に入っている値だけで見るのか、データビューの永続性設定でセッション内の直近値や最初の値として引き継がせるのかを比較する。
30分セッションと24時間セッションを別々のデータビューで比べる。
こうしたことを、元データを壊さずに検証しやすくなります。
分析対象のデータの幅
分析対象にできるデータの幅も広がります。
AAはWeb計測を中心に強いツールでした。
一方で、CJAはAEP上のデータセットを接続で束ねるため、Webイベント、アプリイベント、CRMの顧客属性、店舗購買、コールセンター接触、商品マスタ、広告費などを、同じ分析文脈に置きやすくなります。
広告費のように、1人ひとりのPerson IDを持たないデータも、概要データセット(※データセットの種類については後述)として扱えます。売上はイベントデータ、広告費は概要データ、キャンペーン名はルックアップ、顧客ランクはプロファイルデータ、というように性質の違うデータを組み合わせ、Workspace上でROASやCPAを見る、といった分析がしやすくなります。
AAの変数設計に慣れている人にとっては、eVar、prop、eventの番号管理から離れられることも大きいです。(慣れすぎて逆にAAの方がやりやすい人もいるかもしれませんが笑)
AAでは「この値はeVar何番に入れるか」「event番号が足りるか」「この検索語やURLは値の種類が多すぎないか」といったことを意識して設計していました。
値の種類が多すぎるデータでは、AAでは「Low-Traffic」扱いになり詳細がまとまってしまい、ロングテールの中身を追いづらい場面もあります。
CJAでは、XDMスキーマ上の意味あるフィールドをデータビューでコンポーネント化します。
値の種類が多いURL、検索語、SKUなども、AAより元の粒度で扱いやすくなります。
ただし、何でも細かく送ればよいわけではありません。クエリ性能、データ保持、ルックアップ設計、派生フィールドの複雑さは別途考える必要があります。
Eコマース情報の扱い
Web SDK の実装者にとっては、商品情報の扱いも分かりやすくなります。
AAでは、複数商品の情報を s.products に1本の文字列に詰め込む必要がありました。
商品ID、数量、価格、商品イベント、マーチャンダイジングeVarなどを、セミコロンやカンマ区切りで組み立てる実装は、慣れていないと読みにくく、壊れやすいところでした。
CJA/Web SDKでは、商品情報をXDMの構造化データとして表現できます。
標準の productListItems や、自社スキーマのオブジェクト配列として、SKU、商品名、カテゴリ、数量、価格などを意味のあるフィールドに分けて送れます。
実装側でもデータの意味が読み取りやすく、CJA側でも商品ID、カテゴリ、価格、数量などをそれぞれのコンポーネントとして扱いやすくなります。
IDステッチ
IDステッチも、CJAの大きな特徴です。
IDステッチとは、同じ人を表している複数のIDを、分析上の1人に寄せるための仕組みです。
例えば、ログイン前の閲覧イベントでは ECID = 1111 しか分からないとします。
その後、ログインイベントで ECID = 1111 と 会員ID = A9999 が同じイベントに入ると、CJAは「ECID 1111 と会員ID A9999 は同じ人物を表している」と判断できます。
ステッチを使うと、対象期間内の過去の ECID = 1111 の行動も、分析上は 会員ID = A9999 の人物の行動として見られるようになります。(※対象期間とはレポートの表示期間ではなく別途ステッチの設定で定められている期間です)
未ログイン時のECIDやFPIDなどの永続IDと、ログイン後の会員IDをつなげることで、匿名状態の行動とログイン後の行動を同じ人物のジャーニーとして見やすくなります。
つまりステッチをうまく活用すれば、オンラインでユーザーがログイン前の行動であっても、会員IDを紐づけて会員IDベースで分析ができます。
さらに、オフラインデータに会員IDが存在すれば、オフライン行動も含めて分析することも容易なわけです。(こちらはステッチ機能の便利さというよりは、CJA自体のメリット)
もちろん、元データにIDの関係が出ていなければステッチできないため、実装時にどのイベントでどのIDを送るかは重要です。それでも、AAのレポートスイート中心の発想よりも、顧客単位の分析に寄せやすいのはCJAの強みです。
余談ですが、ステッチには「フィールドベースのステッチ」と「グラフベースのステッチ」の2種類あり、「グラフベースのステッチ」を利用できればステッチの幅がさらに広がります。
本記事では詳細には言及せず、言葉のみの紹介となりますが、興味のある方は調べてみてください。(Extureへのお問い合わせも大歓迎です。)
接続とデータビュー
最後に、接続とデータビューの考え方です。
AAでは、レポートスイートがデータの置き場所であり、分析の単位でもありました。
CJAでは、接続がデータセットを束ね、データビューが分析ルールを定義します。1つの接続から、ブランド別、国別、部署別、検証用など複数のデータビューを作れます。
同じ元データに対して、マーケティングチーム向けにはキャンペーン分析を重視したビュー、プロダクトチーム向けには機能利用や導線分析を重視したビュー、検証用にはセッション定義やアトリビューションを変えたビューを用意する。
こうした運用がしやすいことも、AAからCJAへ発想を切り替える大きな理由になります。
全体像:CJAではデータがどう流れるのか
まずは図で描くとざっくり以下のような形です。

ここで1点重要な補足です。
本来はAEP上でのデータセットは「イベントデータセット」「プロファイルデータセット」「ルックアップデータセット」「概要データセット」などで分かれているわけではありません。
接続してはじめて、CJA上で「イベントデータセット」「プロファイルデータセット」「ルックアップデータセット」「概要データセット」とデータセットの分類が認識されます。
なので、より正確には、例えば上図の「イベントデータセット」は、「接続したときにCJAでイベントデータセットと分類される、AEPのデータセット」という表現になりますが、今回流れが分かりやすくなるように上のように描いています。(他のプロファイルデータセット、ルックアップデータセット、概要データセットについても同様です)
大きく見ると、CJAのデータは次の順番で流れます。
Web SDKやMobile SDK、バッチ、コネクタなどからデータを送る
AEP上で、XDMスキーマに沿ったデータセットとして蓄積する
CJAの接続(Connection)で、分析対象にするデータセットを束ねる
CJAのデータビュー(Data View)で、指標、ディメンション、永続性、セッション定義などの分析ルールを作る
CJAのレポート画面で、データビューに含めたコンポーネントを使って分析する
AAでは、実装したデータをレポートスイートに送り、そのレポートスイートを中心に分析する感覚が強かったと思います。CJAでは、まずAEPにデータを蓄積し、その上に接続とデータビューを重ねて分析環境を作ります。
ここで混同しやすいのが、AEPのスキーマ、AEPのデータセット、CJAのデータビューの役割です。
AEP – スキーマは、どんな構造・型・意味のデータを持つかを決める設計図です。
AEP – データセットは、そのスキーマに沿った実データを入れる箱です。
CJA – データビューは、接続されたデータセットをWorkspaceでどう見せるか、どう計算するかを決める分析ルールです。
※CJAにもデータセットという言葉が登場しますが、これはAEPのデータセットを接続によってCJAに取り込んだ際に認識されるデータ分類です。データを入れる箱自体はあくまでAEPデータセットであり、CJAに別の箱(データセット)があるわけではないです。まだ良くわからないと思いますが、詳細は後述します。
Web SDK実装は、この流れの入口にあります。
ブラウザからただビーコンを飛ばすだけではなく、AEPに入ったときにXDMスキーマ上のどのフィールドへ入るのか、CJAの接続でどのPerson IDを使うのか、データビューでどの指標・ディメンションとして見せるのかまで考えて送る必要があります。
以下では、1:[AEP]スキーマとデータセット、2:[CJA]データセット、3:[CJA]接続、4:[CJA]データビュー、5:Web SDK について順番に見ていきましょう。(前述のように AEPのデータセットと CJAのデータセットは分けて考えた方が理解しやすいです。)
1. [AEP]スキーマとデータセット:XDMスキーマはデータの設計図
CJAで使うデータは、AEP上ではXDMスキーマに沿って保存されます。
XDMスキーマは、データの設計図です。
どんなフィールドを持つのか、そのフィールドが文字列なのか数値なのか日時なのか、配列なのかオブジェクトなのか、どのフィールドをIDとして扱うのか、といったことを定義します。
例えば、ページ名、ページ種別、商品ID、会員ランク、購入金額、イベント時刻は、それぞれどのパスに置くのか。
商品が複数ある場合は配列で持つのか。
会員IDは分析用のディメンションとしても使うのか、Person IDとしても使うのか。
こうした設計がスキーマの役割です。
AEPのデータセットは、このスキーマに沿って実際のレコードを保存する場所です。
同じイベントデータでも、Webイベント、アプリイベント、店舗購買イベントを別々のデータセットとして持つことができます。
ただし、詳しくは後述しますが、同じ意味のフィールドを別々のスキーマパスにしてしまうと、CJA側では別コンポーネントとして扱われやすくなります。逆に、同じ意味のフィールドを同じスキーマパスに揃えておくと、後の接続やデータビュー設計がかなり楽になります。
ここで大事なのは、CJAのデータビューで後から柔軟に解釈を変えられる一方で、元データとして存在しないフィールドや、型を間違えて取り込んだフィールドは、後からどうにもならないこともあります。
そのため、CJAでは「レポート画面でどう見せるか」だけでなく、「AEPにどういう構造でデータを置くか」が重要になります。
eVar/prop 設計から XDM 設計へ
AA経験者にとって一番大きな発想転換は、eVarやpropという「箱」がなくなることです。
AAでは、要件を聞くと自然にこう考えがちです。
会員ランクはどのeVarに入れるか
ページ種別はpropにするかeVarにするか
購入イベントはどのevent番号を使うか
商品情報はproducts文字列をどう組み立てるか
分類で後からどう展開するか
CJAでは、この発想をそのまま持ち込むと苦しくなります。
XDMは、番号付きの変数スロットではなく、業務概念を表す階層型のデータモデルです。
例えば、AA的な発想ではこうなりがちです。
1 2 3 4 5 | // AA的な発想s.eVar12 = "gold"; // 会員ランクs.eVar34 = "product"; // ページ種別s.prop8 = "footer_link"; // リンク種別s.events = "event42"; // 商品詳細閲覧 |
CJAを長期的に使うなら、これを単純に eVar12 や event42 のような名前でXDMに移すより、業務上の意味が分かる構造にした方が扱いやすくなります。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 | { "web": { "webPageDetails": { "name": "Product Detail", "pageType": "product" }, "webInteraction": { "type": "link click", "name": "Footer Campaign Link" } }, "commerce": { "productViews": { "value": 1 } }, "_tenant": { "member": { "id": "member-12345", "rank": "gold" } }} |
このようにしておくと、CJAだけでなく、AEP上の他サービスや将来のデータ活用でも意味が通りやすくなります。
移行期には、AA互換に近いフィールドグループや、data.__adobe.analytics.eVar1 のようなデータオブジェクトを使う方法もあります。既存実装を短期間で移行するには選択肢としては可能ですが、オススメはしません。
(data.__adobe.analytics〜 という書き方は dataオブジェクトと呼ばれますが、本記事では深く言及しません。 Web SDKで AAの実装をする際にはとても有効ですが、CJAではdataオブジェクトはそのままでは使えないため、後述の Data Prepなどで、結局 XDM にマッピングする必要があります。)
CJAに移る意味は、単に送信先を変えることではありません。
データを業務概念に沿って再設計できることにあります。
ここまで文字ばかりでやや分かりづらいかもしれませんので
ここで実際のスキーマの設定画面を貼っておきます。

eVar /prop といった名前ではなく
「web行動の情報はここに入れる」、「eコマース情報はこの構造にする」などを、JSONライクな形で定義してスキーマを作成していきます。
Data Prep は XDM に合わせるための整形・マッピング層
Data Prepは、AEPにデータを取り込むときに、入力データをXDMスキーマへマッピング、変換するための仕組みです。
例えば、CSV取り込みでは、取り込みフローの中で「マッピング」することができますし
Web SDKでデータを Edge Network に送った際にも、Datastream(後述) の Data Prep で XDMスキーマへ変換することもできます。
例えば、CSVの 2026/05/01 10:30:00 を、タイムゾーンを含むISO8601形式に整えてXDMの timestamp に入れる。
既存データレイヤーの memberRank を _tenant.member.rank に割り当てる。
入力元で xdm._id を作れない場合に、Data Prepの uuid() 関数で擬似ランダムIDを生成してマッピングする。
こうした「送られてきた値を、XDMスキーマ上のどのパスへ、どの形式で入れるか」を決めてマッピング・変換する場所がData Prepです。
また、上記の xdm._id の例のように、「値として送られて来なくても、Data Prepの uuid() 関数で値を生成」してXDMスキーマのフィールドに割り当てることも可能です。
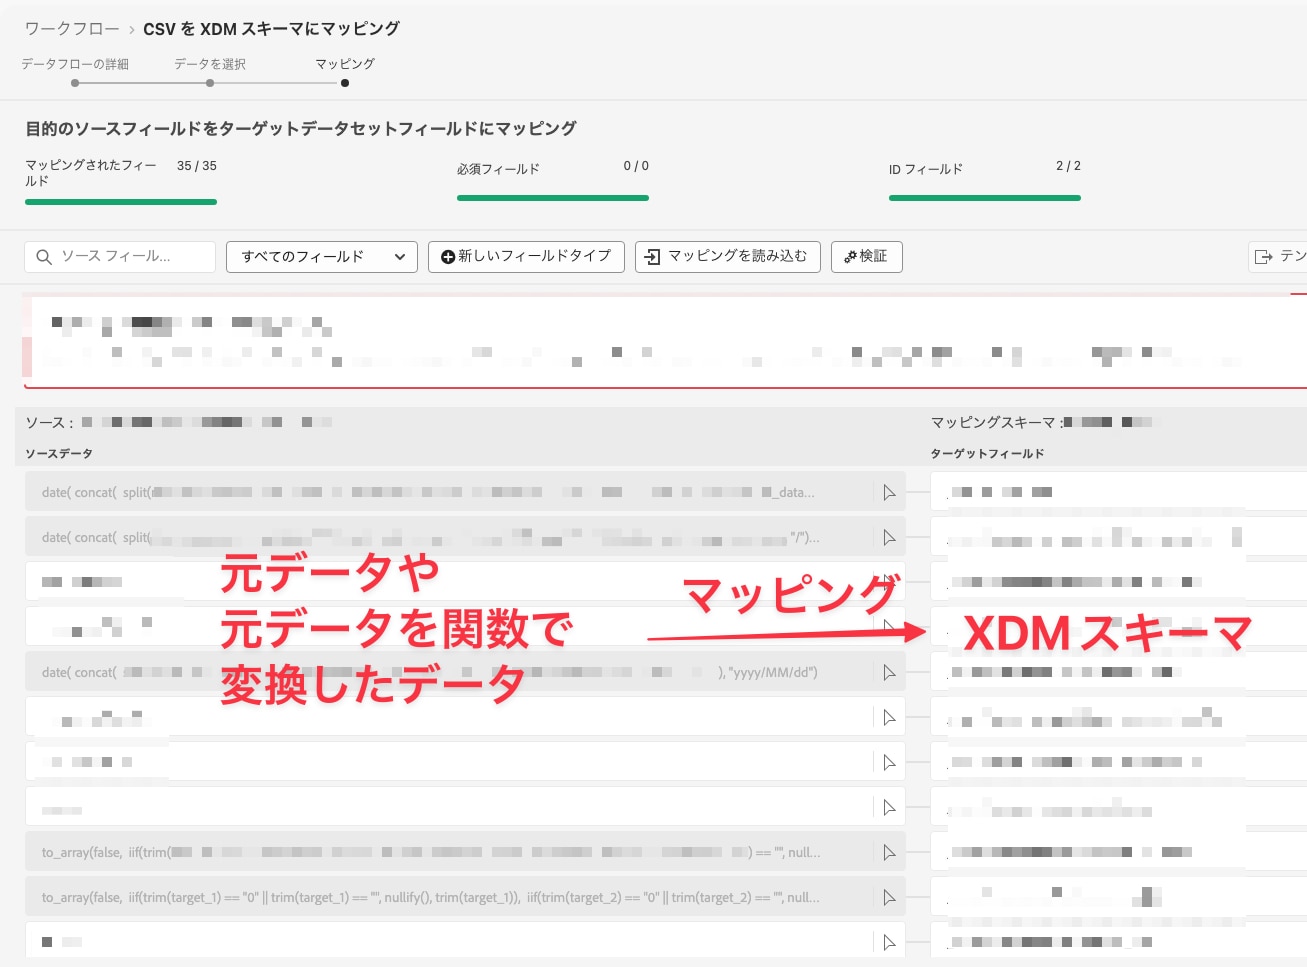
ただし、Data Prepはスキーマ設計の代わりではありません。
どのフィールドを持つべきか、どのデータ型にするか、Person IDとしてどのIDを使うか、商品情報を配列で持つか、といった設計は先に決める必要があります。Data Prepでできるのは、その設計に合わせて値を整えることです。
最初から xdm オブジェクトで正しいスキーマ構造を送れているなら、わざわざData Prepでマッピング・変換する必要はありません。特にオンラインデータの場合、つまり Web SDK を使う場合は、データ送信時点で XDMスキーマの構造にして送り、Data Prep はあまり使わない方がスッキリすると思います。
AAの処理ルールでやっていた整形の一部をData Prepに寄せる場面はありますが、同じ機能の置き換えではありません。Data Prepの役割は「AEPのデータセットに保存される前にXDMへ合わせる」ことです。
Data Prepで整えた値はデータセットに保存されるため、CJAのデータビューや派生フィールドで後から解釈を変える話(後述)とは、使うタイミングが違います。
取り込み時に形を確定した方がよいものはData Prepや上流のデータ基盤で整え、分析上の見せ方を変えたいものはデータビュー側で扱う、という切り分けで考えると整理しやすくなります。
2. [CJA]データセット:CJAで使う4種類のデータセット
CJAのデータセットという言葉は、AEP上のデータセットとは異なる概念になりますが、そのあたりはこの章の最後に簡単に言及しています。
CJAでよく使うデータセットは、大きく4つに分けられます。
イベントデータセット
プロファイルデータセット
ルックアップデータセット
概要データセット
それぞれ役割が違います。
AAの感覚で何でもヒットデータとして送るのではなく、データの性質に応じて分けて設計します。
イベントデータセット
イベントデータセットは、ページビュー、クリック、購入、メール開封、来店、コールセンター応対など、時系列で発生する行動データです。
CJA分析の主軸はイベントです。基本的には「誰が、いつ、何をしたか」を表します。
Webイベントとオフラインイベントを別々のイベントデータセットとして持つこともできます。
接続でそれらを束ねると、CJA上では同じ人物の時系列イベントとして扱えます。
スキーマ自体が違っても、フィールドが一部しか共通していなくても、接続自体はできます。
少し具体の話になってしまいますが、ここで重要なのが、同じ意味のフィールドは同じスキーマパスに揃えることです。
例えば、Webイベントでは商品IDを tenant.product.id に入れ、店舗購入イベントでは tenant.offlineProductId に入れてしまうと、CJA上では別フィールドとして扱われます。
同じ商品IDなのに、ルックアップが片方にしか効かない、データビューでコンポーネントが分かれる、ということが起きます。
逆に、複数のイベントデータセットで同じスキーマパスを使っていれば、CJAのコンポーネントペインでは1つのディメンションにまとまりやすくなります。「このコンポーネントはどのデータセット由来か」を分析したい場合は、データセットIDのような項目と組み合わせて確認します。
(※あくまでイベントデータセットでの話になります)
後から派生フィールドで補うこともできますが、最初からスキーマパスを揃えた方がきれいです。
プロファイルデータセット
プロファイルデータセットは、会員ランク、契約状態、性別、地域、会員登録日など、人物に紐づく属性を持ちます。
AAでいえば、ヒットごとに送るよりも、顧客マスタとして持ちたい情報に近いです。
ただし、CJAで分析に使う人物IDフィールドは、システムが勝手にいい感じに用意してくれるものではありません。
プロファイルデータセットでも、分析や接続で使うIDフィールドを自分たちで設計し、必要に応じてID属性を付けます。
そして、プロファイルデータセットはイベントデータセットとは見え方が違います。
複数のプロファイルデータセットに同じスキーマパスがあっても、自動的に1つのコンポーネントに統合はされません。
複数ソースの会員属性を統合したいなら、上流で統合するか、データビューの派生フィールドで整理するかを設計します。ただし、派生フィールドで何でも統合できるわけではありません。
プロファイル同士、イベント同士のように、データセットタイプの違いも意識する必要があります。
ルックアップデータセット
ルックアップデータセットは、AAの分類に近い役割です。
商品IDから商品名、商品カテゴリ、ブランドを参照する。
店舗IDから店舗名、エリア、業態を参照する。
キャンペーンIDからキャンペーン名、媒体、施策分類を参照する。
こういったマスタデータをCJA側で参照するために使います。
ルックアップは多段参照にも対応しますが、階層が深くなるほど、キーの品質と更新運用が重要になります。
また、同じルックアップデータセットを1つの接続内で何度も都合よく使い回せるとは限りません。
Webイベントとオフラインイベントで商品IDのパスが違う場合、同じ商品マスタを両方に素直にぶら下げられず、スキーマ統一や派生フィールド、別データセット化などを検討することになります。
(同じルックアップデータセットは、1つの接続に対して1つしか置けません。)
つまり、ルックアップの使いやすさは、イベント側のスキーマパス設計でかなり決まります。
概要データセット
概要データセットは、広告費、インプレッション、外部指数、日次目標値など、Person IDを持たない集計データを扱うためのデータセットです。
Person ID を持たないため、CJAの強みである人物軸分析からは切り離されています。
「別にCJAじゃなくても見られるのでは」というレポートになりがちで、単体では日常的に使うデータセットではないかと思います。
そこまで重要ではないので、深掘りしませんが、使う場合に気をつけた方がいい注意点だけ簡単に触れます。
やってはいけないのが、広告費などにダミーのPerson IDを付けて、無理やりイベントデータとして扱うことです。
例えば、広告費に personId = "dummy" を入れてイベント化すると、人物分析の軸を汚します。
Identity Graphや人物数にも悪影響を与える可能性があります。
広告費は広告費として、概要データセットとして扱う方が自然です。
ただし、概要データセットはイベントデータと自動的に同じ行へ並ぶわけではありません。
広告費と売上をキャンペーン別に見たい場合、イベント側のキャンペーンIDと概要側のキャンペーンIDを、データビューのSummary Data Groupで明示的にグループ化します。
この設定がないと、売上はイベント側のキャンペーン行に、広告費は概要側のキャンペーン行に出てしまい、同じ行でROASを計算できません。
概要データセットは「接続に追加すれば自動で名寄せされる」と思わないことが大事です。
AEPのデータセットとCJAのデータセット
ここから先は AEP のクラス・スキーマ と CJA のデータセット分類の対応関係に踏み込みます。
やや込み入った話なので、読者層別に読み方を変えてください。
初学者:最後の図(AEPデータ分類とCJAデータセットタイプの関係まとめ)だけ眺めればOKです。
本文は将来「これどうなっているんだ?」と疑問が湧いた時に戻ってきてください。設計者・実装者:AEP側のスキーマ設計が CJA 側のデータセット種別を決めるため、全部読んでおく価値はあると思います。
AEPのデータセット定義とCJAのデータセット定義は異なる
これまでに、CJAには「イベントデータセット」「プロファイルデータセット」「ルックアップデータセット」「概要データセット」の4種類あるということを説明してきました。
CJAに関する公式のドキュメントを見ても、これらの言葉がよく登場します。
また、データの流れとして
AEP:スキーマ → AEP:データセット → CJA:接続 → CJA:データビュー → CJA:レポート
ということもお話しました。
実は、CJAで「これはイベントデータセットだ」「こっちはプロファイルデータセットだ」と分類されるのは、「接続」のタイミングになります。
そして、AEPのデータセットには「イベントデータセット」「プロファイルデータセット」などの定義は存在しません。AEPの公式ドキュメントを見てもこれらの言葉は現れません。
何が問題かといいますと
AEPのどのようなデータセットを 接続したら、CJAの「イベントデータセット」になるのか?
同様に、AEPのどのようなデータセットを接続したら、CJAの「プロファイルデータセット」になるのか?
といったところが非常に分かりづらいです。(仕様としては1回理解すれば分かると思うのですが、Adobeのドキュメントからここを汲み取るのがとてもつらい、という意味です)
この部分を少し説明していきます。
AEPのデータ分類
まず、AEP上のデータは以下の3つの動作タイプに分類されます。
レコード
時系列
アドホック
アドホック(特定の連携などで内部的に生成される一時データ)については今回深掘りはしません。
重要なのはレコードと時系列です。
では、データが「レコード」なのか「時系列」なのかがどこで決まるかといいますと、「クラス」で定義されます。
クラスとは?
この記事におけるデータの流れとしては「スキーマ」からスタートしていますが、実は「スキーマ」を作成する際に「クラス」というものを選択する必要があります。
クラスの役割は主に2つあります。
データの挙動を決める(時系列 or レコード)
よく使うフィールドをクラスにまとめると、スキーマをまたいですぐに設定できる
今回重要なのは「1」の役割ですね。
実際のスキーマ作成画面を見てみましょう。
以下はスキーマを作成するときに、「クラスを選択」する画面です。
表示名と出ているのがクラス名で、動作の箇所に「レコード」or「時系列」の記載があります。

スキーマを作成する際に「クラス」を1つ選択する必要があります。
※スキーマとクラスは必ず 1:1 対応であり、1つのスキーマに複数のクラスを選ぶことはできませんし、クラスを1つも選ばないこともできません。
クラスの動作タイプが「レコード」か「時系列」かによって、
その後のスキーマ、データセットについても「レコード」なのか「時系列」なのかが決まります。
なお、「クラスを作成」というボタンが見えると思いますが、カスタムでクラスを作ることもできます。
その際もまず最初に「レコード」として作るのか「時系列」として作るのかを選択することになります。

つまり
クラスで「時系列」を選ぶ
→ そのクラスを選んだスキーマは「時系列」になる
→ そのスキーマから生成されたデータセットは「時系列」になる
というイメージです。「レコード」についても同様です。
AEPデータセットとCJAデータセットの関係
さて、ここからが本題です。
結論からいきます。
「時系列」のデータセットは CJAに接続した際に “基本的に”「イベントデータセット」になります。
「レコード」のデータセットは CJA に接続した際に “基本的に”「ルックアップデータセット」になります。
「基本的に」というところが味噌でして、それぞれ1つずつ例外があります。
「時系列」であっても「XDM Summary Metrics」クラスを選んだ場合は、CJAでは「概要データセット」になります。

つまり、「XDM Summary Metrics」クラスを選択したスキーマから生成されたデータセットを
接続すると、CJAでは「概要データセット」と認識される、ということです。
(XDM Summary Metricsは時系列の分類だが、「イベントデータセット」にはならない)
以上が「時系列」の例外でした。
また、「レコード」であっても「XDM Individual Profile」クラスを選んだ場合は、CJAでは「プロファイルデータセット」になります。

つまり、「XDM Individual Profile」クラスを選択したスキーマから生成されたデータセットを
接続すると、CJAでは「プロファイルデータセット」と認識される、ということです。
(XDM Individual Profileはレコードの分類だが、「ルックアップデータセット」にはならない)
以上が「レコード」の例外でした。
ここまでの要点
「クラスの動作タイプ(レコード/時系列) + 特殊クラス (XDM Individual Profile / XDM Summary Metrics)」の組み合わせで、CJAでの4データセット種別(イベント/プロファイル/ルックアップ/概要)が決まる。
AEPデータ分類とCJAデータセットタイプの関係まとめ
今までの話をざっくり1つの図にすると以下のような感じになります。

最初にも記載したように、完全にCJA初学者の方はこの章がよく分からなくてもスルーいただいて大丈夫です。
疑問に思ったタイミングで「そういえばExtureの記事になんか書いてあったな」と思っていただければ。
3. [CJA]接続:接続(connection)はデータセットを束ねる場所
接続は、AEP上のデータセットをCJAで分析可能にするレイヤーです。
1つの接続には複数のデータセットを含められます。
Webイベント、アプリイベント、CRMプロファイル、商品ルックアップなどを1つの接続に束ねる、といった設計ができます。
接続の画面は以下のような感じです。

データセットタイプを見ていただくと、イベント、プロファイル、参照(ルックアップ)が接続されていることが分かります。
接続で大事なのは、主に次の3つです。
どのデータセットを入れるか
各データセットの人物IDを何にするか
どの期間のデータを保持するか(ローリングデータウィンドウ)
なお、実装直後は接続UIでデータヘルスを確認します。
追加されたレコード、スキップされたレコード、削除されたレコードがどうなっているかを見て、timestamp欠損や人物ID欠損によるスキップが増えていないかを確認します。
Person ID は CJA の軸になる
CJAでは、接続に含めるデータセットごとに人物IDを指定します。
ただし、データセットごとに別々のIDを好きに選べばよい、という話ではありません。
横断分析したいデータセット同士では、指定した人物IDが同じ人物を表すID体系になっている必要があります。
カラム名やスキーマパスが違っていても、値の意味が同じならつながります。
逆に、スキーマが同じでも、一方はECID、もう一方は会員IDのようにID体系が違えば、そのままでは同じ人物としてはつながりません。
例えば、Webイベントでは ECID = 1111 をPerson IDにし、店舗購買データでは 会員ID = A9999 をPerson IDにしたとします。この時点で、CJAの人物軸には 1111 と A9999 という別々のPerson IDが入ります。
CJA内にECIDと会員IDの対応表やプロファイルデータがあったとしても、Person ID列がレポート時に自動変換され、同一人物としてつながるわけではありません。
プロファイルやルックアップは、属性付与や分類には使えます。
しかし、接続で採用したPerson IDの軸そのものを、後から別のIDへ自動的に置き換えるものではありません。
Web、CRM、店舗、コールセンターを一気通貫で見たいなら、ステッチ済みデータセットを使う、上流で共通IDに解決する、Web側のPerson IDも会員IDやステッチIDへ寄せるなど、接続に入る時点でPerson IDの意味を揃える設計が必要です。
もしPerson IDが空のイベントが多ければ、その分だけ接続で取り込まれず、分析から欠落します。
Person IDが未設定のレコードは、そのPerson IDを使う接続では基本的にドロップされると考えた方が安全です。
unknown や null という文字列を固定値のように入れてしまうのも危険です。
本来別人であるイベントが1つのIDに折りたたまれる可能性があります。
大文字小文字の揺れ、前後空白、ID体系の変更、会員統合後の旧IDなども、CJAではそのまま分析品質に響きます。
AAでは「とりあえずeVarに会員IDを入れておく」で済んだかもしれません。
CJAでは、Person IDはデータセットを横断してジャーニーを作るための根幹です。
IDステッチは魔法ではない
CJAの魅力として、前述のようにIDステッチがあります。
前述したように、未ログイン時のECIDやFPIDなどの永続IDと、ログイン後の会員IDのような一時IDをつなぎ、匿名行動と認証後行動を同じ人物に寄せて分析できます。
ただし、ステッチは魔法ではありません。
元データにIDの関係が出ていなければ、つなぎようがありません。
ステッチにはフィールドベースとグラフベースの2種類あり、どちらを使うかで「元データ」がどこになるのかが異なります。
詳細には踏み込みませんが、例としてフィールドベースのステッチでは
同じデータセット内に永続IDと一時IDの両方が現れたイベントを起点に処理します。
(ここのデータセットは、CJAのデータセットというよりは、AEP上のデータセットを指します)
ログインイベントやログイン後ページビューで、ECIDと会員IDが同じイベントに存在している必要があります。
Web SDKでログイン済みのIDを送る場合、ECIDを自分で生成して identityMap に書く必要は基本的にありません。
ECIDはWeb SDKとEdge Networkによって生成・管理されます。
実装側では、ログイン時に判明した会員IDやCRM IDを追加で送ります。
1 2 3 4 5 6 7 8 9 10 11 | alloy("sendEvent", { xdm: { identityMap: { MemberID: [{ id: "member-12345", authenticatedState: "authenticated", primary: true }] } }}); |
MemberID は例なので、実際にはAEP側で定義した ID名前空間のIDシンボルに合わせます。
このイベントで実装者が明示的に送っているのは会員IDだけですが、Web SDK側ではECIDも同じイベントのIDとして扱われます。
フィールドベースステッチでは、この「同じイベント内にECIDと会員IDが存在する状態」が重要です。
CJAのステッチ設定で、永続IDにECID、一時的なIDに会員IDを使うように設計すると、ECIDだけで記録されていた匿名イベントを、後から会員ID側の人物と統合して分析できます。
identityMap はIDを送るための器であり、それ自体がCJAの人物軸を決める設定ではありません。
接続で何をPerson IDとして使うのか、ステッチ設定でどのIDを永続ID・一時IDとして扱うのか、ID名前空間をどう管理するのか、などを設計する必要があります。
ECIDを手動でハードコードしたり、空の会員IDを送ったりすると、IDグラフやステッチ結果を汚す原因になりかねないため、避けましょう。
CJAで分析対象にするデータ期間とコストを設計する
CJAでは、接続レベルで、イベントデータのタイムスタンプを基準に「CJA側で分析対象にする過去期間」を月単位で制限できます。現在のUIでは「周期的なデータ期間を有効にする」、公式ドキュメントでは「周期的なデータ時間枠」という表現で書かれてたりします。

これはAEP Data Lakeに保存されている元データの保存期間を直接決める設定ではありません。
AEPに残っているデータのうち、CJAの接続でどこまで過去を取り込み、レポート対象にするかを決める設定だと考えると分かりやすいです。
このCJA側で取り込むデータ数(レコード数)が、課金対象になってくるわけです。
AAではサーバーコール課金の感覚が強かったかもしれませんが、CJAではレポートで参照できる行数や保持期間がコスト・ライセンス管理の論点になります。サーバーコール感覚から、行数感覚への切り替えが必要です。
すべてのデータを長期間保持すれば分析の自由度は上がります。
一方で、必要以上に古いイベントを参照すると課金対象の行数が増えます。
「どの分析に何ヶ月分必要か」は、実装前に決めておくべきです。
速報分析、キャンペーン分析、LTV分析、年次比較では必要な期間が違います。
CJAではデータ保持も分析設計の一部です。
4. [CJA]データビュー:データビューは CJA の分析ルールブック
CJAで一番重要な設定レイヤーは、データビューです。
データビューは、接続されたデータをWorkspaceでどう見せるか、どう計算するか、どう解釈するかを決めます。
CJAでは、指標・ディメンションの定義、アトリビューション、永続性、セッション、重複排除、派生フィールドなど、多くの分析ルールがデータビューに集まります。
1つの接続から、ブランド別、目的別、チーム別など、複数のデータビューを並べて運用できます。
コンポーネントは作るもの
AAでは、eVarやpropやeventがあり、それがそのままレポートコンポーネントとして見えていました。
CJAでは、XDMフィールドをデータビューに追加し、それをディメンションとして見せるのか、指標として見せるのか、どの名前で表示するのかを決めます。

例えば、同じ数値フィールドを、あるデータビューでは「売上」として使い、別のデータビューでは条件付きの「対象商品売上」として使うことができます。
文字列フィールドから条件付き指標を作ることもできます。
例えば eventType = "form_submit" のときに1を数える、特定のURLパターンを含むイベントだけを指標化する、といった設計です。
この柔軟さは便利ですが、同時にガバナンスが必要です。
名前の付け方、表示/非表示、説明文、同じ意味のコンポーネントの重複を管理しないと、Workspace上がすぐに散らかります。
永続性とアトリビューションは分けて考える
AA経験者がCJAのデータビューでつまずきやすいのが、永続性とアトリビューションです。
一言でいうと、永続性はディメンション値の「保持ルール」、アトリビューションは指標の「配分ルール」です。
設定 | 主な対象 | 何を決めるか |
|---|---|---|
永続性 | ディメンション | ディメンション値を後続イベントにどう持ち続けるか |
アトリビューション | 指標 | 売上やCVをどのディメンション値の成果として集計するか |
例えば、次のようなユーザー行動があったとします。
1 | Google -> Yahoo -> 購入 |
購入イベント自体にはチャネル値(媒体名)が入っていないとします。
まず永続性で考えるのは、「購入時点のチャネルをどう扱うか」です。
これはディメンションの話。
永続性なし: 購入イベントのチャネルは空のまま
永続性: 最新 / セッション: 購入時点のチャネルは Yahoo
永続性: オリジナル / セッション: 購入時点のチャネルは Google
これは、AAのeVarで有効期限や配分を設定していた感覚に近いです。
AAでは、eVarには通常の収集値とは別に永続値があり、その永続値はeVarの有効期限と配分によって決まります。
AAのレポートでeVarと注文数を見るときも、多くの場合はこの永続値を見ています。
次にアトリビューションで考えるのは、「購入1件をどのチャネルの成果として集計するか」です。
これは指標の話。
ラストタッチ: Yahoo に100%
ファーストタッチ: Google に100%
線形: Google と Yahoo に 50% ずつ振る
ここで、直感に反するような指定もできます。
例えば、チャネルディメンションの永続性で「最新 / セッション」を指定すると、購入時点のチャネルは直近の Yahoo になります。
一方で、購入指標のアトリビューションに「線形 / セッション」を指定すると、購入1件を Google と Yahoo に 0.5 ずつ配分できます。
設定する場所 | 指定例 | 見え方 |
|---|---|---|
チャネルディメンションの永続性 | 最新 / セッション | 購入時点のチャネルは |
購入指標のアトリビューション | 線形 / セッション | 購入1件は |
購入時点の値をどう保持するかと、購入という指標をどこに配分するかは、別の設定だからです。
ここで大事なのは、永続性とアトリビューションは独立して同時に効くという点です。
永続性で「購入時点のチャネルはYahoo」と決めつつ、アトリビューションで「線形配分」を指定すれば、購入件数はGoogleとYahooに分散します。
「保持ルール」と「配分ルール」は別々の設定であり、片方を変えてももう片方は自動的に連動しません。
AAでは、この2つがeVar設定の中で一体に見えやすかったと思います。
CJAでは、ディメンション値をどう保持するかは永続性で決め、売上やCVをどう配分するかはアトリビューションで決めます。
ここを分けて設定できるのがCJAの柔軟なところです。
同じディメンションでも、「永続性なし」「セッション内の最新」「30日間の最新」のように複数のディメンションを作れます。同じ売上指標でも、「ラストタッチ」「ファーストタッチ」「線形」のように複数の指標を作れます。
ただし、柔軟な分だけ、AAと数字を比較するときには注意が必要です。
CJAの数値がAAと違うときは、実装ミスだけでなく、データビューの永続性、アトリビューション、セッション定義、重複排除(後述)が揃っているかを確認します。
↓ディメンションの設定画面↓

↓指標の設定画面↓

永続性の種類とデフォルト
現在(2026年5月現在)、CJAでは以下の5種類の永続性モデルを選ぶことが可能です。
永続性の配分モデル(5種類)
配分モデル | 動きのイメージ | 典型ユースケース |
|---|---|---|
最新(Most Recent) | 直近で観測された値で上書きし続ける | ラストタッチ的なキャンペーン、チャネル、ページ |
オリジナル(Original) | 最初に出た値を保持し、以後上書きしない | ファーストタッチチャネル/キャンペーン |
すべて(All) | 出現したすべての値を並行して有効にする | 全接点への線形的な貢献度分析 |
知られる限り最初(First Known) | 分析期間内で最初に観測された値を、過去・未来の全イベントに適用 | 「初期ステータス」(登録時国、最初の会員種別など)で全期間を見る |
最後に確認(Last Known) | 分析期間内で最後に観測された値を、過去・未来の全イベントに適用 | 「現在ステータス」(現在の会員ランクで過去の購入履歴を見る)など |
AAのeVarでは「最新(Last Touch)」「オリジナル(First Touch)」「線形」の3択が中心でしたが、CJAではさらに2つのモデルが加わっています。特に「最新」と「最後に確認」は混乱しやすいです。
「最新」はヒット発生時に値を保持して後続に継続させるのに対し、「最後に確認」は分析期間内の最後に観測された値を過去のイベントに遡って適用します。同じ「ラストタッチ系」でも動きがかなり違います。
ここで注意したいのは、CJAのディメンションはデフォルトで「最新 / セッション」になるわけではないことです。
データビューで永続性を明示的に有効にしない限り、ディメンションは同じイベント内に存在する指標にしか関連付けられません(永続性を有効にしない限り、上述の5種類のどれにもならない)。
つまり、購入イベントにチャネル値が入っていないなら、永続性を設定していない状態では、その購入はチャネルに紐づきません。
派生フィールドで過去データの解釈を変える
派生フィールドは、CJAの強力な機能です。
URLからカテゴリを抽出する、クエリパラメータを整形する、複数フィールドを結合する、CASE WHENでマーケティングチャネルを分類する、日付差分を見る。こうした処理をデータビュー側で定義できます。
例えば、以下のようなことをやりたい場合・・・
1 2 3 | IF url contains "/products/" THEN "商品"ELSE IF url contains "/support/" THEN "サポート"ELSE "その他" |
次のような設定が可能です。

AAの処理ルールや分類に近い役割ですが、CJAでは過去データにも同じ解釈を適用できる点が大きな違いです。
派生フィールドは強力ですが、万能の処理レイヤーとして使いすぎない方が良いです。
複雑すぎるロジック、重い正規表現、イベントごとの厳密な計算、外部データとの高度な結合は、取り込み前処理やData Prep、データ基盤側に寄せた方がよい場合があります。
そもそも派生フィールドを作成できる上限もありますので、どのシーンで使うかはよく考えましょう。
データビューは強力ですが、全部をデータビューでやる場所ではありません。
重複排除は明示する
AAのpurchaseやイベントシリアライズに慣れていると、CJAでも購入IDを送っていれば自動で重複排除されると思いがちです。
しかしCJAでは、CVや売上などの指標に対して、データビュー側で『指標の重複除外』を明示的に設定します。
サンクスページのリロード、再送、二重クリック、アプリのリトライ送信などは、普通に起きます。
購入IDや申込IDがあるなら、それを重複排除キーとして使う設計にすると良いかと思います。
ここを忘れると、CJA移行後に「AAより売上が多い」「CVが増えた」という話になる可能性もあります。
実装の問題ではなく、データビューの指標定義の問題かもしれません。

5. Web SDK:Web SDK実装は「送る前の設計」が9割
CJA向けのWeb実装では、Adobe Experience Platform Web SDK、つまりAlloy.jsを使うのが基本です。
とはいったものの、コードを直書きするのではなく、Adobe Data Collection のテンプレートを使うケースが多いとは思います。
しかし、本記事では Adobe Data Collection の細かな設定方法には踏み込まないのと
「何をしているのか」という『意味』を捉える上では、実際のコードを見た方が分かりやすいこともあるため
この記事では何かを例示する場合は alloy.js のコードを記述しています。
AAのAppMeasurementでは、ページビューは s.t()、リンククリックは s.tl() でした。
Web SDKでは、基本的に sendEvent に統一されます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | alloy("sendEvent", { xdm: { eventType: "web.webpagedetails.pageViews", web: { webPageDetails: { name: "Product Detail", URL: location.href, pageViews: { value: 1 } } } }}); |
ここで注意したいのは、sendEvent のpayloadをAAがページビューとして扱う条件と、CJAで何をページビュー指標として数えるかは別の話だという点です。
AAへ送る場合、Edge Networkでは xdm.web.webPageDetails.name や URL、または xdm.eventType = "web.webpagedetails.pageViews" などを見て、ページビューかリンクイベントかを判定します。
これはAA側のhit type判定の話です。
一方、CJAでは、何を「ページビュー」として集計するかはデータビュー側の指標定義で決めます。
eventType = "web.webpagedetails.pageViews" のデータの場合にページビューとして数えてもいいですし、XDMの web.webPageDetails.pageViews.value を送ってそれを指標にしてもいいです。
通常のWeb計測で「1ページビューイベント = 1ページビュー」と考えるなら、eventType を条件にした指標の方が分かりやすいと思います。
一方、集計済みデータを取り込む、または明示的な数値指標としてページビュー数を持たせたいなら、pageViews.value を使う設計もあります。
どちらにしても重要なのは、ページビューとして数えたいイベントを一貫したルールで送信し、データビューでそのルールに沿って指標化することです。
CJAでは、ページやページビューのような基本的なコンポーネントでさえ、AAの s.t() のように「このメソッドで送ったから標準のページビューに入る」と考えるより、自分たちのデータモデルとデータビューで定義するものとして扱います。
なお、1ページ内でAppMeasurementとWeb SDKを混在させる実装は避けます。
サーバーコール、Cookie、ID解決などが衝突して挙動が不安定になる可能性があります。
移行は、サイト全体やページ単位で計画します。
CJA向けのデータは最終的にXDMへ入れる
Web SDKには xdm オブジェクトと data オブジェクトがあります。
ただし、CJAで分析するデータは、最終的にAEPのデータセットへXDMとして入っている必要があります。
data オブジェクトは、XDMスキーマに一致しないデータをAdobeへ送るための領域です。
AA、Target、Audience Managerのような非XDMシナリオでは便利ですが、data.__adobe.analytics.eVar12 のようなAA変数を送っても、それがそのままCJAのデータセットに入るわけではありません。
↓CJAでは避けるべき例↓
1 2 3 4 5 6 7 8 9 10 | alloy("sendEvent", { data: { __adobe: { analytics: { eVar12: "gold", events: "event42" } } }}); |
既存のデータレイヤーを data オブジェクトで送る場合でも、CJAで使うにはDatastreamのData PrepでXDMフィールドへマッピングします。XDMにマッピングされていない値はCJAから見えるデータにはなりません。
そのため、CJA向けのWeb SDK実装では、基本的には xdm オブジェクトで送ります。
会社やサービスの中で意味のあるデータ構造を XDMスキーマの形式に落とし込んで送るということですね。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | alloy("sendEvent", { xdm: { eventType: "commerce.productViews", commerce: { productViews: { value: 1 } }, _tenant: { member: { id: "member-12345", rank: "gold" }, product: { id: "SKU-001", category: "supplement" } } }}); |
datastreamはサーバー側の分岐点
Datastreamは、Web SDK から Edge Network に届いたイベントを、AEP、AA、Target、イベント転送 などへルーティングする設定です。CJAでデータを見るためには AEP にデータを送ります。


既存のAA 実装がすでにWeb SDKを使っている場合は、DatastreamにAEPへの送信を追加する形で、AAの既存レポートを残しながらCJA側を検証できます。Adobeのアップグレードガイドでも、この方法は既存Web SDK実装がある場合の移行パスとして説明されています。
ただし、これは「AA向けの実装をそのままCJAの理想形にできる」という意味ではありません。
既存のAA実装が data.__adobe.analytics.eVar12 や prop、event のようなAA変数前提で作られている場合、CJAで使うにはDatastreamのData PrepでXDMフィールドへマッピングする必要があります。
新しい項目を追加するたびに、AA変数へ入れてからXDMへマッピングするのか、XDMオブジェクト側に直接入れるのかを考えることになり、時間がたつほど実装の見通しが悪くなりがちです。
そのため、既存AAレポートを止めずに並行検証するための移行手段としては有効ですが
一方で、CJAを長期的に使う前提なら、eVar/prop/event番号を引きずるより、最初からXDMスキーマを設計し、会員、商品、チャネル、ページ種別など、会社として意味が分かるフィールドとして送る方が扱いやすくなります。
また、マッピング処理を挟む関係で、AAで見えるからCJAでも正しく入っている、とは限りません。
値の正確性は、Edgeへ送ったpayload、Datastreamの処理、AEPデータセット、CJA接続、データビューの各段階で確認しましょう。
SPAでは参照元と仮想ページビューの扱いを決める
SPAでは、最初のページロード後にブラウザのページ遷移を伴わず、ルーティングだけが変わることがあります。
この場合、画面遷移のたびに仮想ページビューを送る設計になります。
これはCJAだけの話ではなく、AA でも、AppMeasurement.js でもWeb SDKでも起きうるSPA計測の論点です。
SPAでリファラーをどう扱うか – 設計の選択肢
通常のページ遷移であれば、ブラウザの document.referrer は遷移後のページから見た前ページURLになります。
(外部サイトから来れば外部URL、サイト内移動なら内部URL)
一方、SPA内の仮想ページビューでは、ブラウザのページロードが発生しないため、通常のページ遷移のように document.referrer が画面遷移ごとに自然に更新されるわけではありません。
そのため、仮想ページビューごとに webReferrer をどう扱うかを「実装者が決める」必要があります。
よくある選択肢は次の4つかと思います。
SPA内の前画面URLを毎回 webReferrer として送る(最も素直、実務で多い)
前画面URLは別フィールド(例:previousPageUrl)に分けて送り、webReferrer は初回のみ
仮想ページビューでは webReferrer を送らず、データビューの永続性で初回値を引き継ぐ
何もしない(仮想ページビューには webReferrer が入らないままになる)
正解はサイトや分析要件によって異なります。
「ページ遷移の前後関係を素直に追いたい」なら 1 や 2、
「セッション全体の流入元として保持したい」なら3、といったイメージです。
例:選択肢3(永続性で持たせる)の実装
ここでは、選択肢3(仮想ページビューでは webReferrer を更新せず、データビュー側の永続性で後続イベントに引き継ぐ)を例にとります。
コード側で何を残し、データビューで何をもたせるかが分かれていることを具体的に見るための例として読んでください。(あくまで例で、これが正解という話ではないです)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | // SPA内の仮想ページビューでは webReferrer を更新しない設計例。// 実際のプロパティ名は送信しているXDM/data構造に合わせて確認する。let firstPageViewSent = false;alloy("configure", { onBeforeEventSend: function(content) { if (content.xdm?.eventType === "web.webpagedetails.pageViews") { if (firstPageViewSent && content.xdm.web?.webReferrer) { delete content.xdm.web.webReferrer; } firstPageViewSent = true; } }}); |
この実装を組み合わせて、CJAのデータビュー側でリファラーディメンションに
「永続性: 最新 / 有効期限: セッション」を設定すると、初回ページビューで観測されたリファラーが、同じセッション内の後続イベントへ引き継がれます。
まとめ:コードとデータビューの分業
SPAの参照元設計は、コード側で webReferrer を送る・送らないを決めるだけでは完結しません。
コード:元データとしてどの値を残すか
データビュー:その値を分析上どこまで持たせるか
この2層を分けて設計しないと、「ビーコンは正しく見えるのに、レポートでは期待した参照元に数字が紐づかない」が起きたりします。
ここで大事なのは、コードの形そのものよりも、参照元やチャネル判定に使う情報をいつ送るか、そしてCJAのデータビューでどう保持・集計するかです。
AA側で自然に見えていた参照元やチャネルも、CJAでは元データ、Datastream、データビューのどこで解釈しているかを確認する必要があります。
自動リンクトラッキングのlinkName問題
Web SDKの自動リンクトラッキングは便利です。
ただし、すべてのリンククリックをそのまま送ると、不要なイベントが増えます。
ナビゲーション、フッター、同じ導線の連打、計測対象外リンクなどが大量に入ると、行数や分析品質に影響します。
また、リンク名が空になるリンクにも注意が必要です。
アイコンだけのリンクなど、自動で linkName が取得できない場合は linkName が空文字扱いになり、そうするとクリックイベント自体が送信されません。
(※どのように linkName を自動取得しているかは後述の補足で簡単に記します)
これは地味に厄介で、onBeforeEventSend (AAでいうと doPlugins のようにイベント送信の前に必ず動くメソッド) のような送信前フックでは対処できません。
なぜなら、クリックイベント自体が発生しないので、「イベント前に必ず動くメソッド」も動きません。(イベントが発生しないのだから、イベント前に動くやつもそりゃ動かないよね、という話)
そのため、filterClickDetails のようなクリック収集側のフックで、linkName を補完する必要があります。
あくまで例ですが例えばこんな感じです。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 | alloy("configure", { clickCollectionEnabled: true, clickCollection: { internalLinkEnabled: true, downloadLinkEnabled: true, externalLinkEnabled: true, filterClickDetails: function(content) { const linkUrl = content.linkUrl || content.clickedElement?.href || ""; if (!content.linkName) { try { const linkPath = linkUrl ? new URL(linkUrl, window.location.href).pathname : ""; content.linkName = linkPath.split("/").filter(Boolean).pop() || "link"; } catch (e) { content.linkName = "link"; } } if (linkUrl.includes("/admin/")) { return false; // 不要クリックは送らない } return true; } }}); |
ダウンロードリンクの自動収集でも同じ問題が起きやすいので、ファイル名をURLから補完する処理を入れておくと安全です。
linkName自動取得の優先度
ユーザーがサイト内の要素をクリックすると、 alloy.js は以下の優先度に従って自動で linkName を取得しようとします。
順位 | 取得元 |
|---|---|
1 |
|
2 |
|
3 | 子孫テキストノードの |
4 |
|
5 |
|
6 |
|
7 |
|
8 |
|
9 |
|
10 |
|
そして何も見つからない場合は最後に「空文字」が linkName に入ります。
しかし前述のように、linkName が空文字の場合は、自動クリックイベントを生成する際にバリデーションに引っかかり、イベントが送信されなくなります。(ここでは詳細には踏み込みませんが、「経験上」という話ではなく、「alloy.js」のコードベースでそのような仕様になっています。)
そのため、linkName が自動取得されない場合を想定しておくと良いかもしれません、というお話でした。
client hints は必要なものを明示する
User-Agent削減の流れにより、ブラウザやOSの詳細情報を従来どおり取れないケースがあります。
Web SDKでは、デフォルトで取得されるコンテキスト情報と、明示的に指定しないと取れない情報があります
まず、低エントロピーの Client Hints は Web SDKではデフォルトで有効になっており、リクエストのたびに渡されます。
高エントロピーの Client Hints が必要なら、alloy("configure") の context に highEntropyUserAgentHints を含めます。
1 2 3 4 5 6 7 8 9 10 11 | alloy("configure", { datastreamId: "YOUR_DATASTREAM_ID", orgId: "YOUR_ORG_ID@AdobeOrg", context: [ "web", "device", "environment", "placeContext", "highEntropyUserAgentHints" ]}); |
なお、context は指定しなければ、highEntropyUserAgentHints (と oneTimeAnalyticsReferrer)以外は自動で収集されます。
ただし、highEntropyUserAgentHints を含める際に、highEntropyUserAgentHints だけ設定するとミスります。context を手動で記述する場合は、明示的に記載していないものは収集されなくなります。
つまり、デフォルト + highEntropyUserAgentHints にしたいなら、上述のようにすべて書く必要があります。
※timestamp と implementationDetails については常時送信されるため、context を手動で記述する場合も省略可能です。
XDM実装で困りやすいポイント
ここからは、少し実践よりの注意点です。
しかも、一般的な注意点というわけでもなく、筆者が個人的に感じた注意点になりますので、話半分で見るくらいで良いです。
CJAはレポート時処理が強力ですが、XDMスキーマは何でも後から好きに直せるわけではありません。
AEPでは、データを取り込んだ後のスキーマ変更には強い制約があります。
既存フィールドの削除や、データ型の変更は基本的に重く考えるべきです。
不要になったフィールドは「削除」ではなく「非推奨(Deprecated)」として扱い、CJA側で非表示にする運用になることがあります。
オプション項目を後から必須に変えることも、過去レコードとの整合性を壊すため現実的ではありません。
つまり、「CJAは後から直せるから、とりあえず適当にスキーマを作る」は危険です。
後から柔軟にできるのは、主にデータビューでの解釈です。
元データとして存在しないもの、型が間違って取り込まれたもの、ID設計が破綻しているものは、データビューだけではきれいに救えません。
スキーマ設計で特に注意したいのは、_id、timestamp、人物ID、null/空文字、配列、そしてフィールドグループです。
_id は何者なのか
普段からデータベース等に触れている方なら馴染み深く当たり前かもしれませんが、
_id は、本記事で何度も出ている Person ID ではなく、レコードを識別するためのIDです。
正直、CJA単体の分析だけを見ると、_id をそれほど意識しなかったりもします。(特に Web SDKの場合)
ただし、AEP全体としては「_idは必須・重複なし」の方針で設計しておく方が安全です。
Real-Time CDPなど他のAEPサービスを使う場合、_id の重複がプロファイル連携や取り込み品質に影響する可能性があります。
特に注意すべき点は、重複を避ける単位を小さく見積もらないことです。
1バッチの中で一意であればよい、1データセットの中で一意であればよい、という発想では足りない場面があります。複数データセットや長期運用を考えるなら、サンドボックス全体で一意になる前提で設計するのが安全です。
実装側で一意なIDを作れるなら、イベント種別、ユーザー識別子、タイムスタンプ、乱数などから生成します。
入力元で難しい場合は、Data PrepのUUID生成関数で、取り込み時に付与する設計も検討することができます。
重要なのは、_id を「会員ID」や「ECID」の代わりに考えないことです。人物をつなぐためのIDは別途設計します。
なお、Web SDK でのデータ送信では xdm._id は自動で値が入るので特に意識しなくて問題ないです。
(ブラウザ側のalloy.js が挿入してくれるわけではなく、Edge Network 側で補完されます。そのため、例えば ブラウザの DevToolsの Network ペイロードを見ても、xdm._id はありません。確認する場合は Edge Network の Logを見ましょう。)
オフラインデータなどをAEPへ取り込むケースでは、考慮が必要になることがあります。

timestamp は形式とタイムゾーンに注意する
これも普段から timestamp まわりに気を配っている方であれば「何をいまさら」という感じかもしれませんが、CJA/AEPでも注意が必要な部分です。
イベントデータにおいて、timestamp は非常に重要です。
CJAは時系列の分析ツールなので、時刻がずれるとセッション、ジャーニー、アトリビューション、前後関係がすべてずれます。
Web SDKでWebイベントを送る場合、timestamp は自動で付与されます。
そのため、Web SDKで「ブラウザ上で発生したイベント」を送るだけなら、毎回自分で timestamp を作る必要は基本的にありません。
一方で、CSVやバッチ取り込み、サーバーサイド連携、過去イベントの取り込みなどでは、timestamp を自分たちで明示する必要があります。
基本は、タイムゾーン付きのISO8601形式で送ります。
1 2 3 | { "timestamp": "2026-05-01T10:30:00+09:00"} |
元データがCSVで 2026/05/01 10:30:00 のような形式になっている場合は、Data Prepや取り込み前処理でISO8601形式へ整形します。
Data Prep を挟まなくても自動で変換できる場合もありますが、タイムゾーン情報が抜けていると意図しない時刻として解釈される可能性があります。そのため、タイムゾーンを持たないローカル時刻を扱う場合は、Data Prepや取り込み前処理で明示的にタイムゾーンを付けた方が安全です。
というわけで、怖いのはタイムゾーン情報を忘れることです。
日本時間のつもりで送った値がUTCとして解釈される
CJAのデータビュー設定でタイムゾーンを日本時間に設定している
という条件が揃うと、レポート表示時間が大きくずれることになります。(UTCと日本時間では9時間ずれる)
日付別の売上、キャンペーン開始直後の効果、特定の時間帯の行動分析などで、見え方が歪みます。
さて、Data Prep には date 関数という関数があり、これを使うと便利です。
date(DATE, FORMAT) の形で呼び出すと、ISO8601形式に変換してくれる関数です。
便利な一方、使い方には注意が必要です。
例えば、CSV上で 2026/05/01 10:30:00 というデータがあるとします。
これをそのまま取り込む、あるいは date("2026/05/01 10:30:00", "yyyy/MM/dd HH:mm:ss") で変換すると
2026-05-01T10:30:00.000Z という ISO8601形式になります。
一見すると良さそうですが、これだとタイムゾーンが UTC になってしまいます。
そして、データビュー側の設定を日本時間にしていた場合(以下参考)どうなるでしょう。

データビューおよびレポート側では、2026-05-01T10:30:00.000Z を日本時間に直した時間が使われてしまいます。
つまり、日本時間だと 2026年5月1日 19:30 と解釈されます。
何が起きているでしょうか?
元々CSVデータには 2026/05/01 10:30:00 という形で入っており、これは日本時間のつもりだった
↓
AEPに取り込む際に、2026-05-01T10:30:00.000Z という ISO8601形式になり、UTC時間として格納される
↓
データビュー側の表示設定が日本時間(GMT +09:00)の場合、上記をさらに日本時間に変換して解釈する
(2026-05-01T10:30:00.000Z は日本時間だと 2026年5月1日 19:30 になる)
ということで、日本時間の10:30 のつもりで取り込んだのに、レポート上では 19:30 として表示されるということが起きるわけです。
そのため、Data Prep で日本時間の文字列を扱うなら、タイムゾーンを明示的に付ける前提で設計しましょう。
Data Prep 関数で変換できたように見えてもタイムゾーンが抜けていては意図しない挙動になる可能性があります。
取り込み前後で実データを見て、AEP上の値とCJA上の日時が期待通りか確認しましょう。
一例としては、date(concat("2026/05/01 10:30:00", "+09:00"), "yyyy/MM/dd HH:mm:ssXXX") のように、タイムゾーンを文字列として付与した上で date 関数に渡す(ISO8601に変換する)などが考えられます。(concat は文字列を結合する関数)
バッチ処理の「成功」を過信しない
Data Prep にも注意が必要です。
Data Prep でマッピングや変換の途中にエラーが起きても、バッチ全体が必ず失敗するわけではありません。
例えば、ある項目の変換に失敗した場合、その項目は有効な値として取り込まれず、同じ行の他の項目は処理されることがあります。一方で、必須項目が有効な値として残らない、型が合わないなど、その行をXDMスキーマに沿ったデータとして保存できない状態になった場合は、その行自体が取り込まれません。
どちらの場合も、他の行の処理は続きます。
よって、バッチステータスが「成功」だからといって、すべてのレコードが期待通りに取り込まれたとは限らず、Data Prep でエラーを起こしている可能性もあります。
「Data Prep のマッピングエラー」と「データセット自体の取り込みエラー」は別扱いになっているということですね。
CJAで数字が合わないときに、「取り込みは成功しているから実装ではない」と決め打ちせず、Data Prepのマッピングがうまくいっているかどうかも疑ってみましょう。
null、空文字、空配列の扱い
AAでは、空文字や未設定値をあまり深く考えずに送っていたケースもあるかもしれません。
CJAでは、ここが意外と効きます。
AEPのデータセット内部では、null と空文字 "" は異なる状態として保管されます。一方、CJAのマージやレポート上の判定では、どちらも「値なし」として扱われます。
さらに注意したいのが、配列です。
オブジェクト配列のフィールドで、Data Prepなどにより null を除外した結果、空配列 [] として取り込まれることがあります。この場合、CJAからは「フィールドは存在するが、要素数0」という状態に見えます。
この状態は通常の「値なし」とは異なり、レポート行に出てこないことがあります。
例えば、ユーザーの購読中メールカテゴリを配列で持つとします。
1 2 3 4 5 | { "_tenant": { "subscriptions": ["medical_news", "campaign"] }} |
購読がないユーザーを [] にしてしまうと、「購読なし」という状態がレポートで扱いづらくなります。
分析上「未購読」を見たいなら、値を消すのではなく、”未購読” や "none" のような明示的な値として持つ設計が安全です。
「値がない」は、データとして意味がないのか、分析したい状態なのか。ここを先に決めておくことが大事です。
スキーマパスとフィールドグループの落とし穴
XDMには、クラス、スキーマ、フィールドグループ、フィールドという階層があります。
スキーマは複数のフィールドグループから構成され、各フィールドはどこかのフィールドグループに属します。
(フィールドをフィールドグループに属させないことも一応可能です。)
ここでハマりやすいのが、同じスキーマパスでも、フィールドグループが違えば別の定義を持てることです。
同じ _tenant.member.memberId というパスを、あるフィールドグループでは文字列、別のフィールドグループでは数値として定義できてしまう場合があります。
とはいえ、システム上は作れても、データ取り込みやCJA側の解釈では混乱の元になります。
同じ意味のフィールドは、同じフィールドグループを再利用して定義するのが安全です。
スキーマ作成時の「割り当て先」、つまりどのフィールドグループに入れるかを意識します。
↓スキーマの作成画面。各フィールドに「どのフィールドグループに割り当てるか」の設定箇所がある。↓

Adobe Data Collection では非同期処理を待つ実装もできる
Adobe Data Collection(旧Launch)でWeb SDKを実装する場合、すべての計測で非同期処理を待つ必要があるわけではありません。ページ表示時点で必要な値がそろっているなら、そのまま sendEvent すれば十分です。
一方で、CMPの同意状態、会員ID、データレイヤーの準備などを待ってから送信したい場面もあります。
その場合、プロパティ設定で Run rule components in sequence が有効になっていれば、Core の Custom Code ActionでPromiseをreturnして、同じRule内の後続Actionを待たせる実装ができます。

↓Core Custom Code の Action例 (getMemberIdAsyncは別で定義されている前提)↓
1 2 3 4 5 6 7 8 9 10 | return new Promise(function(resolve, reject) { window.getMemberIdAsync() .then(function(memberId) { _satellite.setVar("memberId", memberId); resolve(); }) .catch(function(error) { reject(error); });}); |

このように Promise のインスタンスを return する記述をすると、Promiseが resolve あるいは reject されるまで、後続の Action は実行されません。
ただし、このシーケンス設定が有効な場合、reject やタイムアウトが起きると、同じ Rule内の後続 Actionは処理キューから外れます。もちろん、別のRuleの処理まで止まることはありません。
失敗時に止めるのか、匿名IDだけで送るのか、デフォルト値で送るのか、などは実装ルールとして決めておきたいところです。
↓ Timeoutの設定↓

非同期処理を待つことはできますが、待ちすぎると計測が遅れます。
CJAのために常に待つ、というより、「この値がないとPerson IDや同意状態の設計が崩れる」ような場面だけ、待つ実装を検討するくらいが現実的です。
基本的には『絶対に非同期を待つ実装が必要!』という場合でなければ、使わなくていいくらいの考えで良いと思います。
QAは「ビーコンがとんだ」で終わらせない
Web SDK実装のQAで、Networkタブだけを見て「ビーコンが飛んでいるからOK」とするのは危険です。
(QA:Quality Assurance / 品質保証、ざっくり「動作確認」「テスト」くらいで捉えてもらって大丈夫です)
CJAでは、確認ポイントは以下のように色々とあります。
ブラウザからEdge Networkへpayloadが送られているか
Datastreamで意図したサービスにルーティングされているか
CJAで使う値が、期待通りにXDMフィールドへ入っているか
AEPデータセットに行が入っているか
Data Prepの変換警告や欠損がないか
CJA接続でレコードがスキップされていないか
データビューでコンポーネントとして出ているか
Workspace上で期待した集計になるか
もちろん、全部見られるなら見たほうがいいと思いますが、最終的にレポート上で正しい値が出ていればOKかと思います。
問題は正しい値が出ていない場合に、どこをチェックすればいいかの手札を持っておくことで
その手札として上記のようなポイントが存在する、ということです。
さらに具体的には、例えば見逃しやすいポイントとして、以下のような項目がありそうです。
timestamp がISO8601として正しく入っており、タイムゾーンが付いている
_id が空でなく、サンドボックス全期間で一意になる方針がある
Person IDが空、unknown、大文字小文字揺れになっていない
接続時に、データセット間で、Person IDが同じ人物を表すID体系に揃っている
identityMap のnamespace、primary、authenticatedStateが意図通り
ECIDを手動でハードコードせず、会員IDなど必要な追加IDだけを送っている
ページビューとして数えたいイベントを一貫したルールで送信し、データビューで指標化している
リンククリックのlinkNameが空になっていない
配列の空値が分析から落ちていない([] ではなく明示値)
CVや売上の指標の重複排除を設定している
概要データセットを使う場合は、イベントデータとの結合条件や見せ方を確認している
data オブジェクトを使う場合は、CJAで必要な値がData PrepでXDMへマッピングされている
接続UIの「スキップされたレコード」が増えていない
上記はあくまで、「見逃しやすいポイント」としての紹介です(つまりわりと細かいところの話)。
問題がある場合には大きいところから見るのが鉄板です。(そもそも JavaScript のコードがおかしい、など)
ただ、CJAのQAは、タグのQAというよりデータパイプライン全体のQAであるということは伝えたいです。
移行は「タグの置き換え」ではなく「分析基盤の再設計」
CJA移行で一番避けたいのは、AAの実装をそのままWeb SDKに置き換えて、変数名だけXDMに移すことです。
それでは、CJAのメリットや良さが発揮できません。
まず、AAの現状を棚卸しします。
eVar
prop
event
products
処理ルール
VISTA
分類
マーケティングチャネル
セグメント
計算指標
ダッシュボード
Data Feedや外部連携
次に、CJAでやりたい分析を決めます。
WebとCRMをつなぎたいのか。
店舗購買を含めたいのか。
広告費と売上を同じ画面で見たいのか。
未ログイン行動とログイン後行動を一貫して分析したいのか。
コールセンター接触後のWeb行動を見たいのか。
などなど。
ユースケースが曖昧なままスキーマを作ると、AA変数の写経になりがちです。
ユースケースが決まったら「AEP: XDMスキーマ、データセット」「CJA: データセット、Person ID、接続、データビューの見せ方」を設計します。(あくまで設計です。この段階で実際にデータビューのコンポーネントを作成したりはできません。)その後でWeb SDK実装に入ります。
ここでいう「データビューの設計」は、どのフィールドをディメンションや指標として見せるか、永続性や重複排除をどうするか、といった方針を先に決めるという意味です。
実際にデータビューでコンポーネントを作り、Workspaceで数字を確認するには、接続に対象データセットが入り、少なくとも検証できるデータが見えている必要があります。
順序としては、次の流れが現実的です。
AA資産を棚卸しする
CJAで実現したい分析ユースケースを決める
AEPのXDMスキーマとCJAのデータセット種別(イベント/プロファイル/ルックアップ/概要)を設計する
Person IDとステッチ方針を決める
データビューで作りたいコンポーネントと分析ルールを設計する
サンプルデータをAEPへ入れる(サンプルデータがない場合は、最小限のWeb SDK実装で検証用データを入れる)
CJA接続を作る
データビューで実際のコンポーネントと分析ルールを作る
Workspaceで期待した分析ができるか確認する
Web SDK実装を段階的に展開する
いきなり本番サイトのタグを置き換えるより、まず小さなユースケースでデータモデルから検証する方が安全です。
まとめ
CJAは、AAの画面が少し変わっただけのツールではありません。
AAでレポートスイート、eVar、prop、eventに閉じていた計測を、AEPのXDMスキーマ・データセット、CJAのデータセット・接続・データビューへ分解し直す取り組みです。
うまく設計できれば、CJAはとても柔軟です。
Web、アプリ、CRM、店舗、広告費、コールセンターなどのデータを同じ分析文脈に置けます。
過去データに対して新しい分類を適用したり、複数のアトリビューションやセッション定義を比較したりできます。
一方で、設計責任も増えます。
スキーマの型、_id、timestamp、Person ID、ステッチ、null/空文字、空配列、ルックアップ、指標の重複排除、Datastream、Data Prep、Data Collectionでの非同期処理。
AAでは見えにくかった論点が、CJAでは表に出てきます。
だからこそ、CJA導入で大事なのは、タグを置き換えることではありません。
データアーキテクチャを設計することです。
AA経験者の知識は、CJAでも大きな武器になります。
特に、何を指標にすべきか、何をディメンションにすべきか、どの数字がビジネス上重要か、どこで数字がずれやすいかを知っていることは強いです。
ただし、その知識をそのまま移植するのではなく、AEP/CJAのレイヤーに翻訳する必要があります。
eVar/propをXDMへ、処理ルールを派生フィールドやData Prepへ、分類をルックアップへ、有効期限・配分をデータビューの永続性へ、レポートスイートを接続とデータビューへ。
その翻訳ができると、CJAは単なるAAの後継ではなく、顧客データ分析の土台としてかなり強力な選択肢になります。
以上です。
Bye, bye.