ADK(Agent Development Kit)で始めるマルチエージェント開発①
目次[非表示]
- 1.はじめに
- 2.ADK(Agent Development Kit)とは何か
- 3.ADKの特徴
- 4.なぜマルチエージェントが必要なのか
- 4.1.単一エージェントの限界
- 4.1.1.1. プロンプトが肥大化する
- 4.1.2.2. Tool選択精度が低下する
- 4.1.3.3. Token消費量が増加する
- 4.1.4.4. 再利用性が低い
- 4.2.マルチエージェントのメリット
- 4.2.1.責務分離(Single Responsibility Principle)
- 4.2.2.出力品質が安定する
- 4.2.3.拡張しやすい
- 5.環境構築
- 6.シンプルなAgentを作成する
- 6.1.ディレクトリ構成
- 6.1.1.API Key の設定
- 7.エージェントを起動する
- 7.1.実際にチャットしてみる
- 8.マルチエージェント構成を作る
- 8.1.ディレクトリ構成
- 8.2.モックの検索Toolを作成する
- 8.3.ResearchAgent を作成する
- 8.4.SummaryAgent を作成する
- 8.5.RootAgent(Supervisor)を作成する
- 8.6.マルチエージェントを実際に動かしてみる
- 8.7.注意点
- 9.Sequential構成について
- 10.アンチパターン
- 10.1.❌すべてを1Agentへ詰め込む
- 10.2.❌ Toolを大量に追加する
- 11.動作確認時にチェックした方が良いポイント
- 11.1.1. Agent Routing が正しいか
- 11.2.2. Context が適切に引き継がれているか
- 11.3.3. Tool選択が安定しているか
- 11.4.4. Token消費量
- 11.5.5. Latency
- 11.6.6. Agent責務が曖昧になっていないか
- 11.7.7. Supervisor が肥大化していないか
- 12.まとめ
- 13.次回予告
はじめに
LLM(Large Language Model)の進化により、「エージェント開発」という概念が急速に注目を集めています。
特にここ1年で、
Tool Use
Function Calling
MCP(Model Context Protocol)
Multi Agent
といった概念が急速に発展し、「単なるチャットボット」ではなく、複数の役割を持つAIシステムを構築する流れが強まっています。
しかし実際にエージェントを構築していくと、単一エージェントへ責務を集中させる構成には限界が見えてきます。
例えば以下のような問題です。
プロンプトが肥大化する
Tool選択精度が低下する
エージェントの責務が曖昧になる
出力品質が不安定になる
拡張時の影響範囲が大きい
Token消費量が増加する
特に MCP や Tool を大量に追加した場合、内部的には Tool Description や Function Schema がコンテキストへ追加されていきます。
つまり、
Tool数増加
MCP追加
長大なInstruction
Few-shot増加
などが積み重なることで、システムプロンプト自体が巨大化していきます。
実装によっては、毎回大量のシステムプロンプトを読み込む形になり、
Token消費
Latency増加
推論精度低下
につながるケースもありました。
こうした課題を解決するアプローチとして注目されているのが、マルチエージェントアーキテクチャです。
本記事では、Google の Agent Development Kit(ADK) を利用しながら、マルチエージェント構成の基本と、その設計思想について解説していきます。
ADK(Agent Development Kit)とは何か
ADK(Agent Development Kit)は、Google が提供するエージェント開発フレームワークです。
単なるチャットボットではなく、
というアーキテクチャ設計に重点が置かれている点が特徴です。
ADKの特徴
マルチエージェント前提の設計
Agent単位で責務分離しやすい
Supervisor的な統制構成を作りやすい
Tool / Function Calling と統合しやすい
Google Cloud / Gemini との親和性が高い
LangChain と比較すると、個人的にはかなり思想の違いを感じました。
LangChain は「処理フローをどう構築するか」という印象が強く、Chainベースで流れを設計する感覚があります。
一方 ADK は、
Agent
SubAgent
Sequential Agent
Supervisor
などを組み合わせながら、「Agent中心でシステムを設計する」感覚が強いように感じました。
また、ADKを触っていて特に面白いと感じたのは、エージェントを単体AIではなく、「構成可能なコンポーネント」として扱いやすい点です。
例えば、
単機能Agent
SubAgentとして利用するAgent
複数Agentを統制するAgent
Sequentialに処理を行うAgent
のように、入れ子構造で設計していく感覚があります。
個人的には、単純なチャットボット開発というより、「AIを使ったアプリケーション設計」に近い印象を受けました。
なぜマルチエージェントが必要なのか
単一エージェントの限界
まずは、なぜマルチエージェントが必要なのかを整理します。
単一エージェントへ複数の責務を持たせると、次第に以下の問題が発生します。
1. プロンプトが肥大化する
例えば、
情報収集
SQL生成
データ分析
要約
メール生成
コード生成
などを1つのAgentへ集約すると、Instruction が巨大化していきます。
結果として、「何を優先すべきか」が曖昧になります。
2. Tool選択精度が低下する
利用可能な Tool が増えるほど、LLM 側の選択コストも増加します。
実際に試していても、
不要なToolを呼び出す
本来不要な検索を行う
関係ないToolを利用する
といったケースが発生しやすくなりました。
特に Tool 数が増えると、プロンプト設計依存がかなり強くなる印象があります。
3. Token消費量が増加する
Tool や MCP を追加した場合も、内部的には Description や Schema がコンテキストへ追加されます。
つまり、Tool追加は単純な機能追加ではなく、「毎回読み込むコンテキスト量の増加」でもあります。
そのため、
大量Tool
長大Instruction
MCP追加
などが積み重なると、Token消費量や Latency が大きくなるケースもありました。
4. 再利用性が低い
単一エージェントにすべてを詰め込むと、
他システムで再利用できない
部分差し替えしづらい
テストが困難
といった問題も発生します。
マルチエージェントのメリット
こうした課題に対して、マルチエージェント構成では責務分離が可能になります。
責務分離(Single Responsibility Principle)
例えば、
Agent | 役割 |
ResearchAgent | 情報収集 |
SummaryAgent | 要約 |
SQLAgent | SQL生成 |
AnalysisAgent | データ分析 |
のように分離できます。
個人的には、「1つのエージェントには1つの作業の責任を持たせる」という考え方がかなり重要だと感じています。
出力品質が安定する
各Agentが専門特化することで、Instruction のノイズが減少します。
結果として、
Tool選択
推論精度
出力品質
が安定しやすくなります。
拡張しやすい
例えば、
1 2 3 4 5 6 7 | ResearchAgent↓AnalysisAgent↓ReportAgent↓ReviewAgent(追加) |
のように、後から役割を追加しやすくなります。
環境構築
まずは仮想環境を作成し、ADKをインストールします。
1 2 3 4 | python -m venv .venvsource .venv/Scripts/activatepython -m pip install -U pip setuptools wheelpython -m pip install google-adk |
シンプルなAgentを作成する
まずは単体エージェントを作成します。
ディレクトリ構成
my_agent/
├── .env
└── agent.py
1 2 | # .envGOOGLE_API_KEY="YOUR_API_KEY" |
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | # agent.pyfrom google.adk.agents import Agentroot_agent = Agent( model="gemini-flash-latest", name="root_agent", description="ユーザーの質問に回答するエージェント", instruction=""" あなたはユーザー支援AIです。 ユーザーの質問に対して、 分かりやすく丁寧に回答してください。 """,) |
API Key の設定
.env を作成し、Gemini API Key を設定します。
GOOGLE_API_KEY=”YOUR_API_KEY”
その他のモデル設定については公式ドキュメントを参照してください。
エージェントを起動する
上記作成できたら adk web コマンドを実行してみてください。(myagentフォルダのあるディレクトリで実行)
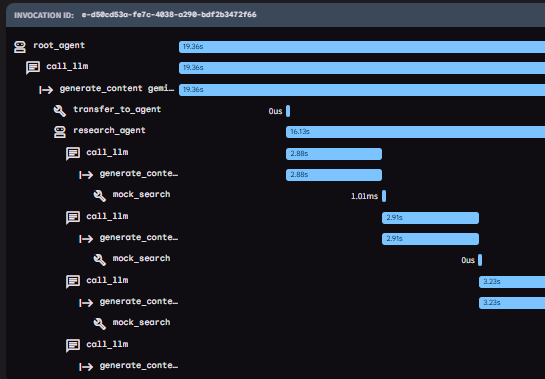
ADK は adk web を利用することで、ローカル Web UI 上で実行できます。
1 | adk web |
実行すると localhost 環境からエージェントの実行を確認できます。
起動後、以下へアクセスします。
1 |

実際にチャットしてみる
例えば以下のような入力を行うと、Agent が応答します。
入力例
1 | こんにちは。自己紹介してください。 |
応答例
1 2 3 | こんにちは!私は、ユーザーの皆様の質問にお答えするエージェントです。日常的な疑問への回答や調べ物、文章の作成、プログラミングの相談など、幅広いトピックについてお手伝いすることができます。何かお役に立てることがあれば、お気軽にお尋ねください。どうぞよろしくお願いいたします。 |

単体Agentの段階では、シンプルなチャットボットとして動作します。
この状態から、
Tool追加
Multi Agent化
Sequential化
などを行いながら、徐々にエージェントシステムへ発展させていきます。
マルチエージェント構成を作る
ここからが本題です。
今回は以下の構成を作成します。
User
 ↓
RootAgent
 ├── ResearchAgent(調査)
 └── SummaryAgent(要約)
単一Agent構成から責務分離を行うため、ここからディレクトリも分割していきます。
ディレクトリ構成
my_agent/
├── .env
├── agent.py
├── agents/
│   ├── research_agent.py
│   └── summary_agent.py
└── tools/
    └── mock_search_tool.py
モックの検索Toolを作成する
今回は外部検索ではなく、動作確認しやすいようにモックの検索Toolを用意します。
ADKでは Python 関数を tools に渡すことで、Agent が呼び出せる Tool として利用できます。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 | # tools/mock_search_tool.pydef mock_search(query: str) -> dict: """ ユーザーの質問に関連する情報を検索するモックツールです。 Args: query: 検索したいキーワードや質問文 Returns: 検索結果を表す辞書 """ return { "query": query, "results": [ { "title": "生成AI市場の拡大", "summary": "企業での生成AI活用が進み、業務効率化やナレッジ活用を目的とした導入が増えています。", }, { "title": "AI Agentへの注目", "summary": "単純なチャットボットだけでなく、複数の処理を自律的に実行するAI Agentへの関心が高まっています。", }, { "title": "業務特化型AIの需要", "summary": "RAGや社内データ連携など、特定業務に特化した生成AI活用が広がっています。", }, ], } |
ResearchAgent を作成する
役割ごとにエージェントを分割します。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | # agents/research_agent.pyfrom google.adk.agents import Agentfrom tools.mock_search_tool import mock_searchresearch_agent = Agent( model="gemini-flash-latest", name="research_agent", description="情報収集を担当するエージェント", instruction=""" あなたはリサーチ担当エージェントです。 ユーザーの質問に対して、 必要に応じて mock_search Tool を使い、情報を整理してください。 以下を重視してください。 - 正確性 - 情報整理 - 重要ポイント抽出 - Toolの検索結果に基づいた回答 出力は箇条書きで整理してください。 """, tools=[mock_search],) |
SummaryAgent を作成する
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 | # agent.pyfrom google.adk.agents import Agentsummary_agent = Agent( model="gemini-flash-latest", name="summary_agent", description="収集した情報を要約するエージェント", instruction=""" あなたは要約担当エージェントです。 research_agent の結果を整理し、 分かりやすく要約してください。 以下の形式で回答してください。 - 結論 - ポイント - 補足 """,) |
RootAgent(Supervisor)を作成する
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | # agent.pyfrom google.adk.agents import Agentsummary_agent = Agent( model="gemini-flash-latest", name="summary_agent", description="収集した情報を要約するエージェント", instruction=""" あなたは要約担当エージェントです。 research_agent の結果を整理し、 分かりやすく要約してください。 以下の形式で回答してください。 - 結論 - ポイント - 補足 """,) |
マルチエージェントを実際に動かしてみる
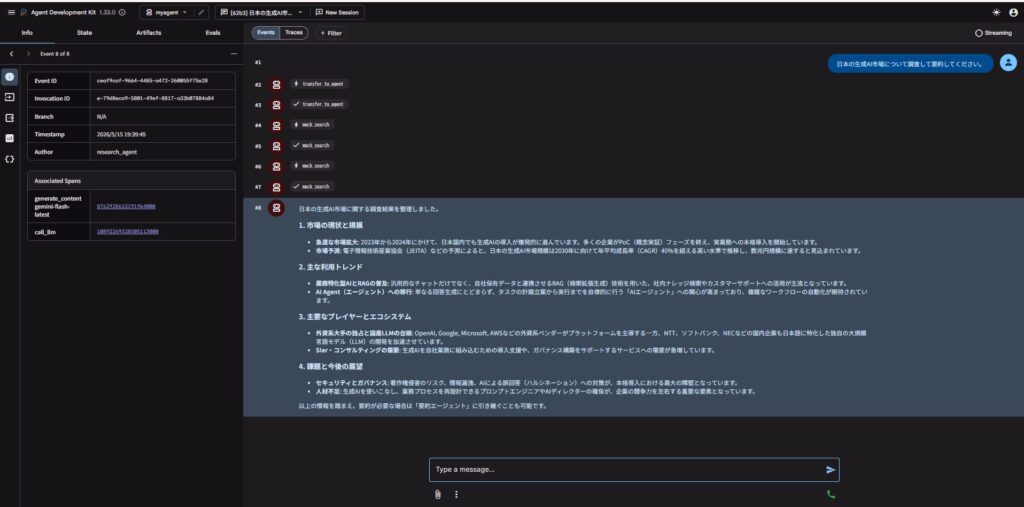
再度 adk web を実行し、localhost からマルチエージェント構成を試してみます。
例えば以下のような入力を行います。
入力例
日本の生成AI市場について調査して要約してください。
応答例
注意点
ここで注意が必要なのは、sub_agents に指定した Agent が必ず順番に実行されるわけではないという点です。
上記例の実行ではSummaryAgentが呼び出されていません。
この構成は、RootAgent がユーザーの依頼内容を判断し、必要に応じて SubAgent へ処理を委譲する構成です。
そのため、質問内容や instruction の書き方によっては、RootAgent 自身が回答を生成する場合もあります。
RootAgent
 ├── ResearchAgent
 └── SummaryAgent
この構成は、厳密な処理順序を定義するというより、
RootAgent が必要に応じて専門Agentへ振り分ける
というイメージに近いです。(今回の構成の場合サマリーとしてエージェントをわける必要がなかったということです。)
そのため、必ず ResearchAgent → SummaryAgent の順番で実行したい場合は、後述する SequentialAgent を利用する方が適しています。
Sequential構成について
実際の業務フローを考えると、完全自律型よりも、
調査⇒分析⇒要約⇒レポート生成
のように、ある程度順序が固定された処理も多いと感じています。
その場合は、RootAgent の LLM 判断に任せるよりも、SequentialAgent を使って処理順序を明示する方が安定します。
ADK では、SequentialAgent を利用することで、指定した SubAgent を順番に実行できます。
例えば、ResearchAgent → SummaryAgent の順に必ず実行したい場合は、以下のような構成になります。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 | # agent.pyfrom google.adk.agents import Agent, SequentialAgentfrom tools.mock_search_tool import mock_searchresearch_agent = Agent( model="gemini-flash-latest", name="research_agent", description="情報収集を担当するエージェント", instruction=""" あなたはリサーチ担当エージェントです。 ユーザーの質問に対して、必要に応じて mock_search Tool を使い、情報を整理してください。 出力は箇条書きで整理してください。 """, tools=[mock_search], output_key="research_result",)summary_agent = Agent( model="gemini-flash-latest", name="summary_agent", description="収集した情報を要約するエージェント", instruction=""" あなたは要約担当エージェントです。 以下の調査結果をもとに、分かりやすく要約してください。 調査結果: {research_result} 出力形式: - 結論 - ポイント - 補足 """,)root_agent = SequentialAgent( name="root_agent", sub_agents=[ research_agent, summary_agent, ],) # 2つのエージェントをリストの順に実行する |
この構成では、RootAgent が判断して委譲するのではなく、
ResearchAgent
↓
SummaryAgent
の順番で処理が進みます。
個人的には、1つの業務フローを実装する場合は、まず Sequential なAgent連携を基本にし、必要に応じて Supervisor 的なAgentを組み合わせる構成が扱いやすいと感じています。
特に、
責務分離
処理順序
Context制御
を行いやすいため、システム全体の見通しが良くなることがあります。(動作の予測もしやすいです)
アンチパターン
❌すべてを1Agentへ詰め込む
責務が曖昧になり、Prompt が肥大化します。
結果として、
Tool選択精度低下
推論不安定化
Token増加
につながります。
❌ Toolを大量に追加する
Tool を増やすほど、LLM の選択コストも増加します。
まずは小さく責務分離する方が安定しやすい印象があります。
動作確認時にチェックした方が良いポイント
マルチエージェント化すると、単体Agentとは異なる確認ポイントが増えます。
1. Agent Routing が正しいか
意図した Agent が呼ばれているか確認します。
例えば、
調査依頼 → research_agent
要約依頼 → summary_agent
となっているか。
2. Context が適切に引き継がれているか
Agent 間で、
情報欠損
要約崩れ
文脈欠落
が発生していないか確認します。
3. Tool選択が安定しているか
Tool を追加した場合、
不要な Tool を呼ばないか
Tool Loop が発生しないか
誤Tool選択しないか
を確認します。
4. Token消費量
マルチAgent化すると、
instruction
tool schema
context
が積み上がるため、Token量を確認した方が良いです。
5. Latency
Sequential構成では Agent数に比例して latency が増加します。
実運用ではかなり重要になります。
6. Agent責務が曖昧になっていないか
Agentを増やしすぎると、今度は
「どのAgentが何を担当するか」
が曖昧になります。
これは通常のシステム設計とかなり似ています。
7. Supervisor が肥大化していないか
RootAgent に責務を集中させすぎると、結局「巨大Agent化」が再発します。
Supervisor は「制御のみ」に集中させるのがよいと思います。
まとめ
本記事では、ADK を利用したマルチエージェント構築の基本を解説しました。
個人的には、ADK は単なるエージェントフレームワークというより、「AIシステムをどう設計するか」を考えやすいフレームワークだと感じています。
特に、
責務分離
Sequential処理
Supervisor
Context管理
などは、従来のアプリケーション設計にかなり近い感覚があります。
エージェント設計では、「AIを賢くする」よりも、「責務をどう分離するか」の方が重要になるケースがかなり多いと感じています。
次回予告
次回以降では以下の内容を扱う予定です。
Tool / Function Calling
MCP
外部API連携
RAG統合
Tool Use と Multi Agent の制約
実際にハマったポイント
より実践的なエージェント設計へ踏み込んでいきます。