Tableauアナリティクスペイン完全攻略 #3 「傾向線」と線形回帰分析 多変量解析の始まり
エクスチュアのシガです。私が幼稚園年少さんのころのクラスは「うさぎ組」でした。もう20年以上前のことですが、ことのほかクラスの名前は覚えているものだなぁと感心しています。あと覚えていることといえば、園でかめを2匹飼っていたことくらいでしょうか。
今回のブログの目的はアナリティクス・ペインにある傾向線モデルについて、その基本的なモデルである「線形」の原理を追いながら理解することが目的です。前回までは、1つの変数についてその特徴を要約するようなモデルについて扱ってきました。今回からは視点を1つ広げます。1変数の中心傾向ではなく、2変数の関係を推定するためのモデルに突入します。Tableauのいう「傾向線」モデルとは、あるところでは「回帰分析」と呼ばれることも多いモデルです。回帰分析(英:Regression Analysis)とは「一方の変数から他方の変数を予測・説明するための分析方法」(豊田2017,p210)のことを言います。
なお、回帰とは、条件付き期待値関数(CEF: Conditional Expectation Function)を求める作業です。CEFとは、ある変数x が与えられたとき、別の変数y の期待値がいくらになるか求める関数です。Tableauの線形モデルは、その複雑な関数を「直線」という最もシンプルな形であると仮定したら、どのような傾きの直線になるかを推定します。
今回扱う回帰分析は理論的に非常に複雑かつ奥深いものです。是非とも冒頭から読んでいただきたいところではありますが、難しいようであれば、うさぎとかめから読んでいただけたらと思います。
目次[非表示]
- 1.「傾向線」モデルのメカニズム:何を計算しているか
- 1.1.「傾向線」、とくに「線形モデル」の正体(OLS)
- 1.2.必要な仮定
- 2.Tableauのトレンドラインを読む
- 2.1.R2R^2とは何か
- 2.2.p値p値とは何か 統計的検定の初歩
- 2.3.機能的な限界
- 3.なぜ「理論なき非線形モデル」を安易に選ぶべきでないのか
- 4.Modern Day うさぎとかめ : Tableau でOLSの理屈を見る
- 4.1.回帰結果
- 4.2.回帰係数と平均変化率
- 4.3.2次項を入れたらどうなるか
- 4.4.残差プロットに現れるOLSの原理
- 5.落とし穴:βを読むときに注意すべきこと
- 5.1.外挿の危険性
- 5.2.予測としてのβvs 因果としてのβ
- 5.3.疑似相関・交絡
- 6.まとめ
- 7.引用文献
「傾向線」モデルのメカニズム:何を計算しているか
「傾向線」、とくに「線形モデル」の正体(OLS)
Tableauのトレンドラインで「線形」を選ぶと、裏では最小二乗法(OLS: Ordinary Least Squares)という分析モデルがデータに当てはめられます。各観測点から予測線までの縦方向の距離(残差 英:Residuals)を2乗して全部足し合わせ、その合計が最小になるように直線の傾きと切片を決める、という方法です。この時、当てはめられるモデルは以下の通りです。
ここで大事なのは、β1\beta_1が「XとYの共分散を、Xの分散で割ったもの」だという点です。感覚的には「Xが動いたとき、Yが平均的にどれだけ動く傾向にあったか」を、全観測点を使って要約した統計量です。
「全観測点を使った」という部分に、あとで効いてくる伏線があります。
必要な仮定
Tabelauが採用しているOLSというモデルが予測する回帰係数が正しいものであるためには、いくつかの仮定が必要です。ここでは細かい証明には立ち入りませんが、理解のためにごく簡単に整理します。
線形性:Yの条件付き期待値が、説明変数と回帰係数を用いた線形モデルとして適切に表現されていること
外生性:説明変数を所与としたとき、誤差項の条件付き期待値がゼロであること
完全多重共線性がないこと:ある説明変数が、ほかの説明変数の完全な線形結合になっていないこと
等分散性:説明変数の値によらず、誤差項の条件付き分散が一定であること
誤差の無相関性:異なる観測間で誤差項が相関していないこと
これらのうち、等分散性や誤差の無相関性は、OLS推定量がほかの線形不偏推定量と比べて最も効率的、すなわちBLUEとなるために重要な仮定です。線形性・外生性・完全多重共線性なしさえ満たされていれば、等分散性や無相関性が破れても回帰係数の推定値自体は不偏です。効率性が落ちるだけで、偏りは生じません。
等分散性や無相関性が破れたときに実際に問題になるのは、通常のOLS標準誤差が不適切になり、t検定・F検定や信頼区間の妥当性が損なわれる点です。
なお、誤差項の正規性はOLS推定量がBLUEとなるための条件ではありません。正規性は、特に標本サイズが小さい場合にt検定やF検定を有限標本で厳密に行うための追加的な仮定です。標本サイズが十分大きければ、中心極限定理により正規性がなくても検定は漸近的に正当化されます。したがって、「残差が正規分布していないから回帰分析そのものが使えない」と考えるのは、CLTが成り立たないほどの小標本の文脈でない限り適切ではありません。
Tableauのトレンドラインを読む
Tableauで散布図にトレンドラインを追加し、ツールチップやトレンドライン記述を開くと、次の情報が出てきます。
– 回帰式
– R2R^2
– p値p値
ここでは、それぞれがどのような統計量であるのかを説明します。なお、散布図の上に線を引くという見た目のせいで、トレンドラインを「相関の可視化」だと捉えたくなってしまう気持ちがありますが、これは似て非なるものです。回帰の傾きβ1\beta_1は単位付き・非対称(XをYで説明するのと、YをXで説明するのは意味が違います)なのに対し、相関係数rは無単位・対称です。
R2R^2とは何か
R²は一般に決定係数と呼ばれたりしますが、次の式のように定義されます。
SSR(残差平方和)は「モデルで説明できなかったばらつき」、SST(全平方和)は「Yそのもののばらつき」です。つまり決定係数は「Yの総ばらつきのうち、モデルが説明できた割合」という当てはまりの指標です。ここで平川(2021)の記述を見てみましょう。
残差2乗和は、回帰直線が完全に当てはまっている場合に0となり、回帰直線が全く当てはまっていない場合に目的変数の偏差2乗和になることがわかります。そこで、残差の二乗和を目的変数の二乗和で割ることで、当てはまりの悪さの指標を構成することができます。そして、この指標を1から引くことで、当てはまりの良さの指標を構成することができます。この指標を決定係数R2R^2といい・・・
ここではよくある誤解を断っておきます。
1つ目は、R2R^2を因果的な説明力だと勘違いすることです。R2R^2が高くても、それはXとYの間に因果関係があることを意味しません。後述する疑似相関の例が典型です。2つ目は、R2R^2を予測性能だと勘違いすることです。訓練データへの当てはまりの良さR2R^2と、未知のデータに対する予測精度は別の話です。
p値p値とは何か 統計的検定の初歩
p値p値を理解するためには、(詳しいロジックは割愛しますが)まず帰無仮説という考え方を知る必要があります。ここでは帰無仮説、p値p値それぞれの定義を確認したうえで、p値p値をどのように扱うべきか解説します。p値p値とは、手元の標本から得られた結果が、偶然のばらつきだけでもどの程度生じ得るのかを判断するための材料です。Tableauの採用する頻度論的な統計学では、まず帰無仮説という基準となる仮説を置き、その仮説と観測されたデータがどの程度両立するかをp値p値によって評価します。
統計的検定ではまず「真値がある値と等しい」という仮説を置き、その仮説と観測されたデータがどの程度両立するかを調べます。このように、「データによって否定されることを通じて、別の仮説の妥当性を示すために置かれる仮説」を帰無仮説と呼びます(浅野・矢内 2018, p148)。回帰分析では、通常、母集団における回帰係数が0であることを帰無仮説とします。つまり、XとYの間に関係がない世界を、検討の出発点として一時的に仮定することを意味します。
このとき、p値は「帰無仮説が真であるときの、得られた標本から計算された検定統計量と等しいか、それより極端な値が得られる確率」(清水 2021, p193)と定義されます。ここでいう検定統計量とは、観測された結果が帰無仮説からどの程度離れているかを、その推定の不確実性も考慮して表した値です。回帰分析では、回帰係数と標準誤差から計算されるt値が用いられます。β^1が0であるとしてtの理論的な標本分布を求め、実際のt値が、その分布内でどれだけ極端であるのかを考えています。
少しかみ砕いて考えてみましょう。仮に、本当の回帰係数が0であっても、標本には偶然のばらつきがあるため、標本から推定した回帰係数β^1が毎回ぴったり0になるわけではありません。ある標本では正の値、別の標本では負の値が得られ、ときには偶然によって0から大きく離れた結果も得られます。p値p値は、回帰係数が本当に0である世界で標本抽出を何度も繰り返したとき、今回観測された結果と同じか、それ以上に0と食い違う結果が得られる割合です。実際には、係数が0からどれだけ離れているかだけでなく、その推定値がどの程度ばらつき得るかも含めた検定統計量によって「極端さ」を評価します。したがって、p値p値が小さいとは、「本当に回帰係数が0であるなら、今回のような結果はあまり得られない」という意味です。
R^2と同様によくある誤解を断っておきます。
1つ目は、p値p値を「帰無仮説が正しい確率」だと勘違いすることです。たとえばp値p値が0.03であっても、「回帰係数が0である確率が3%」という意味ではありません。帰無仮説は現実には正しいか間違っているかのどちらかであり、p値p値はその正しさの確率を計算したものではありません。2つ目は、p値p値を関係の大きさだと勘違いすることです。標本サイズが大きければ、実務上はほとんど意味のない小さな関係でも、小さなp値p値が得られることがあります。反対に、標本サイズが小さければ、比較的大きな係数が推定されても、その不確実性のためにp値p値が小さくならないことがあります。
機能的な限界
Tableauの標準トレンドライン機能は、単回帰(説明変数1つ)にしか対応していません。説明変数を複数扱いたい場合(重回帰)は、TabPyやR連携といった外部エンジンとの接続が必要になります。 このリンクなどが参考になるでしょう。
なぜ「理論なき非線形モデル」を安易に選ぶべきでないのか
Tableauのトレンドラインには、線形以外にも対数・指数・累乗・多項(2次)といった選択肢が並んでいます。これらもすべて強力な分析モデルではありますが、関係の説明や解釈を目的とする場合には、安易に使うことをお勧めしません。非線形モデルを選ぶことでデータへの当てはまりが改善しても、そのぶん係数や限界効果の解釈は複雑になり、関数形を選んだ理由についても説明が求められるからです。
先述した回帰分析の前提が満たされ、標本サイズが十分に大きければ、推定された回帰係数 β^1 は母集団におけるβ1に近づきます。また、 シリーズ前回記事で解説した中心極限定理の考え方によりβ^1の標本分布を正規分布で近似しやすくなり、信頼区間や仮説検定を用いた推測が可能になります。
ただし、これは線形回帰だけの特権ではありません。非線形モデルでも、適切な条件のもとでは同様に区間推定や仮説検定を行えます。線形モデルを最初に選ぶ理由は、非線形モデルでは推測ができないからではなく、モデルの構造が単純で、係数を「Xが1単位増えたときのYの平均的な変化」として一貫して解釈しやすいからです。
特に多項式モデルは注意が必要です。2次項を追加することは、単に線をきれいに曲げるための操作ではありません。「Xの水準によって傾きが変わる」と仮定することであり、転換点が観測範囲内にあれば、関係の方向が途中で反転することまで意味します。
もちろん、非線形モデルは真のデータ生成過程を直接表すためだけでなく、観測範囲内の関係を近似するために使われることもあります。それでも、関係を説明したいのであれば、なぜ限界的な変化が小さくなるのか、なぜ一定の倍率で成長するのか、なぜ途中で傾きが変わるのかを説明できなければなりません。
明確な根拠がない場合には、まず線形モデルを基準として、散布図や残差を確認し、線形では捉えられない系統的な関係があるかを検討することをお勧めします。
非線形モデルを選ぶべきなのは、曲線のほうがきれいに見えるときではなく、その曲線を選ぶ理由を理論とデータの両方から説明できるときです。
Modern Day うさぎとかめ : Tableau でOLSの理屈を見る
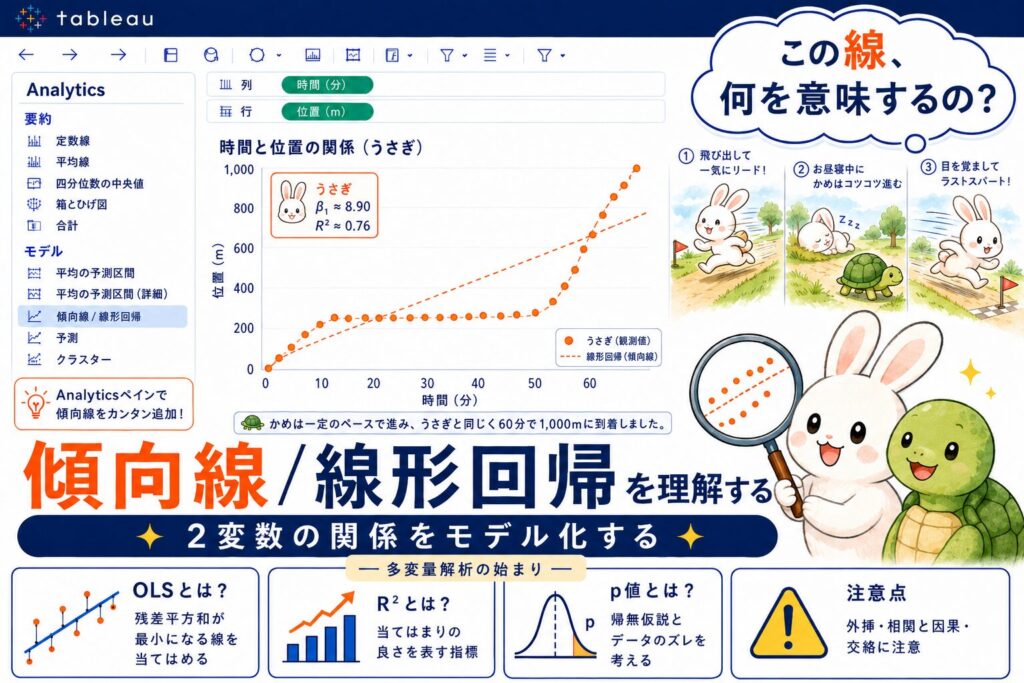
今回のブログでは、ちょっとしたデータ分析の実演を添えてみたいと考えています。今回用意したのはClaudeに用意してもらったうさぎとかめの走行距離ダミーデータです。イソップ寓話のうさぎとかめを、少し改変したものとなります。今回の2人(2匹)は、同じ1000mのコースを、同じ60分かけて、同時にゴールしました。かめは律儀な一定ペース。うさぎは序盤にスパートしたあと、中盤で大きく昼寝をし、終盤に猛烈な追い上げを見せる——という走り方を見せました。
この2人の「時間(分)」と「位置(m)」のペアを、0.25分刻みで記録したデータがあります。これをTableauに読み込んで、時間を横軸、位置を縦軸にプロットし、トレンドラインを引くとどうなるか、これを考えたいと思います。
今回、このダミーデータをTableauで可視化したワークブックを TableauPublicにて公開しています。是非、別ウィンドウで開きながら読んでみてください。
回帰結果
ここからが今回の本題です。冒頭の「1000mを60分で同着ゴール」というデータを、実際にOLSで回帰してみます。
かめの理論上の平均速度は 1000m ÷ 60分 = 16.67 m/分となるはずです。かめのβ1(16.663)はこれとほぼ一致し、R2R^2もほぼ1です。しかし、うさぎも同じ1000mを同じ60分で走りきったのだから、平均速度は同じく16.67 m/分になりそうな気もします。ところが回帰から出てきたβ1は8.897でした。この差はどこから来るのでしょうか。
回帰係数と平均変化率
ここで思い出したいのが、先ほど紹介したβ1を求める式です。β1は「スタート地点とゴール地点だけを見た平均変化率」ではありません。途中の全ての観測点の情報を、共分散という形で織り込んだ数値です。
うさぎの走りには、8〜42分という34分間(全体の過半)の「昼寝」区間があります。この区間では、時間が進んでも位置がほとんど変わりません。「Xが増えてもYが増えない」という情報が大量にデータに存在するわけで、これが共分散を強く押し下げます。結果として、β1が平均速度から大きく下振れしました。
つまり、β1は平均速度の代理変数ではなく、あくまで「線形近似としての傾き」でしかないのです。β1を見て「これがこの区間の平均的な変化率だ」と安心していると、非線形なデータでは足元をすくわれることになってしまいます。
2次項を入れたらどうなるか
「うさぎのデータはS字っぽいから、2次項を足せばよくなるのでは」と考えるのは自然な発想です。試してみます。
うさぎ 線形 R^2: 0.755
うさぎ 2次 R^2: 0.771(ほぼ改善なし)
ほとんど改善していません。理由は単純で、うさぎの動きには「スパート→昼寝→追い上げスパート」という3回のレジーム転換があるのに対し、2次関数は極値が足りないからです。次数を1つ上げただけでは、この構造を捉えきれません。
では、次数をさらに上げればよいのでしょうか。実際、3次関数を使えばR2R^2は改善します。3次関数は、速度がいったん低下したあと再び上昇する形を、2次関数より柔軟に近似できるからです。しかし、当てはまりが改善したことと、適切なモデルを得られたことは同じではありません。3次関数が、うさぎの「序盤のスパート・昼寝・終盤の追い上げ」という行動上の3局面を識別しているわけではありません。異なる局面から生じたデータを、一本の滑らかな曲線で近似しているにすぎません。
うさぎのデータが必要としているのは「なめらかに1回曲がる関数」ではなく、そもそも異なる3つのフェーズを区別するような、まったく別の理論的枠組みです。次数を上げればなんとかなる、という発想自体が的外れだったということです。
残差プロットに現れるOLSの原理
もう一つ、視覚的に分かりやすい確認方法があります。実測値からモデルの予測値を引いた「残差」を、時間軸に沿ってプロットしてみます。
かめ:残差はランダムに、ギザギザと散らばります。残差の累積和もランダムウォークのように上下しながら、最終的には0付近に着地します。これは、正しく仕様されたモデルに典型的なパターンです。
うさぎ:残差が、なだらかな山と谷を描きます。累積和はほぼ正弦波のような形になります。これは偶然のノイズではなく、モデルの関数形そのものが当てはまりが悪いことを示す、構造化されたパターンです。
なお、どちらの残差の合計もきっちりゼロになります。これはOLSの正規方程式から数学的に保証される性質であり、「モデルが良い」ことの証明にはなりません。残差の総和ではなく残差の形を見る必要がある、という点が、このプロットの対比から見えてきます。
落とし穴:βを読むときに注意すべきこと
外挿の危険性
トレンドラインは、観測範囲の外に伸ばして見せることもできますが、これは危険です。うさぎのデータで言えば、42〜60分の追い上げスパートの傾きだけを見て「この調子でずっと伸びる」と外挿すれば、当然ゴール後もあり得ない値まで直線が伸びていきます。回帰は観測された範囲の中でのみ意味を持つ近似であり、範囲の外を保証するものではありません。
予測としてのβvs 因果としてのβ
β1 には2つの読み方があります。
予測としてのβ:「Xの値を知っていれば、Yはこれくらいだろう」という、相関的な読み方
因果としてのβ:「Xを1単位動かせば、Yがβ1だけ変化する」という、介入に基づいた読み方
後者の読み方をするには、2章で挙げた線形性・外生性といった仮定が、単なる統計的な便宜ではなく、現実の因果構造として成立している必要があります。かめの例に限ればで言えば、「時間を1分足せば位置がβ1だけ動く」という解釈自体は成り立ちますが、これはこの実験の性質上たまたま素直なだけです。一般のビジネスデータうさぎのようなデータも存在しえます。この2つの読み方を混同してはいけません。
疑似相関・交絡
最後に、古典的な例を一つだけ。アイスクリームの売上と、水難事故による溺死者数には、強い正の相関があるといわれています。しかしアイスクリームが溺死を引き起こしているわけではありません。両者に共通する原因、気温、が背後に存在し、これが両方を同時に押し上げているだけです。
R2R^2がどれだけ高くても、こうした交絡変数の存在を統計量だけから見抜くことはできません。トレンドラインの式やR2R^2を読む前に、「この2変数の関係を説明できる、もっともらしい第三の変数はないか」を考える習慣をつけるべきでしょう。
まとめ
- Tableauのトレンドラインは、片方の変数でもう一方の変数を説明するモデルをあてはめたものである
- β1は「平均変化率」ではなく、全観測点の情報を織り込んだ統計量である
- 非線形な現実(うさぎの昼寝)は、回帰直線が求める理論値から大きくズレさせる
- 対数・指数・累乗・多項(2次)といったモデル形の選択は、いずれもデータの生成過程についての理論的主張を含んでいる。
- 理論的根拠が薄いときは、まず線形で見る。
- 次数を上げれば当てはまりが良くなるとは限らない。
- データが複数のレジームを持つ場合、必要なのは「もっと曲がる関数」ではなく「別の理論的枠組み」
- 残差プロットは、モデルの仕様が正しいかどうかを視覚的に教えてくれる。
- R2・β1の高さは、因果や予測性能をそのまま保証しない。
- 回帰モデルを使うときは、外挿・因果と相関の混同・交絡変数、という3つの落とし穴を常に意識する。
See you Soon!
シガ
引用文献
平川真. (2021). 直線回帰. 清水裕士(編著), 心理学統計法 (pp. 70–86). 放送大学教育振興会.
清水裕士. (2021). 統計的検定. 清水裕士(編著), 心理学統計法 (pp. 183–200). 放送大学教育振興会.
浅野正彦・矢内勇生. (2018). Rによる計量政治学. オーム社.
豊田秀樹. (2017). 心理統計法―有意性検定からの脱却(新訂). 放送大学教育振興会.