【GTM – dataLayer深掘りシリーズ】第2回:オブジェクト/配列/関数/argumentsの挙動
dataLayer深掘りシリーズ(全4回)
第1回 / 第2回 / 第3回 / 第4回
本稿は第2回です。
第1回では、dataLayer.push() に渡した値が、関数、配列、arguments、それ以外の4系統へ振り分けられるところまで確認しました。
第2回では、その4系統を、実装で使うオブジェクト、配列、関数、arguments の順に1つずつ追います。
なお、本稿でも「辞書側」「木側」という言葉が出てきます。
タグのスクリプト内部にはdataLayerの値を扱う2つの置き場があり、本シリーズでは、キー名をそのまま扱う置き場を「辞書側」、ドットを階層として扱う置き場を「木側」と呼んでいます。詳しい仕組みは第4回で扱いますので、第2回では「内部に2つの置き場がある」とだけ押さえてください。
同じ dataLayer.push() でも、モデルへ値を書くもの、木側の値に対してメソッドを呼ぶもの、関数を実行するもの、gtag() コマンドとして解釈するものに分かれます。
何ができて、どんな書き方では何も起きないのかを、実際の動きと一緒に整理します。
目次
1. オブジェクトを渡したとき
まずは、4種類のうち実装で毎回書いている、最もなじみのあるオブジェクトから見ていきます。
dataLayer.push({ event: 'add_to_cart', value: 1000 });
dataLayer.push({ user_status: 'premium' });
いちばん素直な形なので、特に仕組みを意識せずに書いていると思います。
ここで何が起きているのかを押さえておくと、残り3種類が理解しやすくなるはずです。
1-1. トップレベルのキーが、ひとつずつモデルに書き込まれる
渡したオブジェクトは、トップレベルのキーをひとつずつ取り出してデータモデルへ書き込まれます。push に渡した外側のオブジェクト全体を、1つの追加キーの値として保存するわけではありません。各キーの値自体がオブジェクトや配列なら、その構造は値として扱われます。
dataLayer.push({ event: 'purchase', value: 1000, currency: 'JPY' });
// → event / value / currency の3つが、それぞれ別々に書き込まれる
そのため、GTMのデータレイヤー変数では、value や currency を変数名として直接指定すれば取れます。
また、データレイヤー変数のバージョン2では、「ecommerce の中の items」のような入れ子も、ドットでパスを書けば辿れます(→ 第4回を参照)。
書き込みの実体は、こういう形のループです。
Object.keys(pushed).forEach(function (key) {
  model.set(key, pushed[key]);
});
ひとつだけ例外があります。_clear というキーだけは書き込まれません。これは内部の制御用フラグとして使われます(→ 1-3)。
1-2. event の値が、トリガー評価へ進むかどうかを決める
モデルへ書き込んだあと、トリガー評価へ進むかどうかは event の値で決まります。
渡したもの | データモデル | トリガー評価 |
|---|---|---|
| 書き込まれる | 走る |
| 書き込まれる | 走らない |
| 書き込まれる | 走らない |
正確には、event キーが存在するだけでは足りません。event の値が truthy なら、その値をイベント名としてトリガーが評価され、条件に合ったタグが発火します。空文字、0、null、undefined などの falsy な値ではトリガー評価へ進みません。
実務上は、空ではないイベント名の文字列が入っているかと考えればよいでしょう。
// タグを動かしたい
dataLayer.push({ event: 'add_to_cart', value: 1000 });

// 値だけ先に溜めておきたい(トリガーは動かない)
dataLayer.push({ user_status: 'premium' });
ご存知の方も多いと思いますが、event に空ではないイベント名を入れて push すれば、カスタムイベントのトリガーで利用できます。
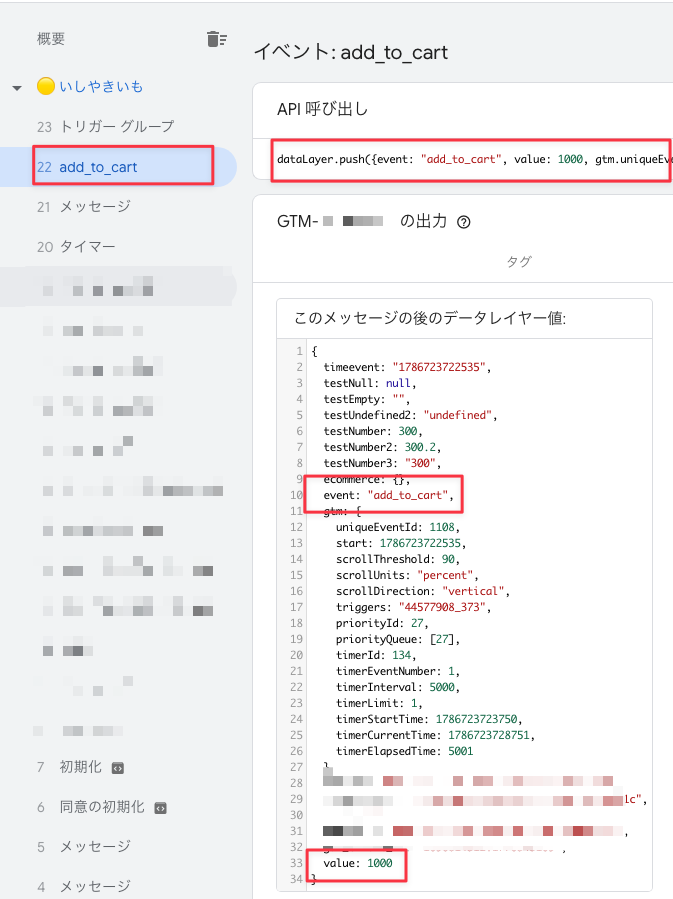
GTMのプレビュー上にもこの event の値が表示されます。
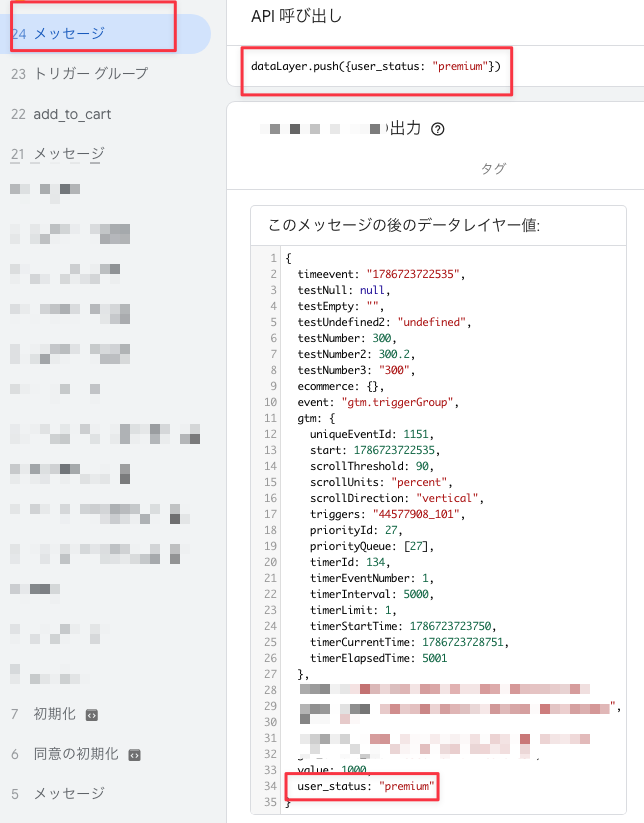
event がない push や、event の値が falsy な push は、GTMプレビュー上では「メッセージ」と表示されます。
ただし、プレビューに「メッセージ」と出ていても、カスタムイベントで「message」などと設定してタグを動かせるわけではありません。トリガー評価へ進む合図は、event に truthy な値が入っていることです。
1-3. 前の値を消したいとき
同じキーに何度も push すると、モデル(木側)の再帰マージによって、前の値の一部が残ることがあります。特に配列が縮まないという現象があり、eコマースで「前に見た商品が混ざる」の原因になります。仕組みは第4回で扱いますが、現象の例と、消し方だけ先に紹介します。
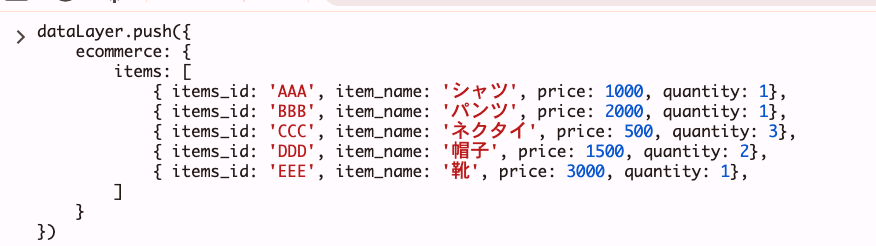
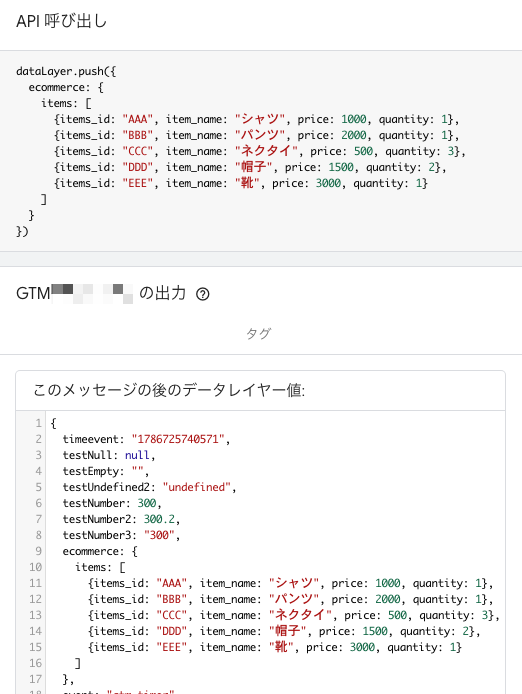
例えば次のようなデータを push します。
dataLayer.push({
    ecommerce: {
        items: [
            { item_id: 'AAA', item_name: 'シャツ', price: 1000, quantity: 1},
            { item_id: 'BBB', item_name: 'パンツ', price: 2000, quantity: 1},
            { item_id: 'CCC', item_name: 'ネクタイ', price: 500, quantity: 3},
            { item_id: 'DDD', item_name: '帽子', price: 1500, quantity: 2},
            { item_id: 'EEE', item_name: '靴', price: 3000, quantity: 1},
        ]
    }
})
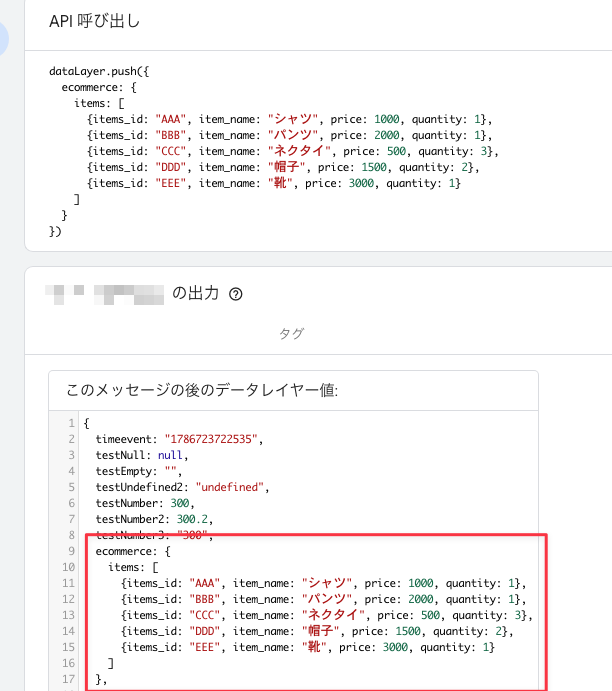
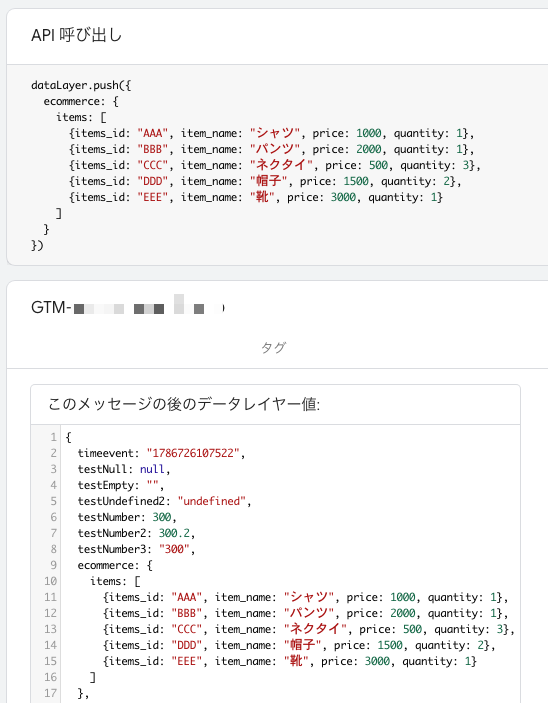
このとき、GTMのプレビューは以下です。
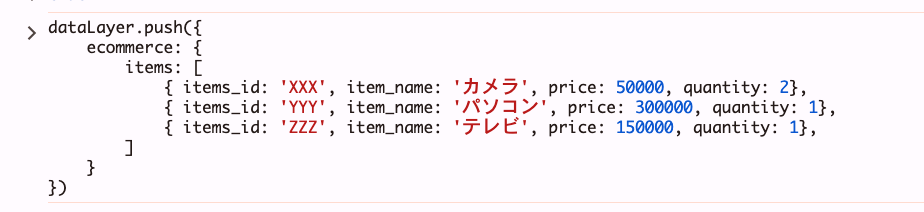
ここに、さらに以下のデータを push します。
dataLayer.push({
    ecommerce: {
        items: [
            { item_id: 'XXX', item_name: 'カメラ', price: 50000, quantity: 2},
            { item_id: 'YYY', item_name: 'パソコン', price: 300000, quantity: 1},
            { item_id: 'ZZZ', item_name: 'テレビ', price: 150000, quantity: 1},
        ]
    }
})
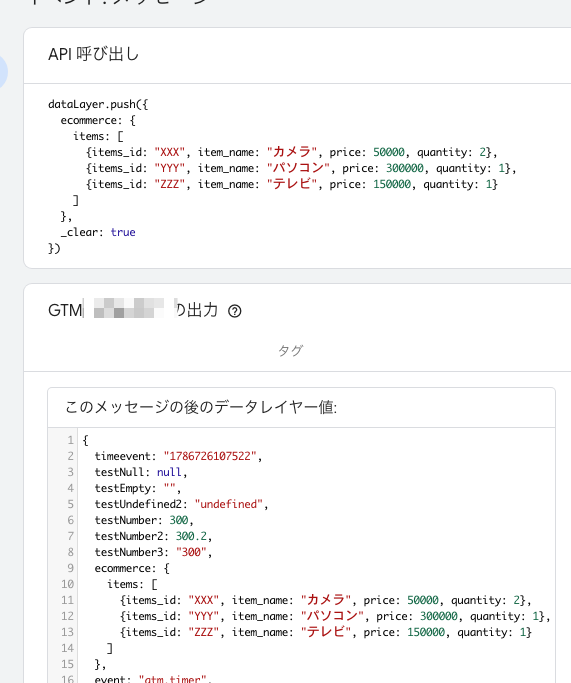
このときGTMのプレビューはどうなるでしょうか・・・?
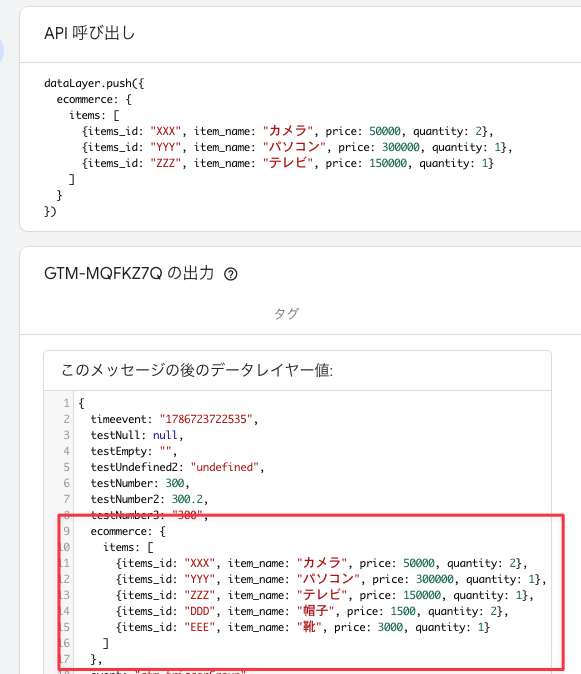
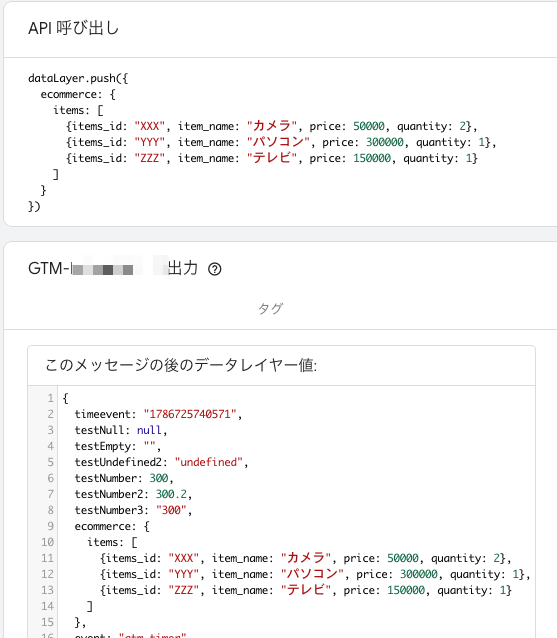
はい、こんな形になっています。
「何が起きているんだ?バグか?」と思うかもしれませんが、バグではなく、仕様です。
つまり、上から3つ目までの商品は上書きされていますが、
4商品目(DDD)と5商品目(EEE)はそのまま残ってしまうわけですね。
実際にコンソールでGTMコンテナが内部に持っているデータモデルを見てみても、このようになっています。
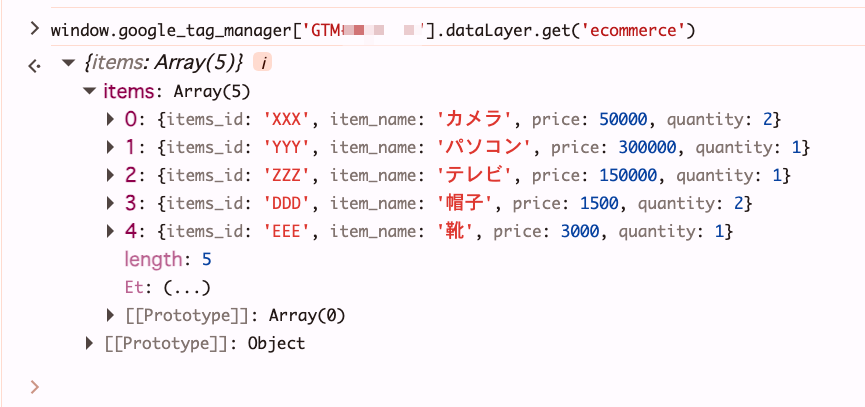
・・・というのが現象の例です。
じゃあどうするかといいますと、以下のような方法が知られています。
// ① 対象キーにいったん null を入れ、その後で新しい値を push する
dataLayer.push({ ecommerce: null });
dataLayer.push({ ecommerce: { items: [商品X] } });

// ② 同じ push の中で、既存値をいったん初期化してから書き直す
dataLayer.push({ ecommerce: { items: [商品X] }, _clear: true });
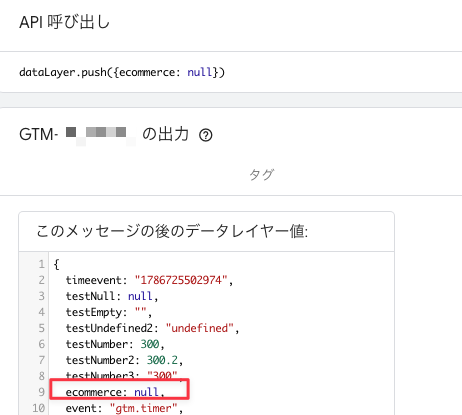
先に対象キーへ null を書くことで、それ以前の値をいったんまっさらにできます。ここで行っているのは dataLayer.push(null) ではなく、ecommerce キーの値として null を渡すことです。
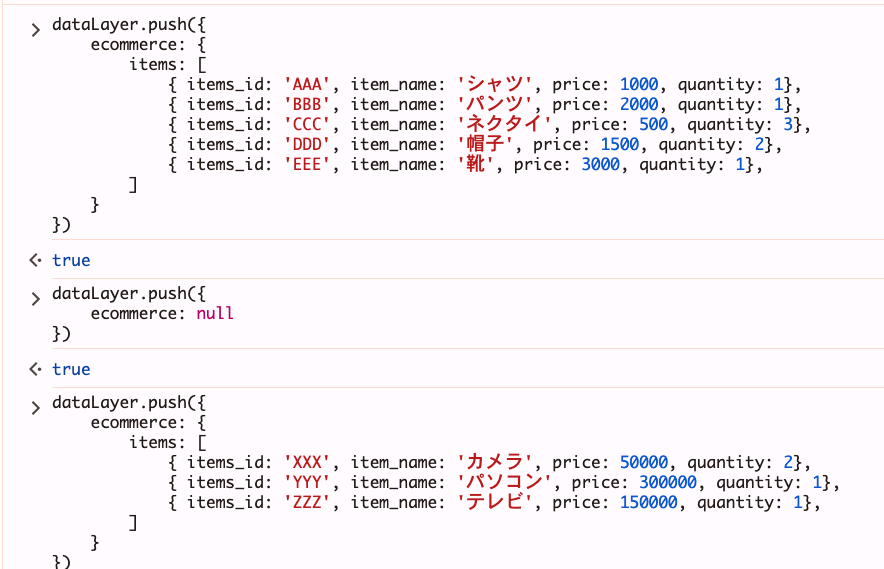
5商品を入れた最初の dataLayer.push
対象キーへ ecommerce: null を入れた push
ecommerce: null のあとに新しい商品を入れた push
という感じです。
もう1つの方法が _clear キーです。これは、null を別の push で入れる処理そのものを自動化したものではありません。_clear の値が truthy のとき(通常は true)、同じオブジェクトに含まれるほかのすべてのキーをいったん undefined にした上で、新しい値をデータモデルへ書き込みます。
dataLayer.push({ ecommerce: { items: [商品X] }, _clear: true }); の例では、ecommerce キーを初期化(正確には undefined)し、その上で、ecommerce に { items: [商品X] } を入れます。
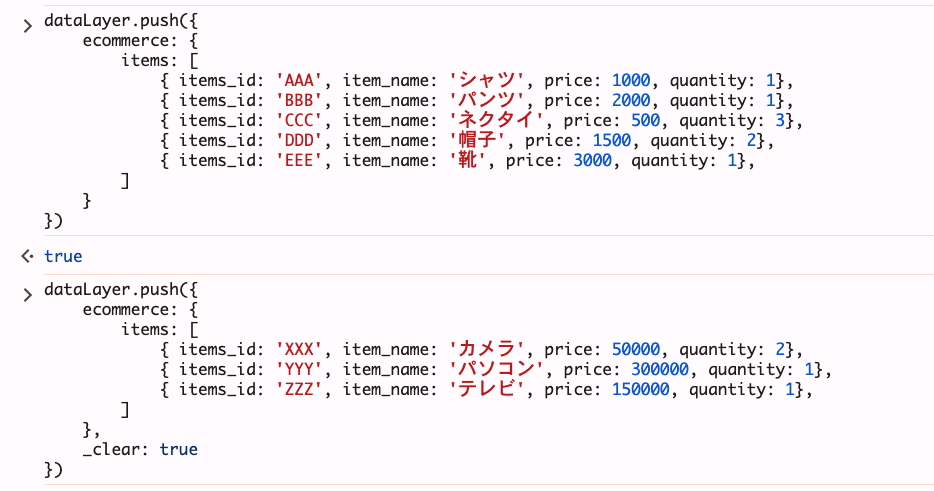
最初の dataLayer.push
_clear を含むオブジェクトを push
という感じですね。
_clear は「消すコマンド」ではない
名前から誤解しやすいので、注意点も記します。
dataLayer.push({ _clear: true }); // ← 内部モデルは変わらない。オブジェクト自体は window.dataLayer に残る単体で渡しても、内部モデルは変わらず、トリガー評価にも進みません。ただし、通常の push と同じく、そのオブジェクト自体は window.dataLayer 配列に残ります。
_clear がやるのは、同じ push に入っているほかのキーについて、既存値とマージせず、いったん初期化してから書き直すことです。「全部消す」ではなく、「この push に含まれるキーは、既存値を引き継がずに書いてくれ」という指定です。
_clear は「消すコマンド」というより、「この push に含まれる値を、既存値とマージせずに書くためのフラグ」です。
ただ、一緒のオブジェクトに入っているすべてのキーについて初期化するので、使い勝手が良いわけではないです。
例えば、dataLayer.push({ ecommerce: {items: []}, hoge: {}, fuga: {}, _clear: true }) のようになっていたら、ecommerce も hoge も fuga も初期化されます。
よって、ecommerce だけを狙って初期化したいのであれば、先に dataLayer.push({ ecommerce: null }) を実行する方が対象を明示できます。
1-4. まとめ
- 渡したオブジェクトは、トップレベルのキーごとにモデルへ書き込まれる
eventの値が truthy なら、トリガー評価へ進む- 「オブジェクトか」という判定はなく、先に除外された関数・配列・
argumentsとnull/undefined以外がこの枝に来る - 前の値を残さず書き直すには、対象キーへ先に
nullを書くか、同じpushに_clear: trueを付ける
2. 配列を渡したとき
次は dataLayer.push() の引数に配列(arguments ではない本物の配列)を渡した場合の話です。
4種類の中でも特に分かりづらいので、順を追って見ていきます。
2-1. 配列は「モデル上のオブジェクトのメソッドを呼ぶ窓口」
配列を渡したときに走るのは、データモデルへのマージではありません。
モデルに入っているオブジェクトのメソッドを、同期的に呼び出すという機構です。
// 配列が渡った際の機構
var path       = pushed[0].split('.');           // "myWidget.open" → ["myWidget","open"]
var methodName = path.pop();                     // "open"
var args       = pushed.slice(1);                // 第2要素以降が引数
var target     = readModel(path.join('.'), TREE_SIDE);  // "myWidget" を木側から取る(→ 第4回を参照)
if (target != null) {
  try { target[methodName].apply(target, args); } catch (ignored) {}
}
やっていることは4段です。
先頭要素をドットで分割し、末尾をメソッド名とみなし、前半をデータモデル上のパスとして解決し、
取れたオブジェクトのそのメソッドを呼びます。
何を言っているのかよく分からないと思いますので、例を示します。
実際の動かし方は二段構えになります。
// ① まず対象をモデルに入れる(素オブジェクト push なので素オブジェクトの枝。event キーが無いのでタグは発火しない)
dataLayer.push({
  myWidget: {
    open: function (id) { console.log('open!', id); },
    value: 42
  }
});

// ② あとから配列でそのメソッドを呼ぶ(配列枝)
dataLayer.push(['myWidget.open', 123]);
// → コンソールに "open! 123"
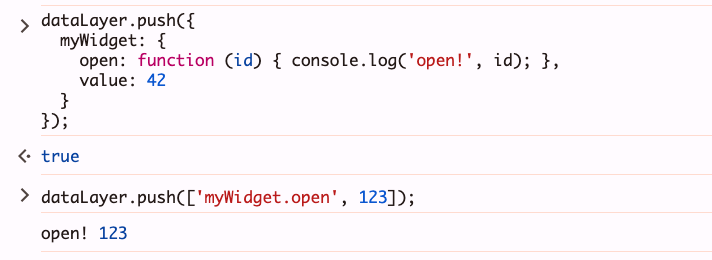
何が起きたかというと、まず普通に dataLayer.push でオブジェクトを push します。
これは普段からよく使う方法です(値として関数を含めることは、あまりないかもしれませんが)。
そして、dataLayer.push に配列が渡ると、第2要素以降はメソッドの引数になります。上の例では 123 です。
第1要素はドットで myWidget と open に分かれ、open がメソッド名、myWidget がメソッドまでのパスとして認識されます。
要するに、myWidget.open(123) のような呼び出しが発生していると思ってください。
2-2. 呼び出される条件は3つ。1つでも欠けると黙って終わる
コードから読み取れる条件はこれだけです。
- 先頭要素が文字列であること
- 前半のパスをモデル(木側)から引いた結果が、
nullでもundefinedでもないこと - 末尾の名前が指しているものが関数であること
3つ揃ったときだけ呼ばれます。
1つでも欠けると、エラーも警告も出ないまま終わります。
ここで重要なのは、前半のパスが空文字かどうかを検査するコードはないことです。
前半が空文字なら、木側の空文字キー '' をそのまま参照します。
通常はそのようなキーを登録していないため undefined になって空振りしますが、「空文字だから即座に拒否される」わけではありません。
例をいくつか並べると次のようになります。
書いたコード | ①先頭が文字列 | ②前半パスが解決 | ③関数になっていて | 結果 |
|---|---|---|---|---|
| ✅ | ✅ | ✅ | 呼ばれる |
| ✅ | ✅ | ✅ | 呼ばれる(何階でも可) |
| ✅ | ✅ | ❌ 42 は関数ではないので呼べない | 空振り(③で脱落) |
| ✅ | ❌ | — | 空振り(②で脱落) |
| ✅ | ❌ 未定義 | — | 空振り(②で脱落) |
| ❌ 先頭が非文字列 | — | — | 空振り(①で脱落) |
呼べる対象は自前で用意した関数だけではない
このメカニズムについて、「あらかじめ自分でメソッド付きのオブジェクトを登録しておいた場合にだけ動く」と整理されることもありますが、そうではないです。
例えば、次のようなものも成り立ちます。
dataLayer.push({ abc: [1, 2] });      // 関数は一切登録していない
dataLayer.push(['abc.push', 4]);      // → モデル側の abc が [1,2,4] になる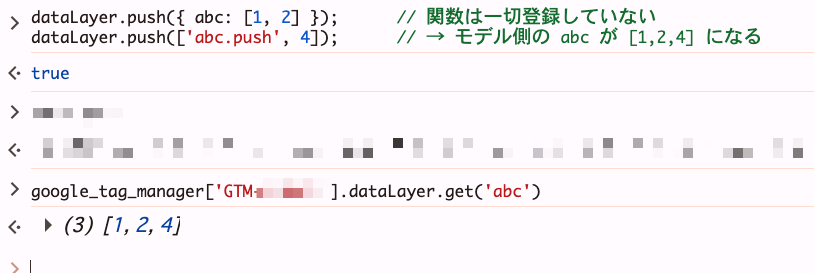
オブジェクト push に含まれる配列は、木側に格納されるときに別の配列が組み立てられます。
その配列も通常のJavaScript配列なので、当然 push や pop などの組み込みメソッドを持っています。
(一方、辞書側は push された元の配列への参照を持ちます。この2つの保持方法の違いは、第4回で実例と一緒に整理します。)
呼び出し部は target[methodName].apply(target, args) を実行するだけなので、メソッドがあれば呼べます。
(上の例では、myWidget['open'].apply(myWidget, args) や abc['push'].apply(abc, args) が実行されるだけ)
そのため、自前で用意したかどうかは関係なく、組み込みメソッドも呼べます。
この変更が届くのは片方だけ
この仕組みで、例えば上の['abc.push', 4] によって書き換わるのは、データモデルが持っている2つの保管庫のうち片方(木側)だけです。
dataLayer.push({ abc: [1, 2] })
    完全一致の辞書側 : [1,2]   ← push した配列リテラルと同一オブジェクト
    階層をたどれる木側 : [1,2]   ← 別に作られたコピー

dataLayer.push(['abc.push', 4])   ← 呼び出しは「階層をたどれる木」側から値を取る
    完全一致の辞書側 : [1,2]        変わらない
    階層をたどれる木側 : [1,2,4]     ★ここだけ変わる
    元の配列リテラル   : [1,2]        変わらない
window.dataLayer を DevTools で開いても、この変化は追えません。元の配列リテラルも変わりません。
「dataLayer を書き換える」という理解は誤りで、書き換わるのは内部モデルの片方(木側)の保管庫だけです。
読み出し経路によって「見える/見えない」が分かれる理由は、第4回で扱います。
通常の書き方では、トップレベルの関数は呼べない
末尾をメソッド名、前半をそれを持つ入れ物とみなす作りなので、通常は、呼ぶ関数は必ずオブジェクトのプロパティである必要があります。
dataLayer.push({ myWidget: function () {} });
dataLayer.push(['myWidget', 123]);   // 空振り。myWidget(123) は呼ばれない
この場合、myWidget は前半パスではなくメソッド名として取り出され、前半パスは空文字になります。
処理はトップレベルの myWidget を直接読むのではなく、木側の空文字キー '' を対象として探します。通常はそのキーがないため空振りします。
実用的には、1階層挟んで {myWidget:{method:fn}} と ['myWidget.method',123] にします。
空文字キーを意図的に用意すれば、ドットのない形でもコード上は呼び出せます。(しかし通常このような設定はしないと思います)
dataLayer.push({
  '': {
    event: function (value) { console.log(value); }
  }
});

dataLayer.push(['event', 'abc']); // → 空文字キーの中の event('abc') メソッドが呼ばれる実用性はほぼありませんが、「ドットのない配列を拒否している」のではなく、通常は空文字キーの対象が見つからないという実装上の違いは押さえておきましょう。
登録より先に呼ぶと、何も起きない
配列メッセージは処理キューへ積まれ、その順番が来た時点で同期実行され、その時点のモデルしか見ません。
同じスクリプトの中で遡って再実行されるといった仕組みはありません。
dataLayer.push(['myWidget.open', 1]);                       // まだ未登録 → 空振り
dataLayer.push({ myWidget: { open: function () {} } });      // 後から登録
// → 1行目が遡って実行されることはない例えば、gtag() のコマンドは、キューに積まれて保持しておいて、本体のロード後に処理されたりしますが、
配列枝はこのコマンドキューには乗りません。
読み込まれているスクリプトの数だけ実行される
これが、実務ではあまり使われない最大の理由です。
配列枝は、処理エンジンの中で直接実行されるため、イベントIDの採番も、宛先ごとのルーティングも、重複排除もありません。
その結果、push を差し替えているタグのスクリプトの数だけ素直に実行されます。
例えば複数のGTMコンテナを読んでいるサイトだったり、GTMは1つでも GA4やGoogle広告を読み込んでいるページなどでは、タグのスクリプトが複数動きます。
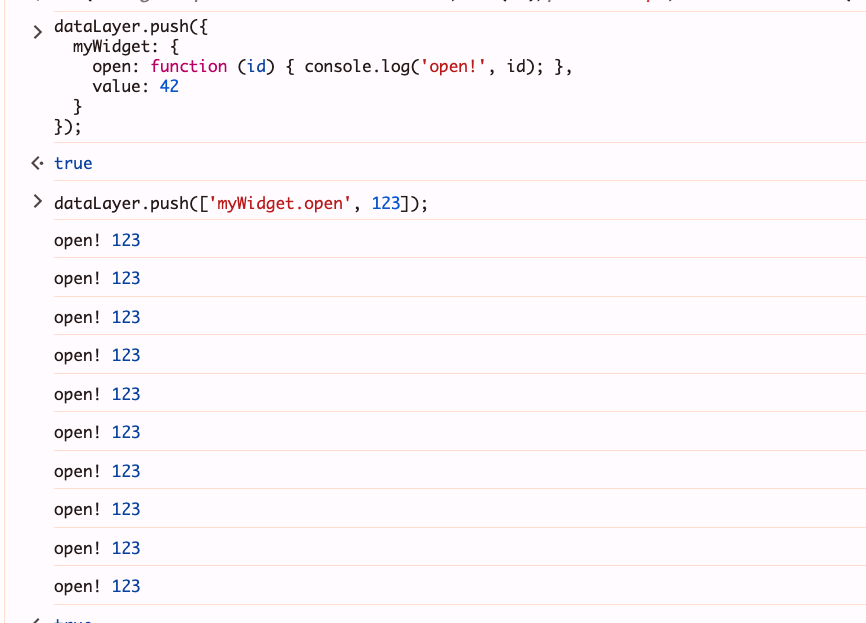
コンテナが2つあれば、1回のpush が2つに配られます。関数内の処理が、console.log のような副作用が気にならないものなら良いですが、API 呼び出しなどが配列枝で起動すると、動いているタグのスクリプトの数だけ実行されます。何回になるかは環境によって変わり、実装時に固定できません。
例えば、以下のサイトの例では、1回動かしただけで、9回も console.log が表示されています。
以上を踏まえると、一般的には、配列枝は実務では使わない方がよい機構です。
保護がなく、失敗が黙殺され、実行回数も環境に依存します。さらに、呼び出したメソッドの戻り値を dataLayer.push() の呼び出し元へ返す経路もありません。
2-3. ドットのない配列は、通常なぜ何も起きないのか
例として、['event', 'add_to_cart'] で追ってみます。
Array.isArrayがtrueなので配列の分岐に入る- 先頭の
eventは文字列なので、条件①は通る 'event'.split('.')は['event']。末尾を取り出す(.pop())と、pathは空配列になるpath.join('.')は空文字。モデルの空文字キーをたどるので、(通常は)undefinedtarget != nullがfalseになり、呼び出しに到達しない
配列枝はコマンドを一切参照しないため、['config', ...] や ['event', ...] と書いても、gtag() のコマンドとしては解釈されません。(本物の gtag() は arguments の分岐にいく)
また、繰り返しですがドットのない形を明示的に拒否しているのではなく、前半パスが '' になり、通常は木側の空文字キーが未登録なので脱落するという流れです。
3. 関数を渡したとき
3つ目の形です。存在自体があまり知られていませんが、公式ドキュメントの「カスタム データレイヤー メソッド」にも掲載されている機能です。
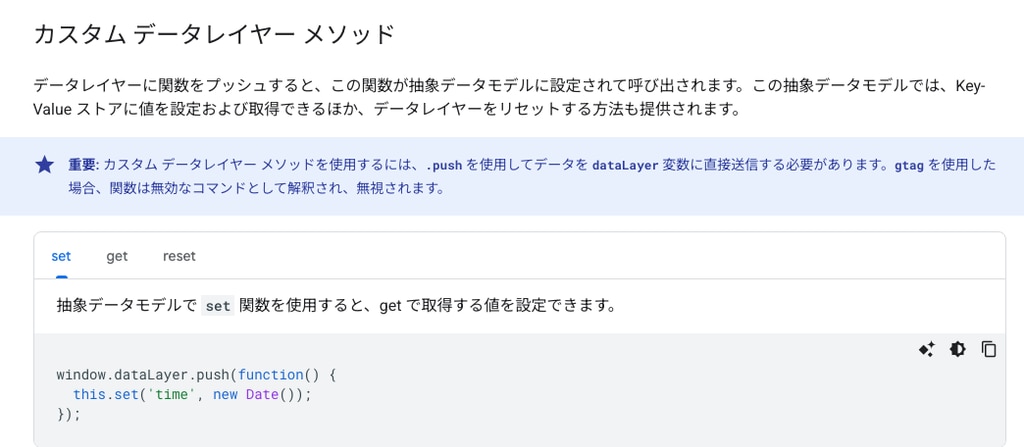
関数を渡すと、処理キューでその順番が来た時点で同期実行されます。そのとき、this に、データモデルを操作するためのオブジェクトが渡されます。
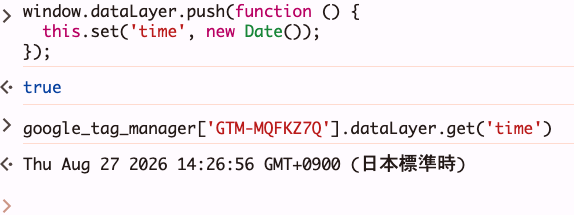
↓this.set() の例↓
window.dataLayer.push(function () {
  this.set('time', new Date());
});
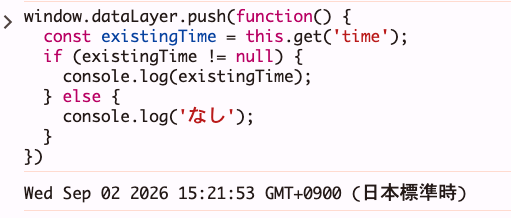
↓this.get() の例↓
window.dataLayer.push(function() {
  const existingTime = this.get('time');
  if (existingTime != null) {
    console.log(existingTime);
  } else {
    console.log('なし');
  }
})
3-1. 使えるのは3つだけ
this が持っているのは次の3つのメソッドだけです。
メソッド | できること | 戻り値 |
|---|---|---|
| モデルに値を書く | なし( |
| モデルから値を読む | 値 |
| モデルを初期化する | なし( |
3-2. 値の取り出しには使いづらい
関数の戻り値は捨てられます。呼び出し側は受け取りません。
// 関数自体は動くが、この書き方では time を取り出せない
var result = dataLayer.push(function () {
  return this.get('time');
});
console.log で表示することはもちろんできます。
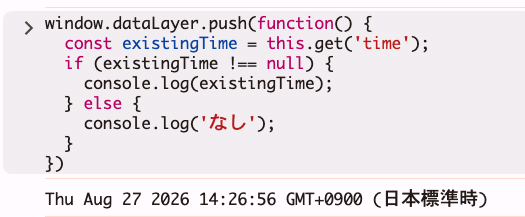
外側の変数に代入すれば取り出せますが、3-3 の実行回数の問題があります。
確実に読みたいなら、名指しで読む方が安全です。
google_tag_manager['G-XXXXXXX'].dataLayer.get('time');
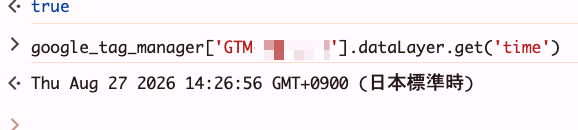
この名指しの get と、関数 push の this.get は、どちらも同じ木側のモデルを読む操作です。
違うのは、名指しの get では、どのIDにひも付いたモデルを読むかを指定できる点です。(上の例では「G-XXXXXXX」を指定して読みにいっています)
3-3. 読み込まれているスクリプトの数だけ実行される
配列枝と同じ問題がここにもあります。
関数は、push を差し替えているスクリプトの数だけ実行されます。
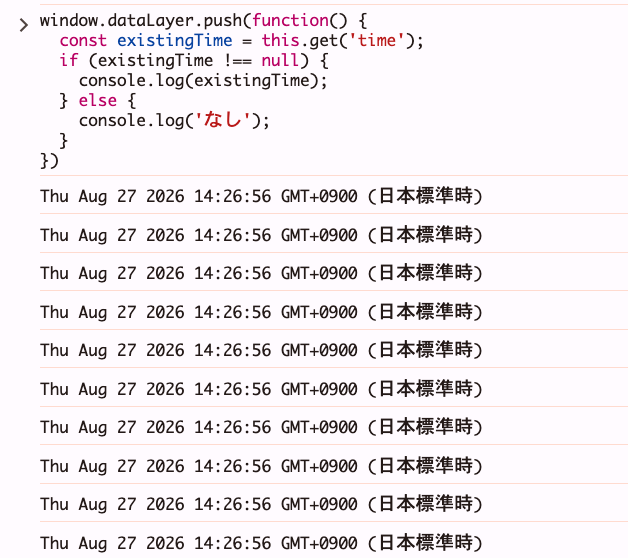
API 呼び出しなどはやらない方がいいでしょう。
// やってはいけない。何回走るかを書いた側から固定できない
dataLayer.push(function () {
  fetch('/api/log', { method: 'POST' });
});
回数を1回に抑えるガードを書くことはできますが、「どのスクリプトのモデルを読んだか」が制御できません。
var done = false;
dataLayer.push(function () {
  if (done) return;
  done = true;
  var v = this.get('hoge');   // 最初に走ったスクリプトのモデルしか読めない
});
3-4. this.set が届く範囲は狭い
this.set は、データモデルが持つ2つの置き場のうち「階層をたどれる木」側にしか書きません(第4回を参照)。
オブジェクトを push した場合は両方に書かれるので、そこが違います。
外部からIDを指定して呼べる get と、バージョン2のデータレイヤー変数は木側を読むので、普段使っている分には差が見えません。差が出るのは、スクリプト自身が辞書側から読んでいる値に対して書こうとしたときです。
// 効かない。許可リストの判定は辞書側を読んでいる
dataLayer.push(function () { this.set('gtm.allowlist', ['google']); });
3-5. this.reset() が消すのは配列ではない
reset() は、2つの置き場(辞書側・木側の両方)を作り直します。個別のキーを消すのではなく、丸ごと捨てて空にします。
window.dataLayer 配列は消えません。DevTools で開けば要素は残ったままです。消えるのはモデル側だけで、これは公式が挙げている「開きっぱなしのページでデータレイヤーが肥大していく」への対処にあたります。
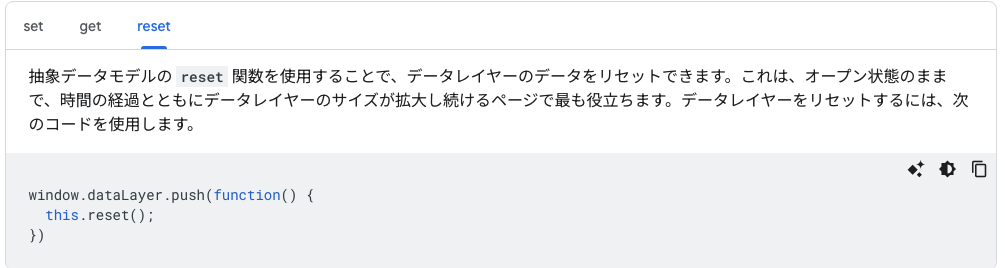
なお、reset もこの push を処理したタグのスクリプトごとに実行され、それぞれが持つモデルを初期化します。
3-6. gtag() 経由では動かない
これも公式が明示的に注意している点です。
重要: カスタム データレイヤー メソッドを使用するには、
.pushを使用してデータをdataLayer変数に直接送信する必要があります。gtagを使用した場合、関数は無効なコマンドとして解釈され、無視されます。
コードで確かめると、理由がはっきりします。gtag(function(){...}) が push するのは関数そのものではなく arguments です。すると型判定は関数枝ではなく、arguments の分岐に落ちます。
ところが arguments は「第1引数が文字列であること」を要求するので、第1引数が関数のこの場合はそこで弾かれて終わります。例外ですらないので、try / catch にも掛かりません。
// 何も起きない。エラーも出ない
gtag(function () { this.set('time', new Date()); });

// 必ずこちら
dataLayer.push(function () { this.set('time', new Date()); });
4. arguments を渡したとき:コマンド表へつながる唯一の経路
gtag() が使っているのがこの形です。
4つの経路のうち、第1引数をコマンド名としてコマンド表を参照するのは、arguments の経路だけです。
arguments だけが通る分岐の中身はこうです。
if (isArguments(pushed)) {
  if (pushed.length && isString(pushed[0])) {
    var handler = commandTable[pushed[0]];        // 'config' / 'event' / 'set' / 'get' / ...
    if (handler && (!context.fromContainerExecution || !restrictedInContainer[pushed[0]])) {
      toMerge = handler(pushed, context);         // ハンドラを実行し、戻り値は合流点へ
    }
  }
}
第1引数の文字列をキーにしてハンドラの表を参照します。
これが、gtag('event', 'purchase', {...}) の第1引数が特別扱いされている仕組みです。
gtag() 自体は dataLayer.push(arguments) の1行しかない投函口で、コマンドの解釈はすべてこの分岐から先で行われます。
ここが、第2回の4経路を比べるうえで最も重要な点です。event や config という文字列自体が常に特別なのではありません。arguments の経路に入ったときだけ、その文字列をコマンド名として表から引くのです。だから gtag() は、配列ではなく arguments を dataLayer.push() へ渡します。
もし、gtag() が dataLayer.push(['event', 'purchase', {...}]) と書かれていたら、配列枝に吸い込まれ、先頭の event はメソッド名、第2要素以降の purchase とオブジェクトはその引数として扱われます。 event の前半パスは空文字になるため、呼び出し対象のオブジェクトを解決できず空振りし、GA4には何も届きません。(2-2の「通常の書き方では、トップレベルの関数は呼べない」の説明と同様)
4-1. 添字と length だけで arguments を模しても通らない
第1回の表を、ここでもう一段詳しく見てみます。
渡したもの | どの枝に入るか | 起きること |
|---|---|---|
| arguments 枝 | コマンド表を引き、コマンドとして処理される |
| 配列枝 | 前半は空文字。通常は木側の空文字キーが未登録なので空振り |
| 素オブジェクト枝 | "0" "1" という名前の変数がモデルに書き込まれる。 |
| 配列枝 | 上と同じく空振り |
判定は [object Arguments] になるか、callee プロパティを自分で持っているかを見ます。オブジェクトリテラルで length と添字を揃えただけでは、この判定は通りません。
ただし callee を足すと通ってしまう
この判定には抜け道があります。callee というキーをもたせるだけで、ただのオブジェクトが arguments として扱われます。
const fake = { 0: 'event', 1: 'purchase',  2: {'send_to': 'G-XXXXX'}, length: 3, callee: function () {} };
// この値は arguments ではない([object Object])が、判定は通る

dataLayer.push(fake);例えば、上記のようなオブジェクトを作ると、dataLayer.push(素のオブジェクト) という形なのですが、arguments 判定されて、普通に GA4にリクエストが飛んだりします。
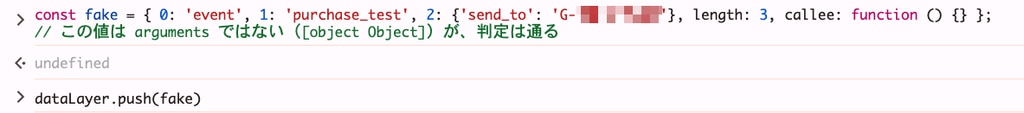
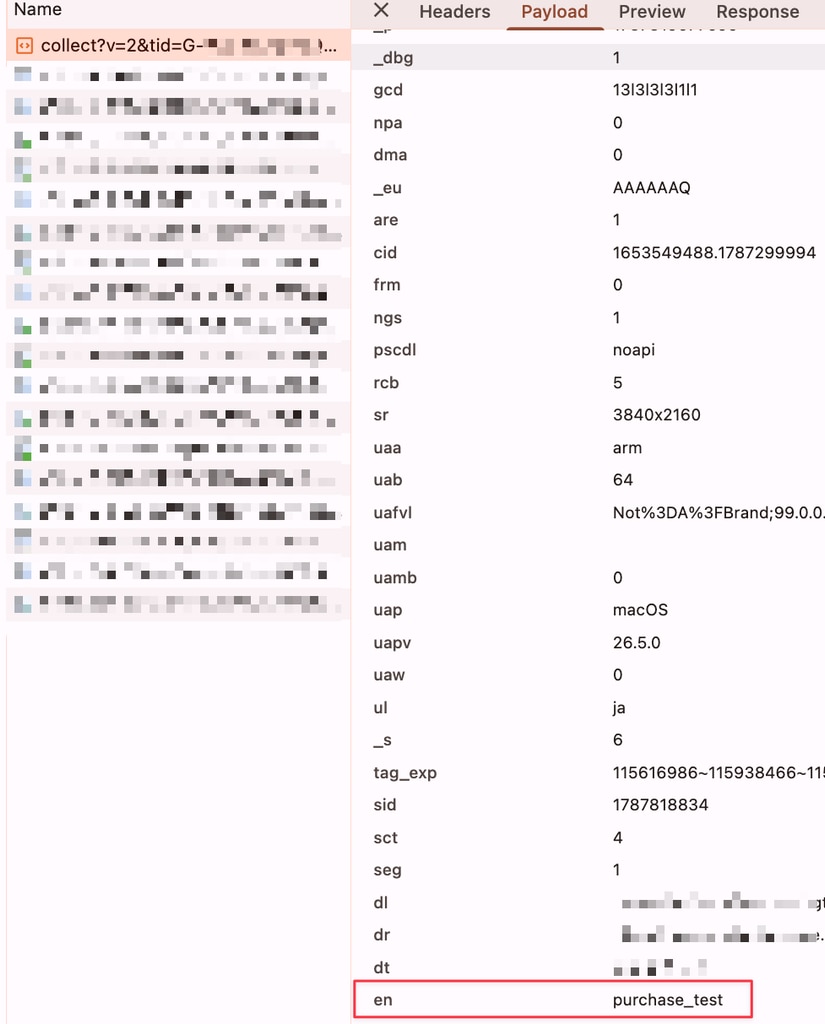
※なお、GTMでGoogleタグを設定している場合は、Googleタグで設定した測定IDは、自動で gtag の宛先にはならないため、send_to を指定する必要があります。
callee を見ている理由は、古い実行環境への対応と推察できます。[object Arguments] を返すと決まったのは ES5 からで、それ以前は [object Object] が返っていました。
そのためこの判定を残しているのかと思われます。
自作の関数からGA4にイベントを送りたい場合、確実な形は「arguments を作る関数を1つ挟む」ことです。
// これは通る(本物の arguments が渡る)
function gtag() { window.dataLayer.push(arguments); }
gtag('event', 'add_to_cart', { 'send_to': 'G-XXXX', value: 1000 });
// これは gtag の event コマンドとしては通らない(配列枝では通常は空振り)
window.dataLayer.push(['event', 'add_to_cart', {  'send_to': 'G-XXXX', value: 1000 }]);
arguments を可変長で組み立てたい場合も、一旦 gtag(...) 形式の関数を経由させれば済みます。apply で引数を展開して呼んだり、スプレッド構文を使えば、受け取った側の arguments は本物になります。
const args = ['event', 'add_to_cart', { 'send_to': 'G-XXXX', value: 1000 }];
gtag.apply(null, args);      // 通る
gtag(...args);  // 通る
4-2. モデルへの書き込みと送信は別
第1回で見たとおり、arguments 分岐のハンドラがオブジェクトを返すと、その戻り値は素オブジェクトと同じ書き込みブロックへ合流します。ただし、合流することと、既存値の更新方法まで同じであることは別です。
gtag('set', 'currency', 'JPY') の結果が GTM プレビューのデータレイヤーに現れるのは、set ハンドラが {currency:'JPY'} に相当するオブジェクトを返しているからです。
(一方で set は上書きモードも指定するため、オブジェクトや配列の更新結果は、通常のオブジェクト push とは異なります(第4回を参照)。)
ただし、モデルに値が書かれたからといって、計測リクエストが送信されたとは限りません。「モデルに書かれること」と「送信されること」は別です。コマンドごとに送る/送らないがどう決まるのかは、第3回で追います。
5. 第2回のまとめ
第2回では、第1回で確認した4つの入口について、分岐したあとに何が起きるのかを追いました。
渡したもの | 行き先 | 主な動作 |
|---|---|---|
素オブジェクト(実用上の「それ以外」) | 合流枝 | トップレベルのキーをモデルへ書き、 |
本物の配列 | 配列枝 |
|
関数 | 関数枝 |
|
| arguments 枝 | 第1引数をコマンド名として表を引く。 |
この表で特に押さえたいのは、コマンド表を参照するのは一番下の arguments 経路だけという点です。ほかの3経路では、event や config と書いてもコマンド名としては解釈されません。
この4つは入れ替えられません。特に、gtag('event', ...) と dataLayer.push(['event', ...]) は、見た目が似ていても別経路です。
null / undefined は手前で除外され、false、0、空文字、NaN なども合流点の truthy 判定を通りません。文字列や truthy な数値は最後の枝へ入りますが、実用的な書き込み形式ではないため、ここでは素オブジェクトを代表として扱いました。
もうひとつ共通するのは、失敗してもほとんど知らせてくれないことです。window.dataLayer に値が残っていることは、コマンドとして解釈された証拠でも、モデルへ届いた証拠でも、送信された証拠でもありません。
次の第3回では、コマンド表へつながる唯一の経路である arguments 枝の先へ進み、gtag() の各コマンドが、送信・設定・読み出しへどう分かれるのかを追います。
そして最終回の第4回では、値が保持される2つの置き場と、書き方によって見える値がずれる理由を取り上げます。
それでは、Bye, bye.