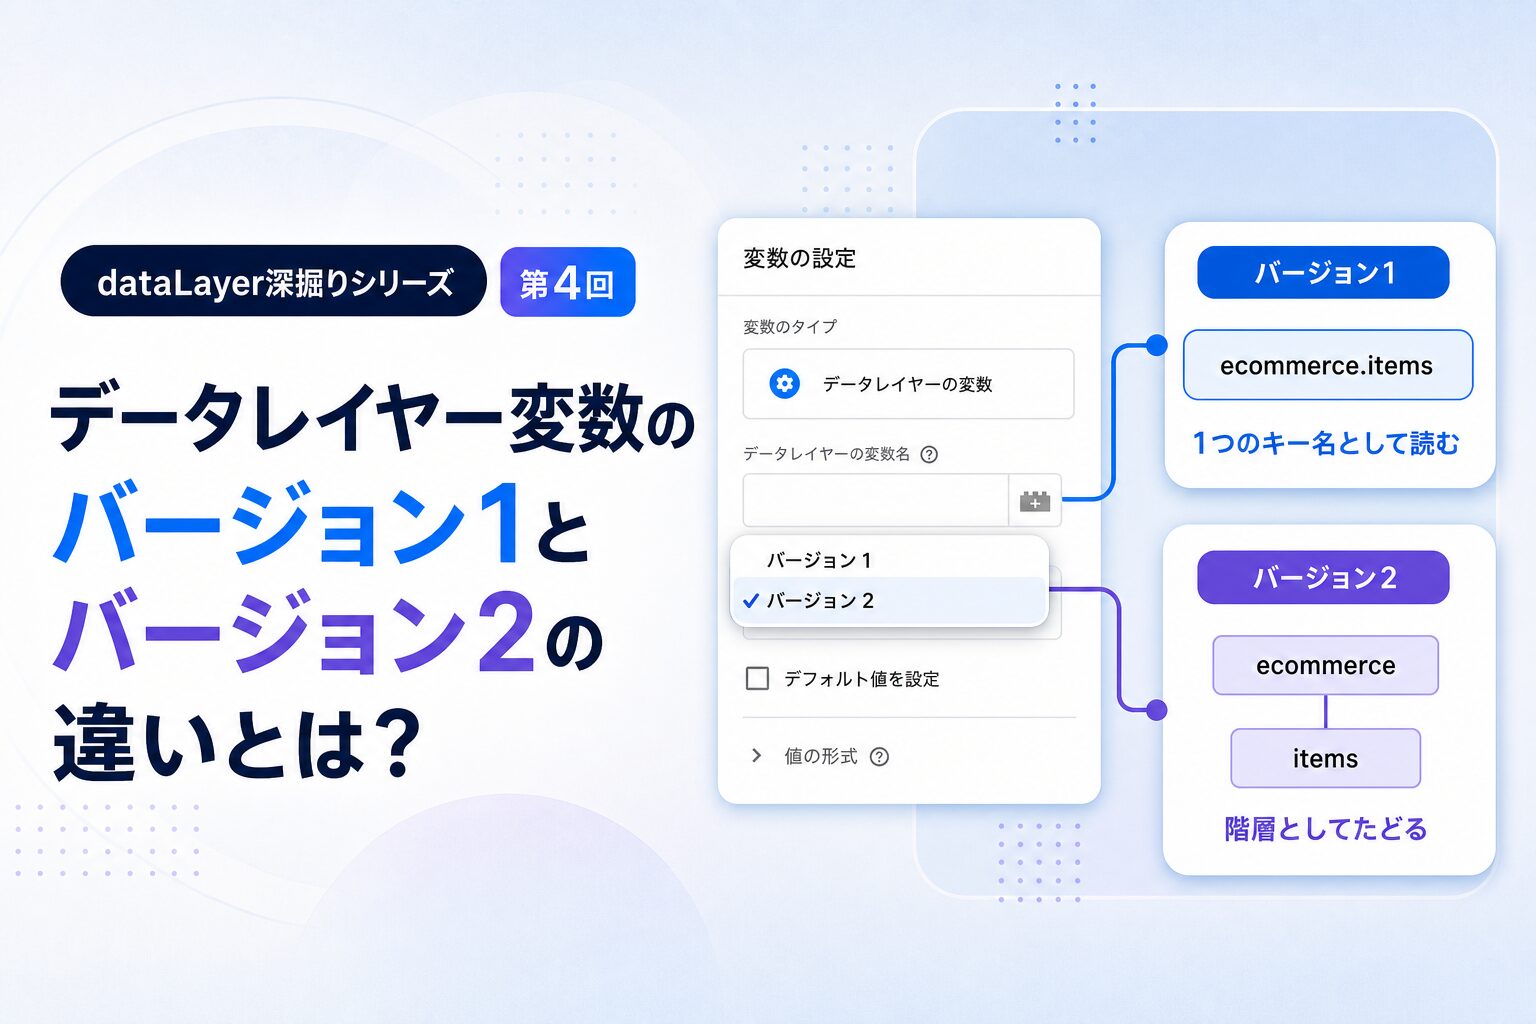
【GTM – dataLayer深掘りシリーズ】第4回:データレイヤー変数のバージョン1とバージョン2の違いとは?
dataLayer深掘りシリーズ(全4回)
第1回 / 第2回 / 第3回 / 第4回
本稿は第4回です。
「GTMプレビューでは正しい値が見えているのに、GA4のリクエストには別の値が入っている」。
dataLayerを調査していると、このような一見矛盾した現象に出会うことがあります。
第3回では、モデルへの書き込みと計測送信が別の段階であることを確認しました。
今回は、そのモデル自体が値をどこに持ち、タグがどこから読むのかを見ていきます。
その理由は、タグのスクリプトが値を1つの形だけで保持しているのではなく、「辞書側」と「木側」の2つの置き場を持ち、読み出し経路によって参照先が変わるからです。
最終回の第4回では、2つの置き場の違い、書き方ごとの更新先とマージ方法、そしてGA4イベントタグがどちらの値を使うのかを、実際のスクショと一緒に整理します。
目次
1. 内部モデルには「辞書側」と「木側」がある
第2回で「書き換わるのは片方の保管庫だけ」と書いていたのは、この2つの置き場のことです。
1-1. 辞書側と木側は何が違うのか
タグのスクリプトは、dataLayerの値を扱うための置き場を内部に2つ持っています。
同じ push から得た値でも、2つの置き場では異なる方法で保存されます。
辞書側は、push したキー名をそのまま鍵にした引き出しです。ドットは名前の一部でしかなく、階層として解釈されません。
木側は、キー名のドットを必ず階層に分解して組み立てた入れ子です。
この違いは、同じ値を2通りの書き方で入れてみると一目で分かります。
次の①と②は連続して実行せず、モデルをリセットしてから、それぞれを個別に実行します。
// ① 入れ子のオブジェクトで渡す(普通はこちら)
dataLayer.push({
    ecommerce: {
        items: ['商品A']
    }
});


// ② キー名にドットを書いて渡す
dataLayer.push({
    'ecommerce.items': ['商品A']
});辞書側でも、ecommerce.items は取れます。ただし、そのキー名でそのまま push した場合だけです。①のように入れ子で渡したものを、辞書側から ecommerce.items で参照することはできません。鍵が ecommerce しかないからです。
一方、木側は、①と②のどちらで書いても同じ入れ子になります。だから ecommerce.items で参照できます。
具体例を見るために、データレイヤー変数を使いましょう。
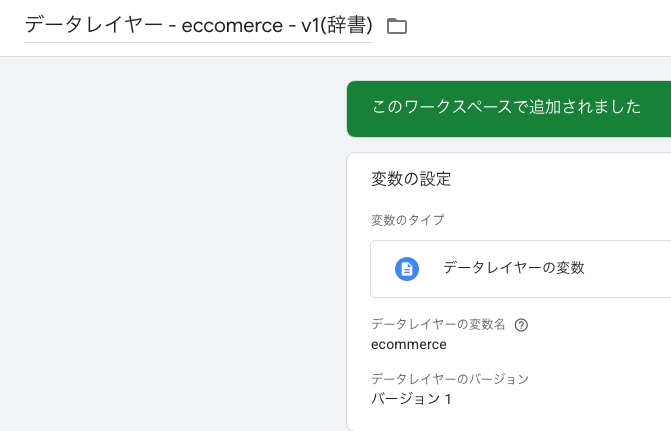
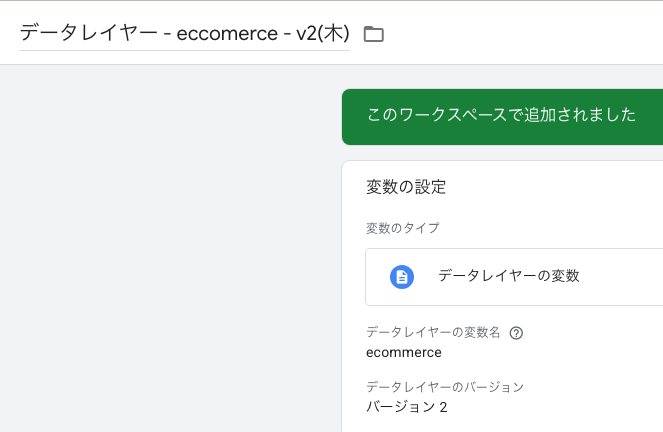
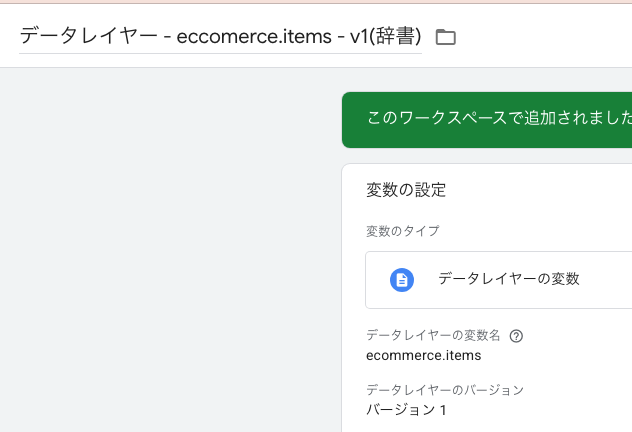
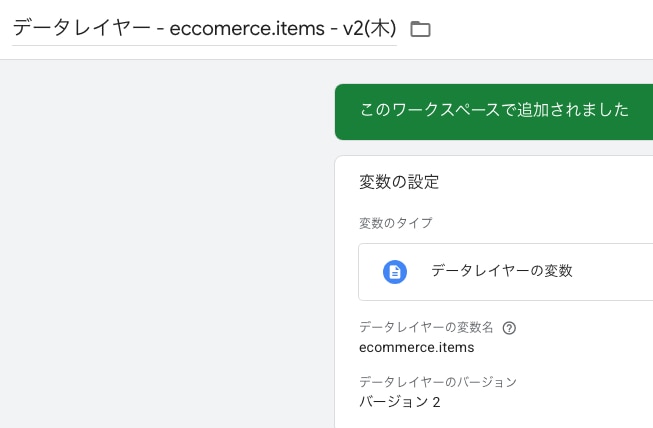
実は、データレイヤー変数の『バージョン1は辞書側』を、『バージョン2は木側』を見ています。
次の4つの変数を作りました。
コンソールで以下を実行。
dataLayer.push({
    ecommerce: {
        items: [
            {
                item_id: 'A',
                item_name: 'Hoge'
            }
        ]
    }
});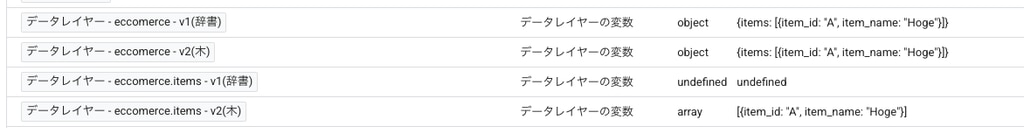
分かるでしょうか?
辞書の ecommerce.items のみ取れていません。
これは、辞書側には ecommerce というキーしか登録されていないため、ecommerce.items では参照できないわけです。
1回リセットして・・・
dataLayer.push(function(){this.reset()});次に、以下を実行
dataLayer.push({
    'ecommerce.items': [
        {
            item_id: 'B',
            item_name: 'Fuga'
        }
    ]
});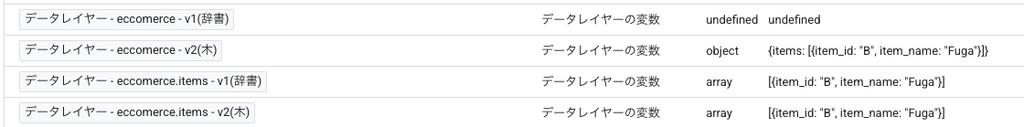
いかがでしょうか?
今度は、辞書の ecommerce が取れていません。
先ほどと同様に、辞書側には ecommerce.items というキーしか登録されていないため、ecommerce では参照できません。
1-2. 値を見る窓口は6つある
整理すると、値を見る窓口はおおよそ次の6つです。
GTMプレビューの「このメッセージの後のデータレイヤー値」と「API 呼び出し」は、次の画面のことです。
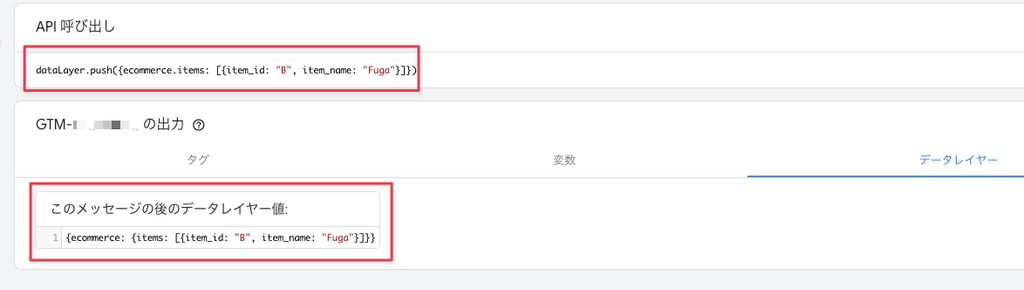
dataLayer.push は ecommerce.items をキーとして渡していますが、
「このメッセージの後のデータレイヤー値」として見えているのは、入れ子の階層構造になっているデータです。
これはまさに木側のモデルを見ているということになります。
同じ ecommerce でも設定や経路によって別の置き場を見ているわけですね。
1-3. なぜ2つに分かれているのか?
値を2種類の構造で持つのは、一見すると無駄です。
しかし、なぜ1つで済ませられないかを考えると、必然性が見えてきます。
(これはGoogleが公言しているわけではなく、筆者の推察ですので、話半分に読んでください)
出発点は、キー名に書かれたドットが2通りに読めてしまうことです。
dataLayer.push({ 'a.b': 1 });    // ① 「a.b」という名前のキー?
dataLayer.push({ a: { b: 1 } }); // ② a の下の b という階層?
ユーザーとしては「どちらも同じでしょ」と思うかもしれません。
実際、木側では同じものになります。
① push({'a.b': 1})   →  木側は {a:{b:1}}
② push({a:{b:1}})    →  木側は {a:{b:1}}      ← 区別が付かない
これは利用者にとっては嬉しい性質です。どちらの書き方をしても {{a.b}} で参照できます。書いた人の流儀を気にしなくてすみます。
ところが、同じ性質が別の場面では困ります。
push({'a.b': '大事な設定'})        ← 設定値を入れる
push({a: '別の誰かが入れた値'})     ← まったく無関係な push

  木側で "a.b" を引く → undefined     消えた
a と a.b は名前として無関係なのに、木側では親子として扱われるので衝突します。1回の push で設定が消えました。
逆に、ドットを解釈しなければこの衝突は起きません。それが辞書側です。ただし今度は、入れ子の中を指せなくなります。
push({ecommerce: {items:[…], currency:'JPY'}})

  辞書側で "ecommerce.currency" を引く → undefined   そんな鍵は無い
木側で "ecommerce.currency" を引く → 'JPY'つまり、「ドットをパスとして解釈する」と「ドットを名前の一部として扱う」は、両立しません。
片方を選べばもう片方を失います。そして、GTMやgtag周りのスクリプトは両方を必要としています。
- 利用者向けには、パスとして解釈してほしい。どう
pushされたのかを気にせずecommerce.itemsなどを引きたい - 自分自身の設定値は、名前として扱ってほしい。例えばGTMが内部的に設定している値などをユーザーが上書きしては困る
1つの構造では両立できないので、両方を持っている。この理由が大きいのかな〜〜と思っています。
そのうえで、それぞれにしかできないことを見ておきます。
木側の強み:別々のキーから1つの値を組み立てる
ecommerce.items と ecommerce.item_list_id を別々のキーで入れました。
それでも、木側の {{ecommerce}} を引くと1つのオブジェクトとして見られます。
dataLayer.push({ 'ecommerce.items': [{ item_id: 'A', item_name: 'Hoge'}]});
dataLayer.push({ 'ecommerce.item_list_id': 'products' });

辞書側には ecommerce というキーでの登録がないので、参照できません。
木はドットを階層に分解するので、誰も push していない親を勝手に作れます。ecommerce.items のような部分パスで引けるのも同じ理屈です。
辞書側の強み:別のキーへの push に巻き込まれない
木は入れ子なので、親のキーに値を1つ書くだけで、その下が丸ごと壊れます。
例えば、GTMが自動生成するオブジェクトに gtm があります。gtm.uniqueEventId などは、GTMのプレビューをよく見ている方だったら、見覚えがあるかもしれません。
例えば、以下では、gtm.uniqueEventId は木も辞書も 1139 となっています。
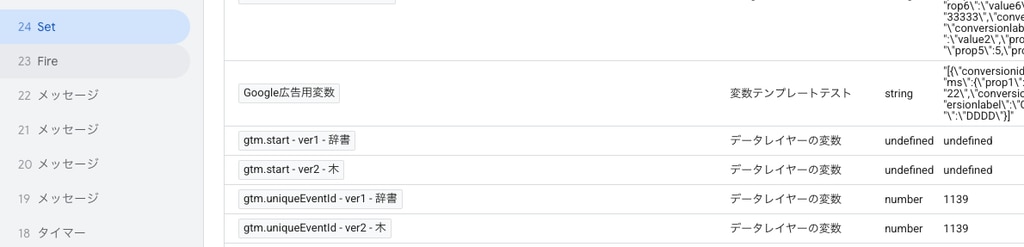
dataLayer.push({gtm: {uniqueEventId: 5000}})を実行するとどうなるでしょうか?
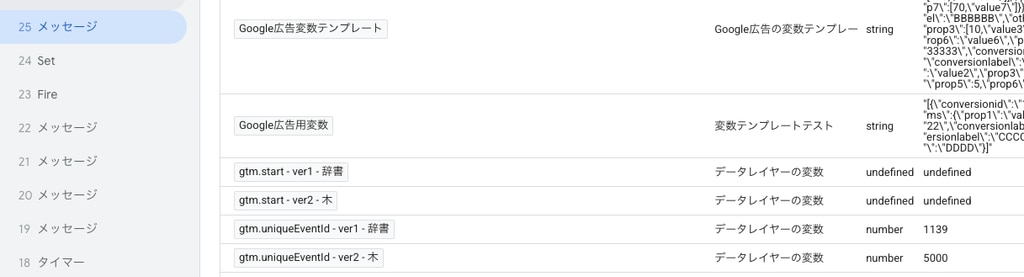
木側は更新されてしまいますが、辞書側は gtm.uniqueEventId というキーで登録したわけではないので、変わっていません。
さらに、例えば、gtm 自体に Hello という文字列を入れてみます。
dataLayer.push({gtm: 'Hello'})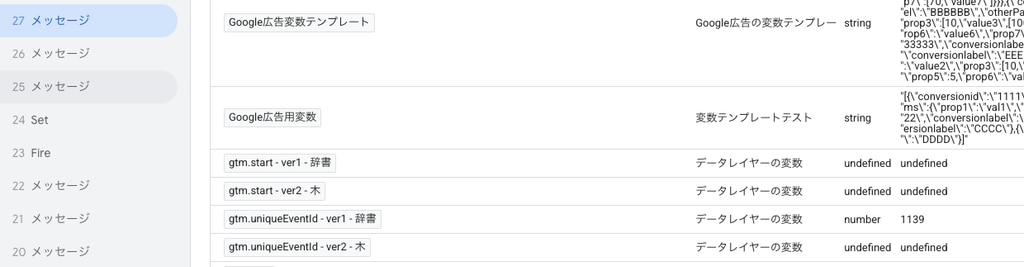
木側は階層が壊れてしまいます。gtm にはただの Hello という文字列しか入ってないため、gtm.uniqueEventId は当然 undefined になります。
一方、辞書側は先ほどと同様の理由で生き残っています。
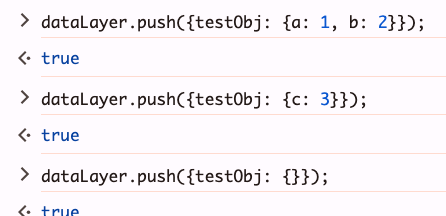
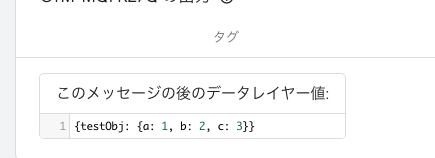
木側は、同じ種類の値を再帰マージする
「木側」のマージの挙動は、特に配列の場合直感に反します。
規則としては以下のようになります。
既存の値と新しい値が同じ種類のときだけ、中身がマージされる。種類が違えば、新しい値で丸ごと置き換わる。
一つずつ見ていきましょう。
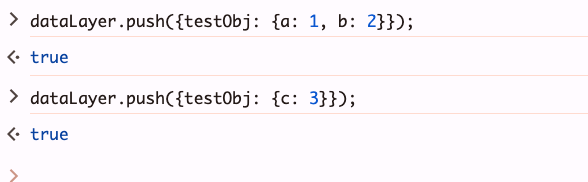
最初の push の後は
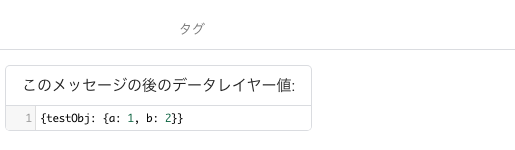
となり、2回目の push 後は
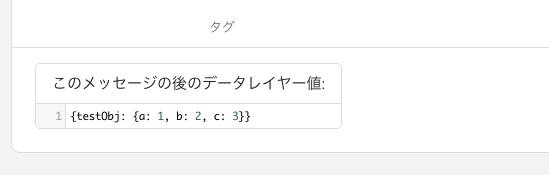
になります。
空のオブジェクトを渡しても、同じ種類かつ足すキーがないので、何も変わりません。
↓変わらない↓
次に配列を見ていきます。
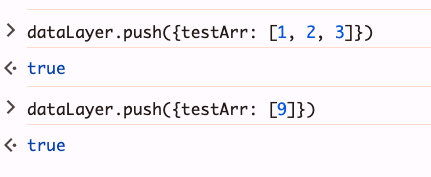
最初の push で
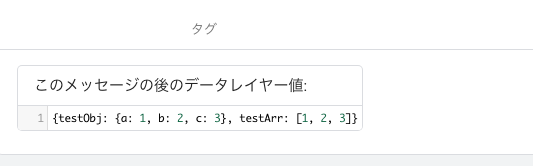
となり、次の push で
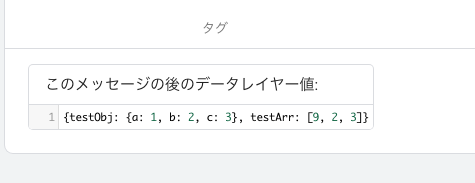
となります。
ここでは、一見すると不思議なことが起きています。[1, 2, 3] のあとに [9] を push したら、[9, 2, 3] になっていますね。
ここで何が起きているかは、4章でもう少し詳しく触れます。
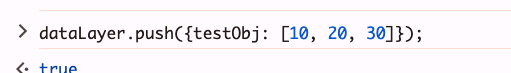
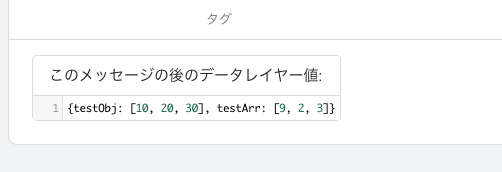
最後に、オブジェクトに対して配列を渡すと完全な置き換えになることを見ます。
(配列ではなく、文字列や数値であっても完全に置き換わります)
辞書側は、そのキーで最後に push された値「そのもの」を持つ
木は過去のマージ結果を返します(上の例でも見ました。4章でも深掘りします)。
辞書は最後に push された値そのものです。
push({ecommerce:{items:[商品A,商品B,商品C]}})
push({ecommerce:{items:[商品X]}})

  辞書側 → {items:[商品X]}                    最後に push したものそのもの
  木側   → {items:[商品X,商品B,商品C]}         過去のマージ結果
実際にオブジェクトと配列の例を見てみましょう。
GTMプレビューの「このメッセージの後のデータレイヤー値」は木側のモデルしか見られないため、
データレイヤー変数のバージョン1(辞書)とバージョン2(木)を使って見比べます。
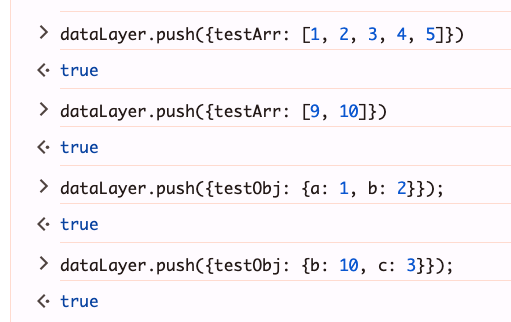
配列・・・

↓↓↓

木側はマージされ、辞書側は「そのとき渡された値そのもの」になっています。
オブジェクト・・・

↓↓↓

同様に、木側はマージされ、辞書側は「そのとき渡された値そのもの」になっています。
どちらも、イベントが変わっただけではリセットされない
誤解されやすいので補足ですが、どちらの置き場も、イベントが変わっても値を保持し続けます。イベント単位でリセットされる仕組みはありません。
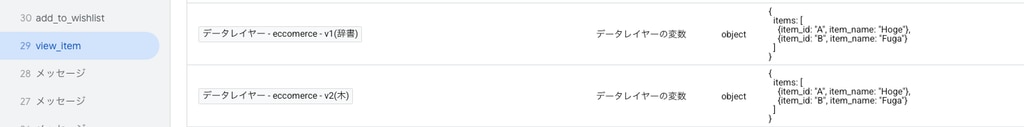
dataLayer.push({
    event: 'view_item',
    ecommerce: {
        items: [
            {
                item_id: 'A',
                item_name: 'Hoge'
            },
            {
                item_id: 'B',
                item_name: 'Fuga'
            },
        ]
    }
})
で push したあとに、同じページで
dataLayer.push({event: 'add_to_wishlist'});としても、ecommerce には触れていないため、値は残ります。
view_item 後↓
add_to_wishlist 後↓
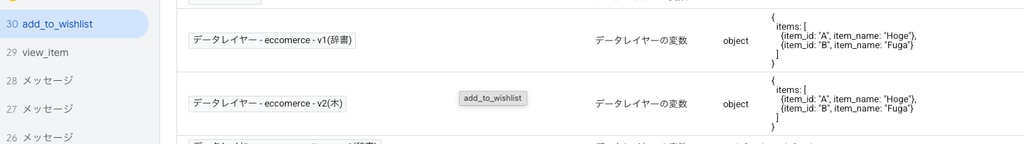
この例で違いが出るのは、同じ要素に push した場合の残り方です。
辞書側は「push したものが丸ごと」
木側は「マージするが、短い配列で上書きすると要素単位で混ざる」
また、dataLayer.push({ ecommerce: null }) を1回挟めば初期化できるのは、辞書側と木側の両方に当てはまります。
1-4. 辞書側と木側の違いをまとめると
片方が「便利」でもう片方が「不便」というわけではありません。
木側の便利さ(書き方を吸収する、階層を辿れる)は、そのまま危うさ(衝突する、古い要素が残る)でもあります。
辞書側の不便さ(ドットを解釈しない)は、そのまま堅牢さ(壊さない)でもあります。
2. push() の引数型によって、モデルへの届き方が違う
ここまでは、辞書側と木側そのものの違いを見てきました。
次に、第1回・第2回で扱った4種類の分岐を、「いつ処理され、どちらの置き場を、どう更新するか」という視点でつなぎ直します。
あわせて、dataLayer.push() に渡す4種類とは別のAPIである google_tag_manager[id].dataLayer.set() も並べます。
素オブジェクトで渡した値の型ごとの違い:
最初の行を、値の型ごとに分けると次のようになります。
木側で再帰マージになるのは、新旧の値がどちらも配列、またはどちらも素オブジェクトの場合です。型が違えば差し替えになります。
ここで辞書側へ保存されるのは、外側のメッセージオブジェクト全体への参照ではありません。処理時に、そこからトップレベルキーごとに取り出した値が保存されます。
例えば dataLayer.push({ count: 1, items: arr }) なら、辞書側は count に数値の 1 を保存し、items には元の配列 arr への参照を保存します。
さて、引数が素オブジェクトの通常の push、関数内の this.set()、google_tag_manager[id].dataLayer.set() は、木側へ値を入れる最後の段階では同じ set と再帰マージの規則を使います。違うのは、そこへ到達するタイミングと、辞書側への書き込みやトリガー評価も伴うかどうかです。
一方、gtag('set') は同じ規則でそのままマージするのではなく、コマンドハンドラが上書き指定を立て、対象キーをいったん消してから共通の書き込みへ進みます。また、gtag('set') は木側だけでなく、辞書側も書き換えます。
違いが分かるように、同じ初期状態の同じキーへ、同じ更新値を渡した場合を比較します。
次のAとBは同じページで続けて実行するコードではありません。ページを読み直すなどして、それぞれ同じ初期状態から実行する独立した検証です。
A. google_tag_manager[id].dataLayer.set() と this.set()
dataLayer.push({ testObj: { a: 1, b: 2 }, testArr: [1, 2, 3] });

google_tag_manager[id].dataLayer.set('testObj', { c: 3 });
// 対象IDの木側: { a: 1, b: 2, c: 3 }
// 対象IDの辞書側: {a: 1, b: 2} ※変更なし

dataLayer.push(function () {
  this.set('testArr', [9]);
});
// この関数を処理した各スクリプトの木側: [9, 2, 3]
// この関数を処理した各スクリプトの辞書側: [1, 2, 3] ※変更なし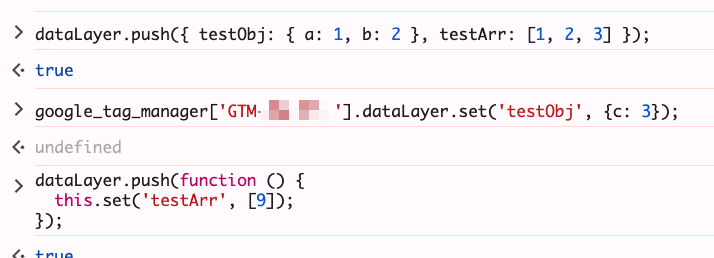
↓google_tag_manager[id].dataLayer.set('testObj', { c: 3 }); 実行後↓

↓↓ dataLayer.push 実行後↓↓

木側だけ更新し、キー/添字を見て上書き更新(再帰マージ)になります。(第2回参照)
辞書側には影響しません。
B. gtag('set')
dataLayer.push({ testObj: { a: 1, b: 2 }, testArr: [1, 2, 3] });

 gtag('set', 'testObj', {c: 3})
// 木側・辞書側:{c: 3}

gtag('set', 'testArr', [9])
// 木側・辞書側:[9] 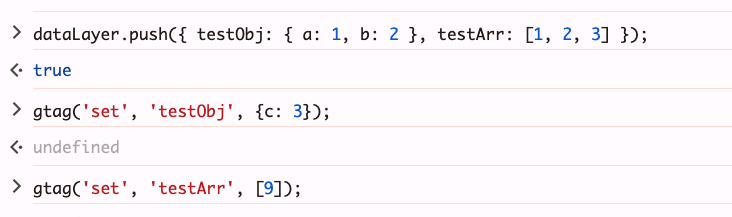
↓gtag('set', 'testObj', {c: 3}) 実行後↓

↓↓ gtag('set', 'testArr', [9]) 実行後↓↓

こちらは各コマンドで対象キーをいったん消してから書くため、既存の a・b や配列の後続要素は残りません。
つまり、渡している更新値はAとBで同じですが、通常の set() は既存値へ再帰マージし、gtag('set') は対象キーを消してから書くという違いが、そのまま結果に現れます。
また、引数が配列の配列枝については、それ自身に「木側へ書く」処理があるわけではありません。木側から取った値のメソッドを呼ぶだけです。
関数枝も同様に、それ自体は書き込みません。this.set() は木側だけ、this.reset() は辞書側と木側の両方を作り直します。
2-1. 配列枝の変更が木側だけに現れる実例
最初に素オブジェクトで配列を入れ、次に配列枝からその push() メソッドを呼びます。
// ① 素オブジェクトなので、testArr は辞書側と木側の両方へ入る
dataLayer.push({ testArr: [1, 2] });

// ② 配列枝。木側の testArr を取得し、その Array#push を呼ぶ
dataLayer.push(['testArr.push', 3]);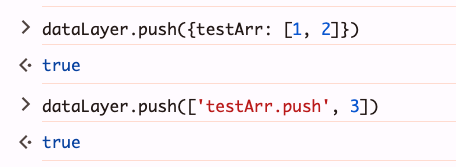
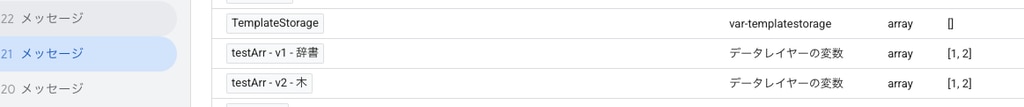
↓↓①のあとのGTMプレビュー↓↓
↓↓②のあとのGTMプレビュー↓↓
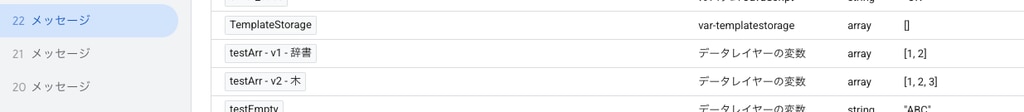
辞書側の値には何の影響もなく、木側の値だけが変更されています。
①を処理した時点では、辞書側は push された配列への参照を持ち、木側には別の配列が組み立てられます。
②で取り出されるのは木側の別配列なので、3 が増えるのは木側だけになります。
つまり、これは「②が木側へ 3 を書いた」というより、木側から取得した配列へ push() を実行した結果になります。
2-2. Push した元の配列/オブジェクトを後から変更した場合
上で書いた表をもう一度再掲します。
これを見ると、通常の素オブジェクトを dataLayer.push() した際に、値が配列やオブジェクトの場合は、辞書側は元の変数の参照を保持することになります。つまり、後から元の変数を変更すると、辞書側から見える値も変わります。
(mutable な値を破壊的に変更した場合)
次の例では、testArr の値が配列の original なので、辞書側は original への参照を保存します。その後で参照先の original の中身を変更すると、辞書側から見える値も変わります
const original = [1, 2, 3, 4];
dataLayer.push({ testArr: original });

original.push(100, 200);

// 辞書側(バージョン1): [1, 2, 3, 4, 100, 200]
// 木側(バージョン2): [ 1, 2, 3, 4 ]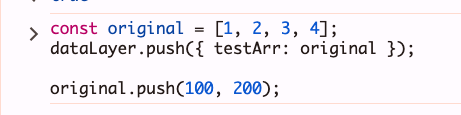
dataLayer.push({ testArr: original }); の後↓

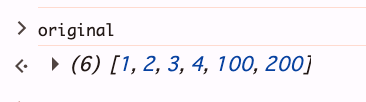
元の変数に対して、original.push(100, 200) をする
original の配列の中身は当然 [1, 2, 3, 4, 100, 200]
では、データレイヤー変数の値はどうなっているでしょうか。

辞書側は、トップレベルの testArr へ渡された original の参照をそのまま保存します。
そのため、original の配列の中身を変更したものが辞書側のデータレイヤー変数にも反映されます。
一方、この例のような素のオブジェクト/配列では、木側は構造化する過程で別のオブジェクト・配列を組み立てるため、後から original を触っても追従しません。
逆に、この例のように木側が別実体を持つ配列/素オブジェクトでは、google_tag_manager[id].dataLayer.get() の戻り値や配列ドットコマンドで、木側の実体を変更しても、辞書側の元オブジェクトには届きません。
なお、「元の値を変更しても木側には反映されない」「木側を変更しても辞書側には反映されない」という両方の説明で、Date・関数・正規表現・クラスインスタンスなどは例外です。これらは上記の表の通り、元の値・辞書側・木側が同じ実体を参照しているため、その中身を変更すると、両側から見える値も変わります。
例えば、以下のようにクラスインスタンスを渡した場合・・・元のインスタンスを変更したら、辞書側も木側も変更されます。
class Test{
    constructor(){
        this.name = 'test';
        this.age = 29;
    }

    info(){
        console.log(`${this.name}さんは${this.age}歳です`);
    }
}

// インスタンス化
t = new Test();

// Push
dataLayer.push({
    testObj: t
});

// 大元のインスタンス(t)を変更
t.name = 'Taro';
t.age = 45;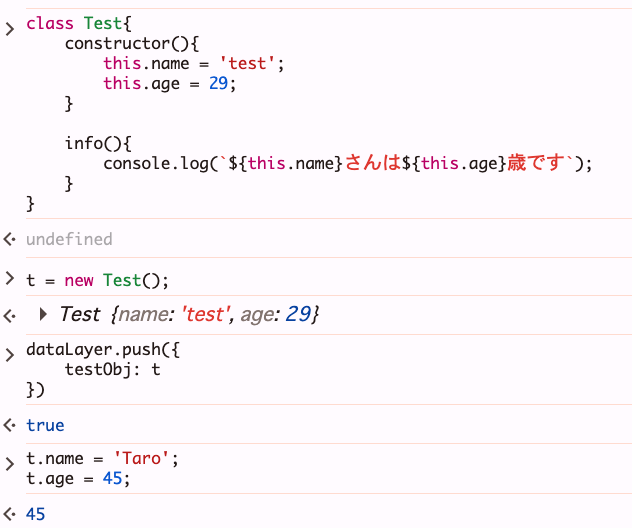
↓最初↓
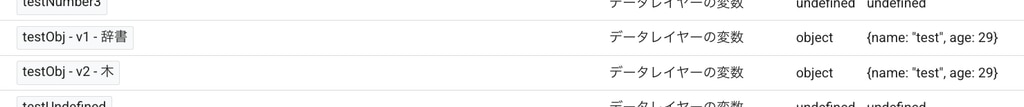
↓大元のインスタンスプロパティ変更後↓

というように辞書側も木側も値が変わっていますね。
また、gtag('set') や gtag('event') は処理時に素オブジェクト/配列をコピーするため、処理後に呼び出し元のオブジェクトを変更してもモデル側は追従しません。しかし、こちらも Date・関数・正規表現・クラスインスタンスなどは、このコピーの対象ではありません。
さて、最初の表から分かるように、「両方(辞書側・木側)へ書くのは素オブジェクトだけ」ではありません。arguments 枝も、ハンドラの戻り値が合流点へ到達すれば両方へ書きます。ただし、arguments そのものを保存するわけではありません。コマンドを解釈したハンドラが作ったオブジェクトを保存します。
2-3. gtag(‘set’) は、合流しても通常のオブジェクト push と同じマージではない
gtag('set') について改めて見ていきましょう。
gtag('set') のハンドラはオブジェクトを返すので、素オブジェクトと同じ合流点へ進みます。
しかし同時に、overwriteModelFields のフラグを立てます。合流点はこのフラグを見ると、返された各キーについて次の順で処理します。
model.set(key, undefined); // そのキーをいったん消す
model.set(key, newValue);  // 新しい値を書く
「辞書側と木側の両方へ届く」と「通常のマージをする」は別の話です。次の違いは、配列で見ると明確です。
// 事前状態
dataLayer.push({ testArr: [1, 2, 3, 4, 5] });dataLayer.push({testArr:[9,10]}) の例
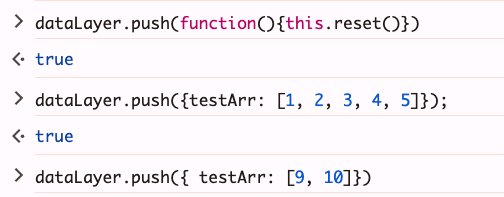

↓↓↓
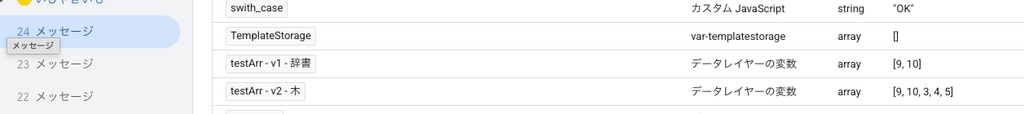
gtag('set','testArr',[9,10]) の例 ← 注目!
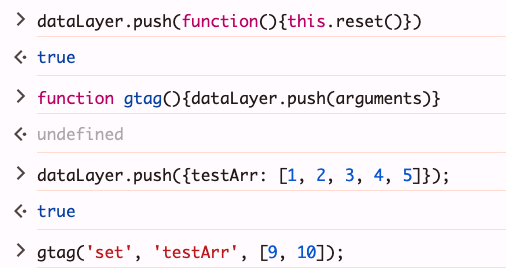

↓↓↓

dataLayer.push({testArr:[9,10], _clear: true}) の例
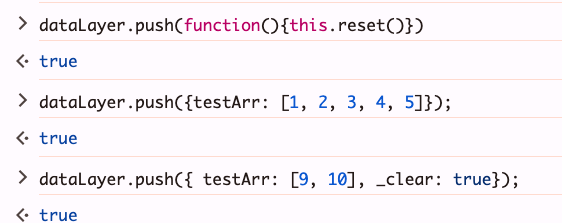

↓↓↓
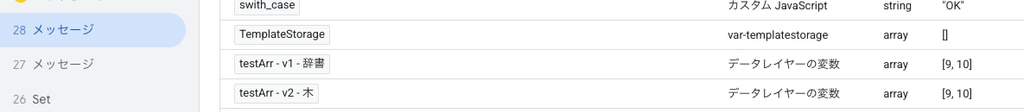
gtag('set') が消すのはデータモデル全体ではなく、ハンドラが返したオブジェクト直下のキーごとです。gtag('set', {a: 1, b: 2}) なら a と b をそれぞれ消してから書き、他のキーは残します。
2-4. 木側だけを変更する2つの set
次の2つは共通の合流点へ入りません。どちらも外部から呼び出せるモデル操作用の set() を使い、木側だけを変更します。
// ① dataLayer.set() の API
google_tag_manager[id].dataLayer.set('ecommerce', {...});

// ② 関数枝
dataLayer.push(function () {
  this.set('ecommerce', {...});
});
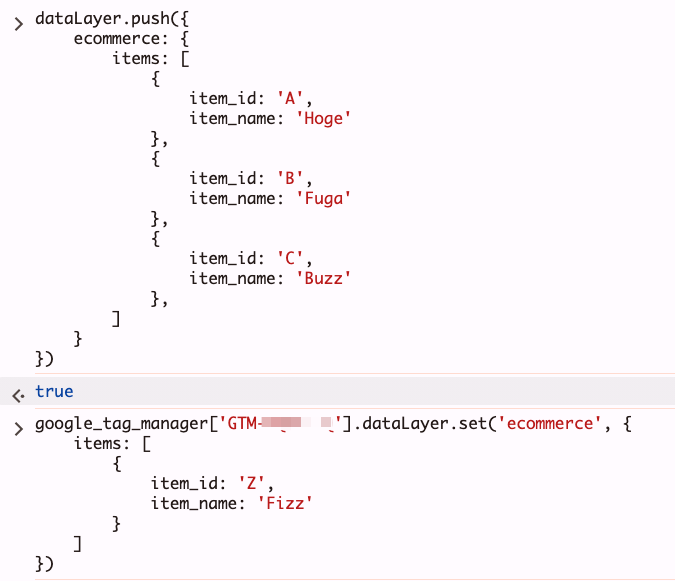
google_tag_manager[id].dataLayer.set('ecommerce', {...}); の例
dataLayer.push({
    ecommerce: {
        items: [
            {
                item_id: 'A',
                item_name: 'Hoge'
            },
            {
                item_id: 'B',
                item_name: 'Fuga'
            },
            {
                item_id: 'C',
                item_name: 'Buzz'
            },
        ]
    }
});

google_tag_manager['GTM-XXXXX'].dataLayer.set('ecommerce', {
    items: [
        {
            item_id: 'Z',
            item_name: 'Fizz'
        }
    ]
});
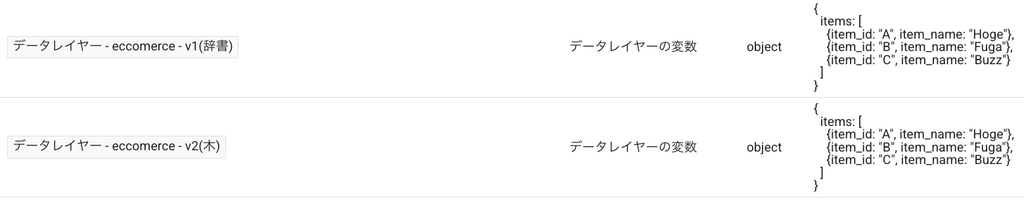
↓最初の dataLayer.push() のあと↓
↓google_tag_manager['GTM-XXXX'].dataLayer.set('ecommerce', {}) のあと↓
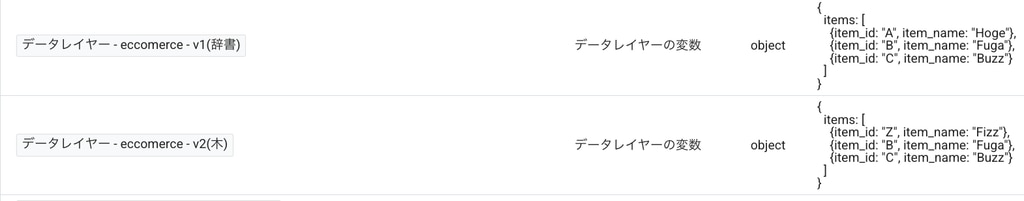
いかがでしょうか?
木側は変更されていますが、辞書側は影響されていません。
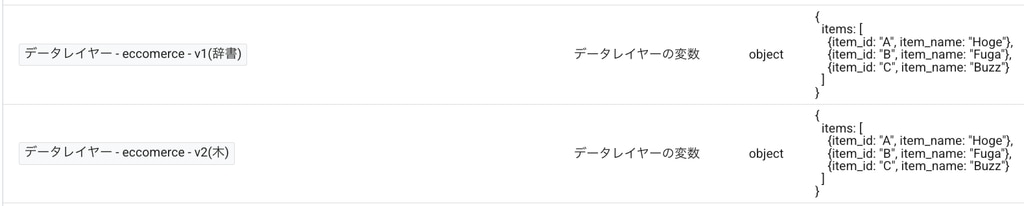
同様に、dataLayer.push(function () { this.set('ecommerce', {...}); }); の例も見ましょう。
dataLayer.push({
    ecommerce: {
        items: [
            {
                item_id: 'A',
                item_name: 'Hoge'
            },
            {
                item_id: 'B',
                item_name: 'Fuga'
            },
            {
                item_id: 'C',
                item_name: 'Buzz'
            },
        ]
    }
});

dataLayer.push(function(){this.set('ecommerce', {
    items: [
        {
            item_id: 'Y',
            item_name: 'Foo'
        }
    ]
})});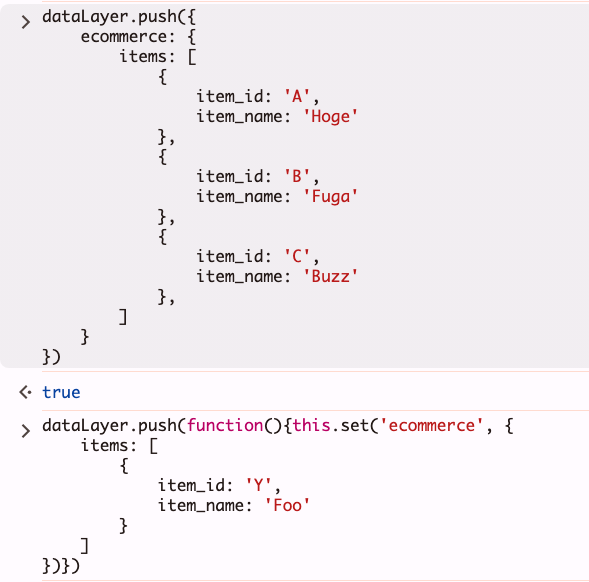
この push を処理した各タグスクリプトで関数が実行され、木側モデルが書き換わります。
↓最初の dataLayer.push() のあと↓
↓dataLayer.push(function(){this.set('ecommerce', {})}) のあと↓
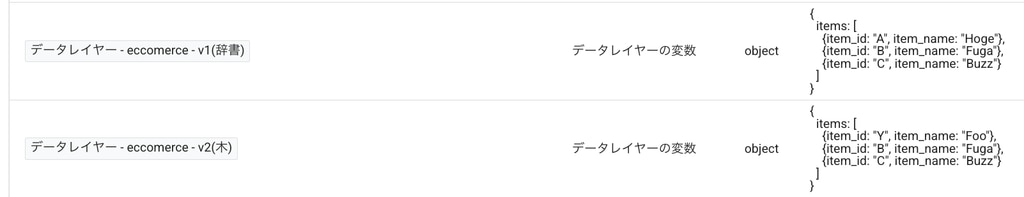
いかがでしょうか?木側だけが変更されて、辞書側は変わっていませんね。
このように、2つの set() の呼び方は木側だけを変更します。
配列ドットコマンドも、木側にある配列のメソッドを直接呼ぶため、辞書側には届きません。
では、2つの置き場の値がずれた状態でタグが動くと、どちらが使われるのでしょうか?
3. 見る経路によって、使われる値が変わる
例えば、eコマースで実際に起きることを整理してみましょう。
// ① オブジェクトで push(両方に入る)
dataLayer.push({ event: 'view_item', ecommerce: { items: [商品A] } });

// ② 配列ドットコマンドで商品を足す(木側にしか入らない)
dataLayer.push(['ecommerce.items.push', 商品B]);
このあと、見る経路によって答えが変わります。
GTMプレビュー【木側】                         → items は [商品A, 商品B]   ← 足せている

{{ecommerce}}(バージョン2)【木側】              → items は [商品A, 商品B]   ← 足せている

{{ecommerce}}(バージョン1)【辞書側】            → items は [商品A]          ← 商品B が無い

イベント処理の開始時に取り出された ecommerce【辞書側由来】 → items は [商品A] ← 商品B が無い木側を見るGTMプレビューやバージョン2のデータレイヤー変数では、商品Bは足せているように見えます。
一方、辞書側を見るバージョン1のデータレイヤー変数などは商品Bがありません。
②の書き方が木側にしか届かないためです。
「変数では正しいのに、別の経路では違う」という形で出るので、変数の設定を疑っても原因にたどりつけません。
3-1. GA4イベントタグのeコマース例
GTMのGA4イベントタグでeコマース設定をする際、「eコマースデータを送信」で「データソース」として Data Layer を指定したとき、タグは次の順序で処理をします。
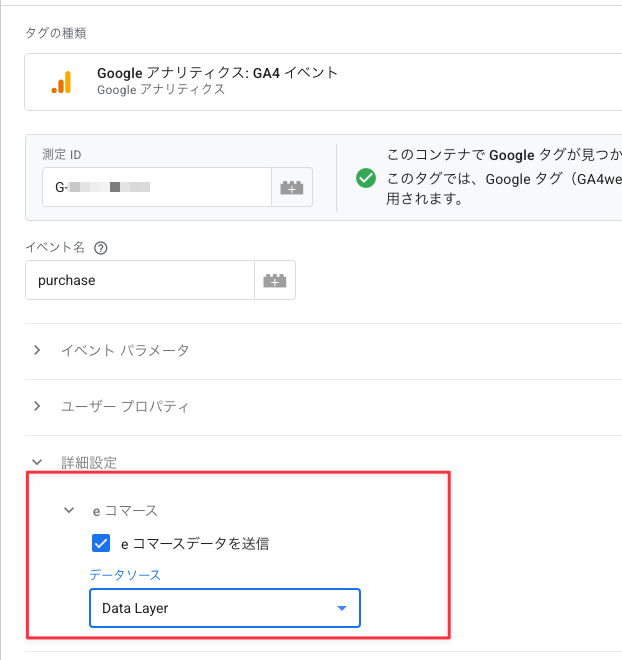
const ecommerceData =
  getEventData('eventModel') ||
copyFromDataLayerCache('ecommerce');ざっくり説明ですが、gtag('event') から作られたイベントでは、基本的に左側の getEventData('eventModel') が使われます。通常の dataLayer.push({event: ...}) から作られ、eventModel を持たないイベントでは、右側の copyFromDataLayerCache('ecommerce') が使われます。
ここで優先される eventModel は木側でも辞書側でもなく、タグ実行時点のモデルを改めて読む値でもありません。そのイベントの処理開始時に保持されたメッセージデータです。
gtag('event') を直書きで呼ぶと、そのイベント専用の eventModel というオブジェクトが作られます。
例えば次のコードが呼ばれると・・・
gtag('event', 'view_item', { items: [
        {
            item_id: 'A',
            item_name: 'Hoge'
        }
    ]
})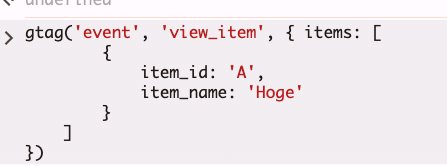
このように、GTMプレビュー上でも eventModel オブジェクトを確認できます。
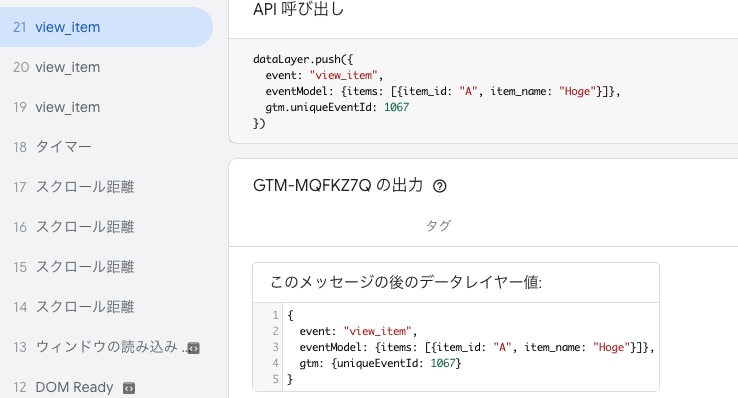
また、上のスクショから分かるように、view_item というイベントも発生しています。
そのため、view_item をトリガーにしたGA4イベントタグで、データソースに Data Layer を指定すると、この eventModel の値が使われます。
実際このようなリクエストが飛んでいます。
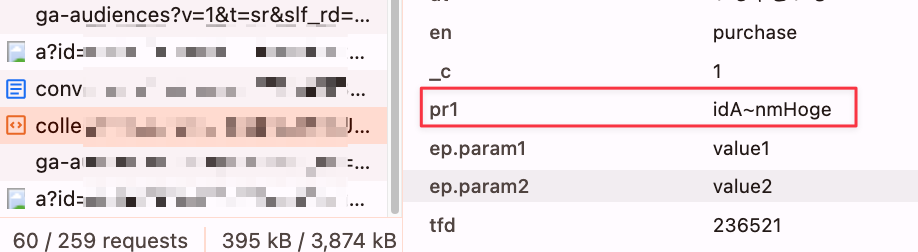
では、右側の copyFromDataLayerCache('ecommerce') は何を読むのでしょうか。
これは、このGA4イベントタグのイベント処理が始まった時点で、辞書側から取り出された ecommerce オブジェクトです。
辞書側の値というのがミソですね。
実際の例を見てみましょう。
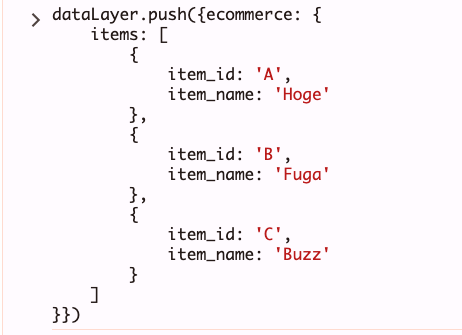
まず、準備として次の dataLayer.push() をします。
dataLayer.push({ecommerce: {
    items: [
        {
            item_id: 'A',
            item_name: 'Hoge'
        },
        {
            item_id: 'B',
            item_name: 'Fuga'
        },
        {
            item_id: 'C',
            item_name: 'Buzz'
        }
    ]
}})
この時点でのデータレイヤーの値はこうです。
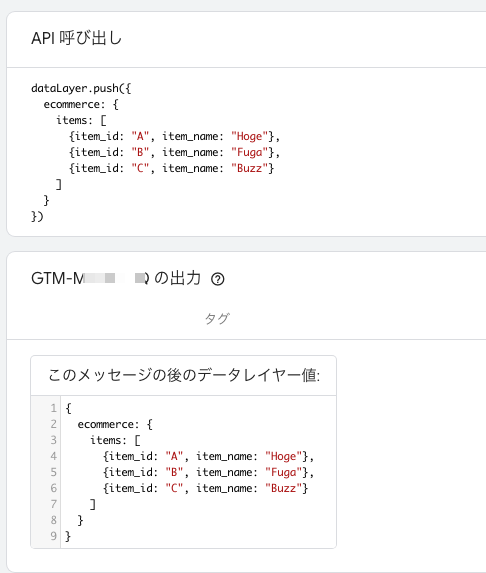
木側も辞書側もこの値です。
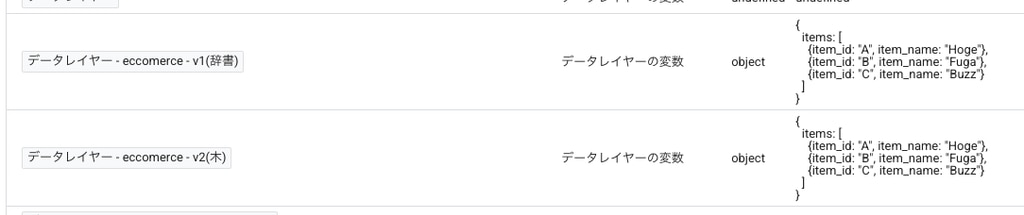
ではここで、先ほど「木側しか変更しない」と書いた処理を試してみましょう。
大きく分けて3種類です。
// ① 配列枝のメソッドで渡す
dataLayer.push(['ecommerce.items.push', {item_id: 'Z', item_name: 'Fizz'}]);


// ② dataLayer.set の API を使う
google_tag_manager[id].dataLayer.set('ecommerce.items', [{item_id: 'Z', item_name: 'Fizz'}]);


// ③ 関数枝を使う
dataLayer.push(function(){this.set('ecommerce.items', [{item_id: 'Z', item_name: 'Fizz'}])});
それぞれ見てみます。
配列枝で Array.prototype.push() を呼ぶ
dataLayer.push(['ecommerce.items.push', {item_id: 'Z', item_name: 'Fizz'}]);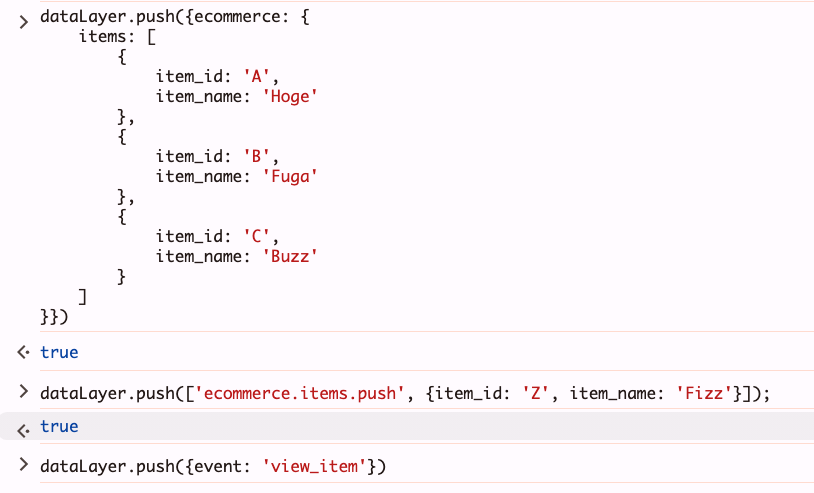
GTMのプレビューは次のように push されています。
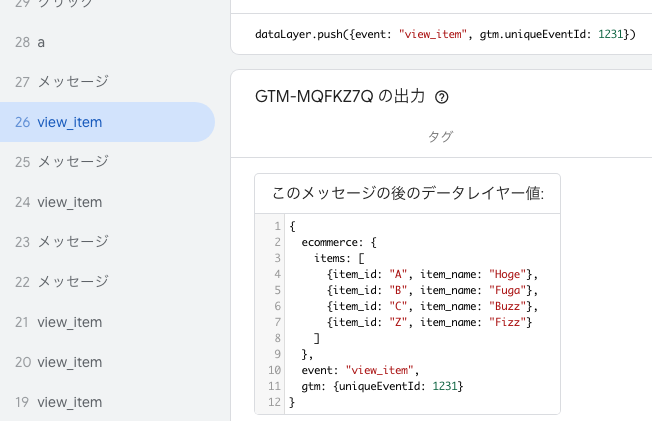
※ここで dataLayer.push([...]) 自体は配列枝へ入るための窓口です。その枝の中で、木側の ecommerce.items が持つ通常の Array.prototype.push() が呼ばれます。対象配列の末尾へ要素を追加するだけで、この変更時にデータモデルの再帰マージは行われません。
データレイヤーを見てみると、木側は変更されていますが、辞書側に変更はありませんね。
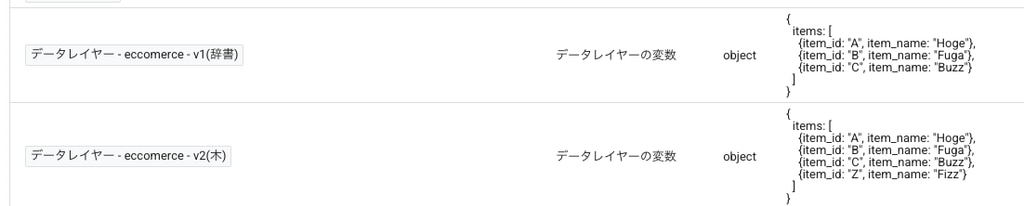
view_item で発火させた GA4イベントのリクエストを見ると、items は3商品だけです。
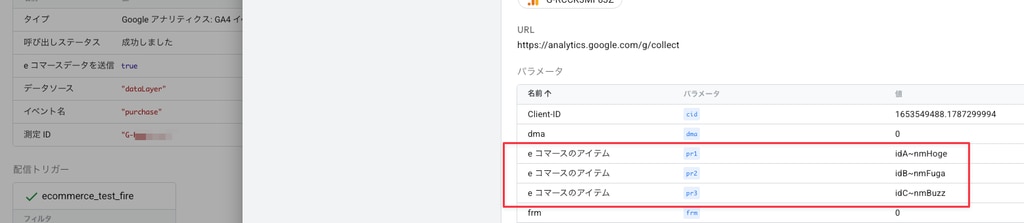
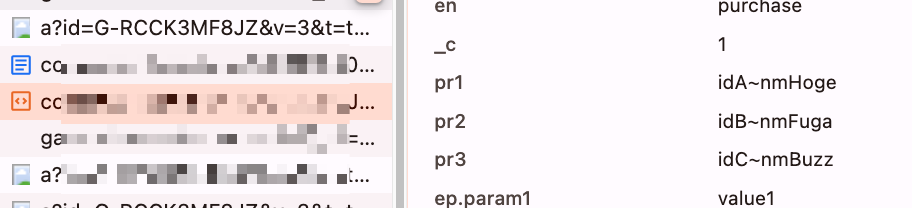
木側の値ではなく、辞書側の値が使われているのが分かりますね。
ID指定の set() で木側を更新する
google_tag_manager[id].dataLayer.set('ecommerce.items', [{item_id: 'Z', item_name: 'Fizz'}]);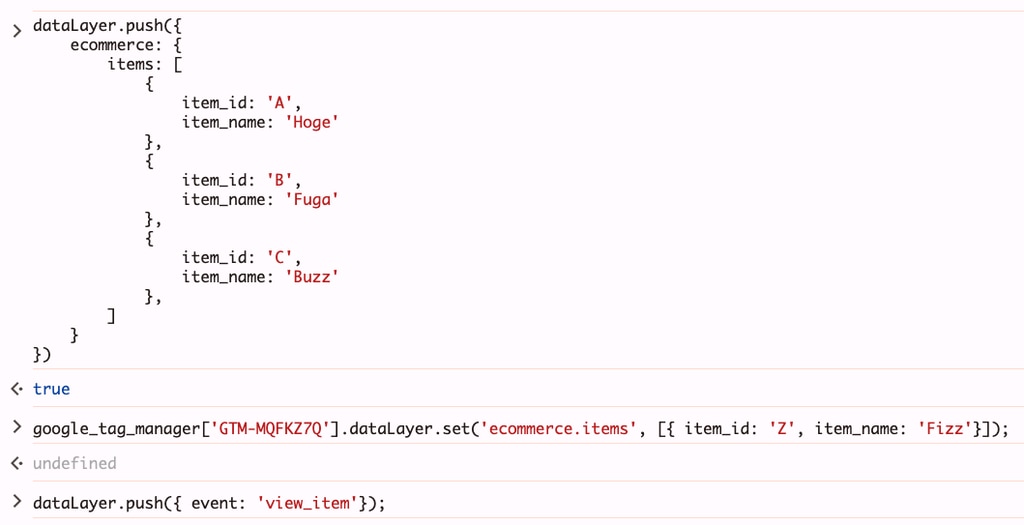
GTMプレビューのデータレイヤーは次のように先頭に Z がマージされています。
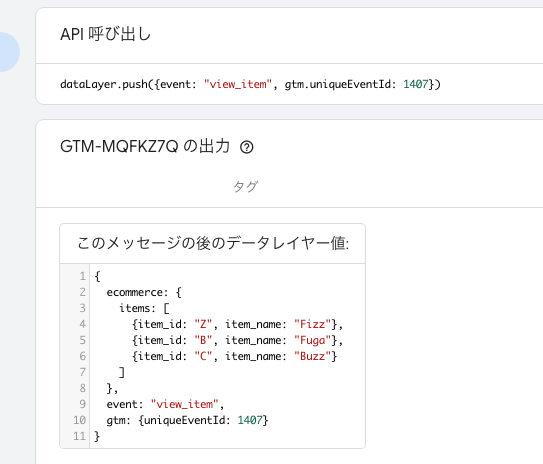
データレイヤー変数のバージョン2(木側)は変更されていますが、バージョン1(辞書側)は変わっていません。
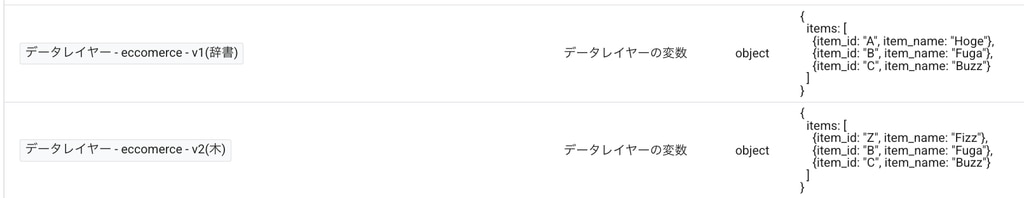
では、実際のGA4リクエストがどうなっているかというと・・・
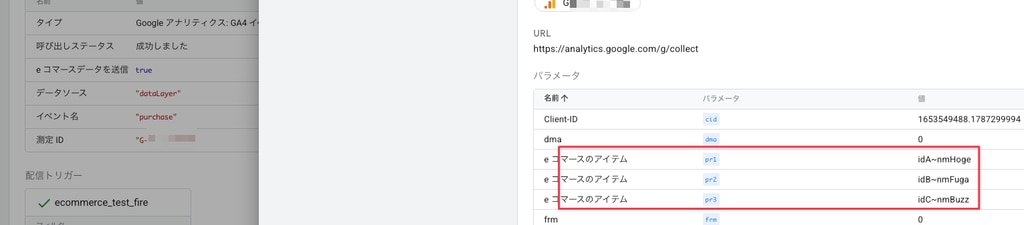
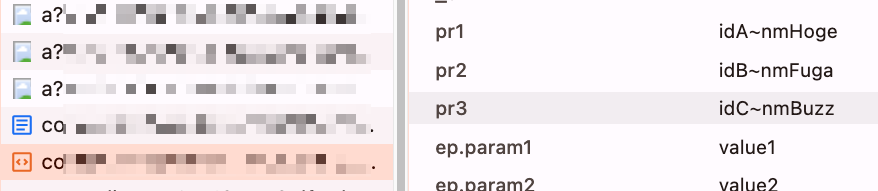
はい、items として A, B, C の3商品が送られていますね。(Z は送られていない)
つまり、これも木側を見ているのではなく、辞書側の値を見ている、ということになります。
関数枝の this.set() で木側を更新する
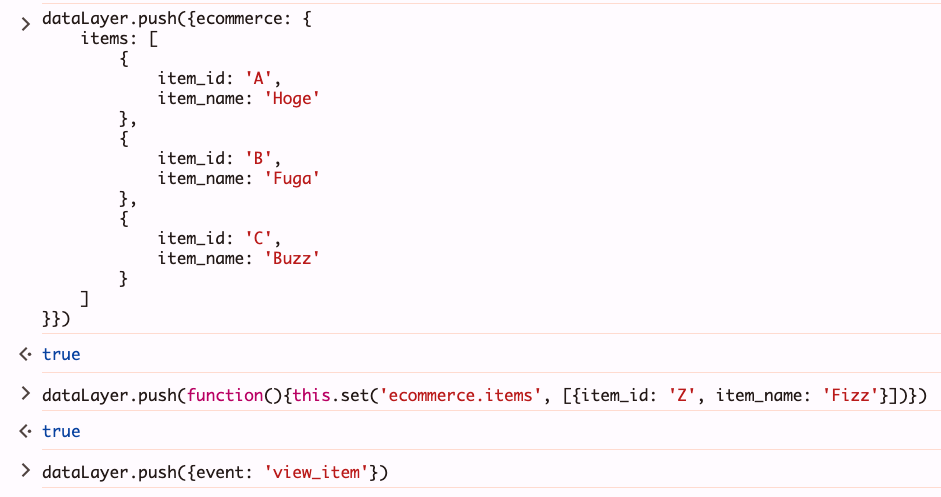
dataLayer.push(function(){
  this.set('ecommerce.items', [{item_id: 'Z', item_name: 'Fizz'}]);
});
GTMプレビューのデータレイヤーは次のように先頭に Z がマージされています。
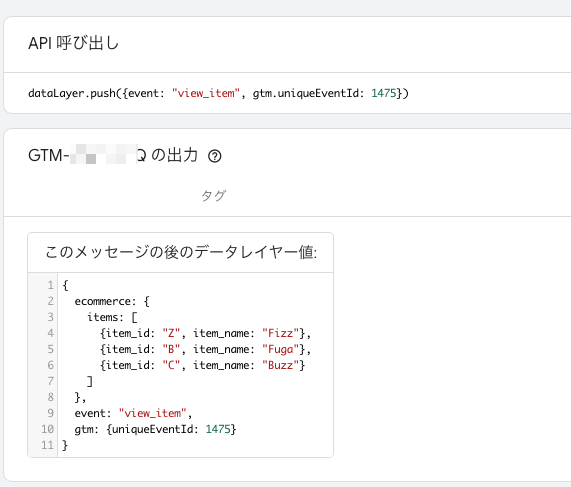
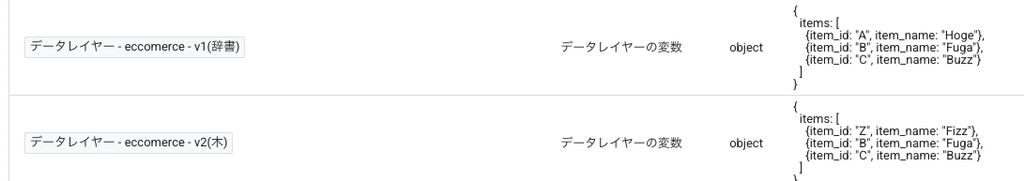
データレイヤー変数のバージョン2(木側)は変更されていますが、バージョン1(辞書側)は変わっていません。
実際のGA4リクエストは・・・

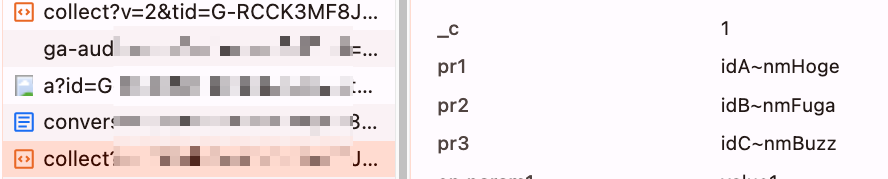
やはり、A, B, C の3商品であり、Z は items の中には入っていません。
よって、ここからも辞書側の値が使われていることが分かります。
3つとも、GTMプレビュー上の木側は変わっても、実際にGA4へ送信された items は変更された商品ではありませんでした。なぜなら、GA4イベントタグは辞書側のデータを参照しているのに、辞書側のデータは書き換わっていなかったからですね。
ただし、これはあくまでも「データソース= Data Layer 」を選んだ場合の話です。
データソースに変数を直接指定する構成にすれば、話は変わります。
例えば、変数としてバージョン2のデータレイヤー変数で取得した ecommerce を指定すれば、木側の値が使われます。
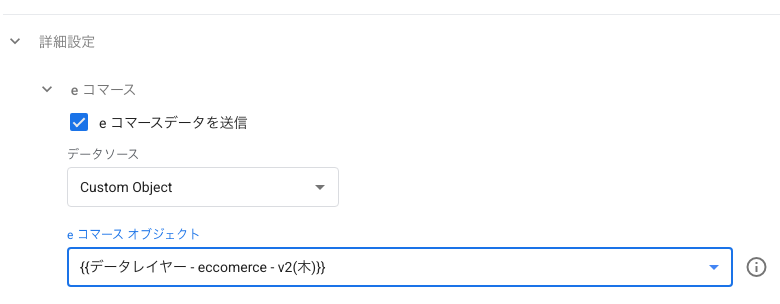
{{ecommerce}} というデータレイヤー変数を作って指定している構成は珍しくありません。
その場合、木側の値がそのままタグに渡ります。
4章の「短い配列で上書きすると前の商品が残る」が、そのまま送信内容に出る構成です。
つまり、GTMのGA4イベントタグでどちらの値が使われるかは、タグのデータソース設定で決まります。
実装は同じなのに片方の環境だけ「商品が混ざる」「商品が変更されない」ということが起きます。
自分の構成がどちらなのかは、タグの設定画面で確認してください。
4. 木側では、なぜ上書きしたはずの配列が短くならないのか?
1-3では、通常のオブジェクトとして短い配列を dataLayer.push() しても、木側では古い要素が残る結果を確認しました。ここでは、その理由を木側の再帰マージの規則から整理します。
以下は、_clear のない通常のオブジェクト push など、対象キーを消さずに木側へ再帰マージする経路の話です。
木側の処理は、たったこれだけの規則で動いています。(既存の値と新しい値が同じ種類のときに限る。種類が違えば置き換え→ 1-3)
『新しく来た値の中にあるキーだけを、古い値の上に書き込む。新しい値に無いキーは、そのまま残す。』
オブジェクトなら直感通りです。
dataLayer.push({ testObj: { a: 1 } });
dataLayer.push({ testObj: { b: 2 } });
// 辞書側 : { b: 2 }          丸ごと差し替わる
// 木側   : { a: 1, b: 2 }    a は「新しい値に無いキー」なので残る。b が追加される形。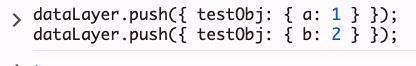

問題は、この処理が配列をオブジェクトと同じように扱うことです。
処理から見れば ["X"] は「0 というキーに X が入ったもの」でしかありません。だから商品の配列でこうなります。
dataLayer.push({ ecommerce: { items: ['商品A', '商品B', '商品C'] } });   // キー 0,1,2
dataLayer.push({ ecommerce: { items: ['商品X'] } });                 // キー 0 だけ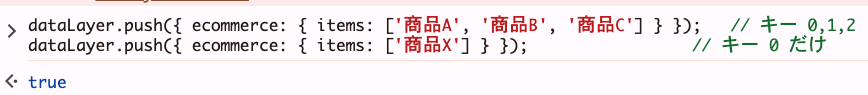

こうして木側は [商品X, 商品B, 商品C] になります。
この通常マージの経路には、長さを短くする処理がありません。 既存の配列も作り直されず、そのまま使い回されます。
「累積するから」ではなく、「新しい配列の添字ぶんしか上書きされないから」が理由です。
そのため、通常のオブジェクト push では、古い配列より短い配列を書いたときにこの現象が表面化します。
この例のように文字列を並べた配列では、同じ長さか、より長い配列で上書きすると、古い要素は残りません。
ただし、eコマースの items のように各要素が素オブジェクトの場合は、同じ位置にあるオブジェクトの中身もマージされます。そのため、配列が同じ長さでも、新しい値に含まれていない、前の商品の項目が残ることがあります。
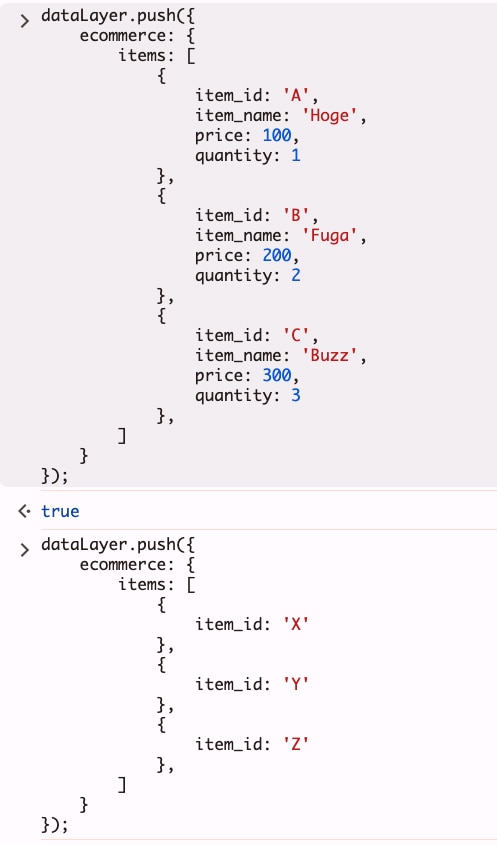
例えば、最初に以下の items を push して
dataLayer.push({
    ecommerce: {
        items: [
            {
                item_id: 'A',
                item_name: 'Hoge',
                price: 100,
                quantity: 1
            },
            {
                item_id: 'B',
                item_name: 'Fuga',
                price: 200,
                quantity: 2
            },
            {
                item_id: 'C',
                item_name: 'Buzz',
                price: 300,
                quantity: 3
            },
        ]
    }
});次に、item_id だけを記載した items を push してみます。配列の長さは同じです。
dataLayer.push({
    ecommerce: {
        items: [
            {
                item_id: 'X'
            },
            {
                item_id: 'Y'
            },
            {
                item_id: 'Z'
            },
        ]
    }
});
このとき、データはどうなっているでしょうか?
↓最初の push のあと↓
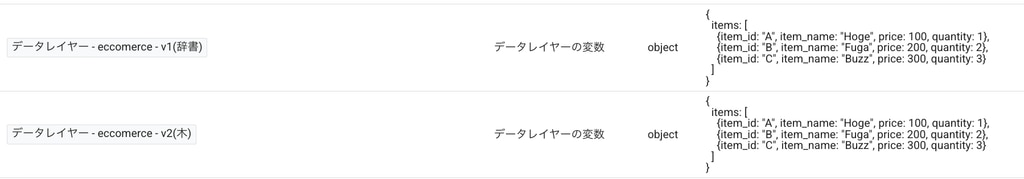
↓2回目の item_id のみの push のあと↓
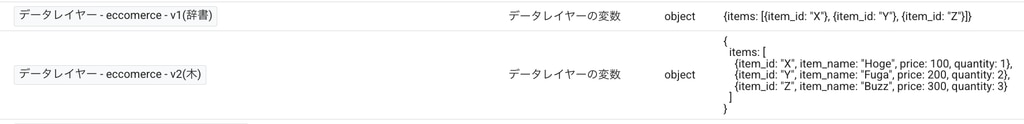
いかがでしょうか?
辞書側は 1-3 で見たように、最後に push された値「そのもの」を持つので違和感ないですが、木側の値をよく見てください。
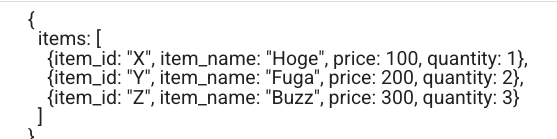
item_id だけが更新されていて、item_name など他の要素は初回 push の値がそのまま残っていますね?
これが「オブジェクトの中身もマージされる」という意味です。
さて、消し方も、この規則から導けます。
間に「配列でもオブジェクトでもない値」を挟めば、次の書き込みで入れ物が作り直されます。
// ① null を挟む
dataLayer.push({ ecommerce: null });
dataLayer.push({ ecommerce: { items: ['商品X'] } });   // → ['商品X']

// ② _clear を付ける(各キーへ undefined を書いてから新しい値を書く。①と結果は似るが、仕組みは別)
dataLayer.push({ ecommerce: { items: ['商品X'] }, _clear: true }); // → ['商品X']どちらも辞書側と木側の両方に効きます。_clear は同じ push に含まれる、_clear 以外の全キーへ「消してから書く」を適用します。
5. 実務ではどう書けばよいか
ecommerceのようにタグへ渡す値は、オブジェクトをdataLayer.push()して入れる。 配列ドットコマンドや、木側だけを変更するthis.set()/google_tag_manager[id].dataLayer.set()で後から足さない。
- イベントごとに前の値を残したくない場合は、先に
ecommerce: nullを入れるか、_clear: trueで対象キーを消してから書く。
- GTMプレビューだけで判断しない。 データレイヤー変数のバージョン、GA4イベントタグのデータソース設定、実際のリクエストを合わせて確認する。
6. 第4回とシリーズ全体のまとめ
内部モデルには、親子関係を持つ木側と、書かれたキーをそのまま持つ辞書側があります。
GTMプレビューのデータレイヤーの値やバージョン2のデータレイヤー変数は木側を読み、バージョン1は辞書側のキーを読みます。そのため、同じ push でも、値の結合や部分パス、削除の見え方が一致しません。
通常のオブジェクト push で短い配列へ更新すると、木側では新しい添字ぶんだけが更新され、余った古い添字が残ることがあります。
対象キーへ先に null を入れるか、その push で _clear: true を使えば、消してから書けます。gtag('set') のモデル側も内部の上書き指定によって消してから書くため、同じ残り方にはなりません。
GTMのGA4イベントタグでどちらの値が使われるかは、データソース設定でも変わります。GTMプレビューだけで判断せず、変数のバージョン、タグの設定、実際のリクエストを一組で確認してみましょう。
この全4回で追ってきたのは、dataLayer.push() という1行の裏で、引数の型分岐、コマンドの解釈、モデルへの書き込み、タグに渡す値の読み出し、計測送信が別々の段階として動いている、ということです。
window.dataLayer に値が残っている、GTMプレビューで正しく見える、変数から期待した値が取れる。それだけでは、最終的にGA4へ同じ値が送られた証拠にはなりません。
挙動がかみ合わないときは、何を push したか、どの枝を通ったか、どちらの置き場を書き換えたか、タグがどの経路から読んだか、実際のリクエストに何が入ったかの順に切り分けて見ると、原因を追いやすくなります。
以上で、全4回のdataLayer深掘りシリーズは終了です。
それでは、Bye, bye.